
استخدمت OpenAI أكثر من 100,000 ألف وحدة معالجة رسومية (GPU) في بنيتها التحتية Stargate بولاية تكساس، في أكبر عملية تدريب لها حتى الآن. الجميع يُجري اختبارات الأداء على GPT-6 Astra، لكن قلةً فقط تتساءل عن نوع الشبكة اللازمة لربط مجموعة وحدات معالجة رسومية بهذا الحجم الهائل.
إن الإجابة أكثر تعقيداً من مجرد القول "100,000 وحدة معالجة رسومية تساوي 100,000 وحدة بصرية 800G".
عدد وحدات معالجة الرسومات (GPU) مُعلن. أما المزيج الدقيق للأجهزة وقائمة مكونات البصريات فليست كذلك.
لفهم ما قد تتطلبه البنية التحتية للذكاء الاصطناعي على نطاق Astra من الوصلات البصرية، نحتاج إلى فصل ما كشفته OpenAI و NVIDIA بالفعل عما يمكن حسابه باستخدام البنى المرجعية لـ NVIDIA و Cisco.
100,000 وحدة معالجة رسومية — وليس 100,000 نظام
أطلقت OpenAI يوم الخميس الماضي نموذج GPT-6 Astra. وبعد بضعة أيام، نشر جينسن هوانغ، الرئيس التنفيذي لشركة NVIDIA، منشورًا حول الإطلاق، وكتب أن Astra قد تم تدريبه على ما يقرب من 100 ألف وحدة معالجة رسومية NVIDIA Grace Blackwell NVLink72، وأن 400,000 ألف وحدة معالجة رسومية أخرى ستدخل الخدمة قريبًا.
وقد أدى هذا التعبير إلى بعض الارتباك لأن "NVL72" يصف نظامًا على مستوى الرف يحتوي على 72 وحدة معالجة رسومات من بلاكويل، وليس وحدة معالجة رسومات فردية.
يقدم التقرير الموجز الصادر عن OpenAI الإجابة الأكثر وضوحاً.
قال إيدان كلارك، نائب رئيس قسم الأبحاث في OpenAI، للصحفيين إن Astra يمثل أكبر عملية تدريب للشركة حتى الآن، ويمثل المرة الأولى التي تقوم فيها OpenAI بتدريب نموذج مسبقًا على أكثر من 100,000 وحدة معالجة رسومية في موقع Stargate التابع لها في تكساس.
لذا ينبغي تفسير رقم العنوان على النحو التالي:
أكثر من 100,000 وحدة معالجة رسومية (GPU) - وليس 100,000 رف NVL72.
إذا تم تعيين جميع وحدات معالجة الرسومات البالغ عددها 100,000 وحدة على أنظمة NVL72 كاملة العدد تحتوي على 72 وحدة معالجة رسومات، فسيكون المكافئ النظري كما يلي:
100,000 ÷ 72 ≈ 1,389 رف NVL72
أو ما يقارب 1,400 رف كامل من نوع NVL72.
ينبغي التعامل مع ذلك على أنه حساب مكافئ للرفوف، وليس عددًا فعليًا مؤكدًا للرفوف. لم تكشف OpenAI علنًا عن التركيبة الدقيقة لأنظمة GB200 أو GB300 أو غيرها من أنظمة Grace Blackwell المستخدمة في مجموعة تدريب Astra.
مقياس تدريب أسترا
| متري | المقياس التقريبي |
| وحدات معالجة الرسومات المستخدمة في التدريب المسبق لـ Astra | 100,000+ |
| ما يعادل رف NVL72 كامل | ~ 1,400 |
| وحدات معالجة الرسومات لكل رف NVL72 | 72 |
| وحدات معالجة الرسومات الإضافية التي أشار إليها جنسن هوانغ | 400,000 |
الشكل 1. تكوين رف NVIDIA NVL72
يحتوي رف NVL72 كامل على 72 وحدة معالجة رسومية من نوع Blackwell متصلة عبر NVIDIA NVLink. لم يتم الكشف عن بنية نشر Astra الدقيقة علنًا، لذا يجب اعتبار العدد التقريبي البالغ 1,400 رف بمثابة تقدير تقريبي وليس جردًا مؤكدًا للموقع.
داخل الحامل - لا توجد وحدات بصرية في نسيج NVLink
قد يبدو هذا غير منطقي، ولكنه أحد أهم الفروقات في البنية التحتية للذكاء الاصطناعي على مستوى الرفوف.
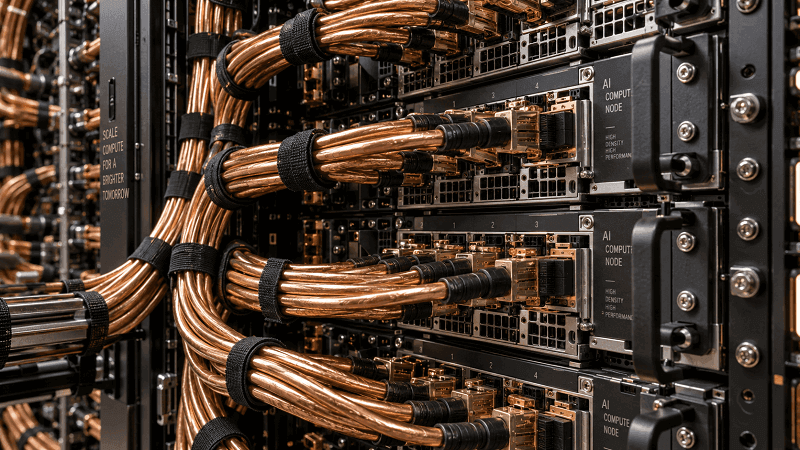
داخل أنظمة NVIDIA GB200 و GB300 NVL72، تتواصل وحدات معالجة الرسومات الـ 72 من خلال نسيج NVIDIA NVLink باستخدام مفاتيح NVLink ولوحة خلفية من كابل نحاسي سلبي.
لا يتطلب نطاق NVLink من وحدة معالجة الرسومات إلى وحدة معالجة الرسومات نفسها أجهزة إرسال واستقبال ضوئية قابلة للتوصيل.
لا يعني ذلك أن رف NVL72 لا يحتوي على وحدات بصرية في أي مكان. يمكن تركيب أجهزة الإرسال والاستقبال البصرية في واجهات شبكة ConnectX أو BlueField المستخدمة لتوصيل الرف بشبكات الحوسبة والتخزين والإدارة الخارجية.
الفرق هو:
نسيج توسيع نطاق NVLink داخل الرف: نحاسي
بنية الحوسبة القابلة للتوسع بين الخوادم: واجهات شبكة عالية السرعة قد تستخدم أجهزة إرسال واستقبال ضوئية
يُعد استخدام النحاس منطقياً للمسافات القصيرة داخل الرف لأنه يتجنب التحويل غير الضروري من الكهرباء إلى الضوء، مع توفير نطاق ترددي عالٍ للغاية وطاقة منخفضة نسبياً للاتصالات قصيرة المدى.
بمجرد أن يتعين على حركة البيانات مغادرة الرف والتنقل عبر مجموعة الذكاء الاصطناعي الأكبر، يصبح الاتصال البصري ذا أهمية متزايدة لأن الألياف تدعم مدى أطول وكثافة منافذ عالية وطوبولوجيا شبكة واسعة النطاق بكفاءة أكبر.
الحدود التي تهم
توسيع نطاق وحدة معالجة الرسومات داخل الرف: NVLink عبر البنية التحتية النحاسية السلبية.
توسيع نطاق وحدة معالجة الرسومات بين الرفوف: واجهات شبكة ConnectX المتصلة عبر InfiniBand أو Ethernet، وعادةً ما تستخدم روابط بصرية عالية السرعة في عمليات النشر الكبيرة.
يُعدّ هذا الحدّ مهماً اليوم، لكن لا ينبغي اعتباره نهائياً. فتقنيات مثل البصريات المدمجة، والبصريات القريبة من العبوة، ووحدات الإدخال/الإخراج الضوئية، قد تُقرّب الاتصال الضوئي في نهاية المطاف من وحدة المعالجة المركزية.
خارج الحامل - منفذ شبكة واحد تقريبًا لكل وحدة معالجة رسومية
هذا هو المكان الذي تأتي منه فكرة "وحدة معالجة رسومات واحدة، ووحدة بصرية واحدة" الأصلية، ولكن هناك فرقًا مهمًا بين الأجيال.
GB200 NVL72: 400 جيجابايت لكل وحدة معالجة رسومات
تحتوي بنية NVIDIA DGX GB200 NVL72 على 18 وحدة حسابية.
تحتوي كل صينية على:
- 4 وحدة معالجة رسومية من بلاكويل
- 4 بطاقات شبكة NVIDIA ConnectX-7
- تدعم كل واجهة ConnectX-7 اتصالاً بشبكة الحوسبة بسرعة 400 جيجابت/ثانية
وهذا يعطي الرف:
72 وحدة معالجة رسومية ← 72 منفذ شبكة حوسبة ConnectX-7 بسرعة 400 جيجابت
في التنفيذ البصري لنسيج الحوسبة، يتوافق هذا تقريبًا مع جهاز إرسال واستقبال بصري واحد من جانب العقدة بسرعة 400 جيجابت لكل وحدة معالجة رسومية.
GB300 NVL72: 800 جيجابايت لكل وحدة معالجة رسومات
يُغيّر الجيل الأحدث GB300 NVL72 طبقة الشبكات.
تحتوي كل وحدة معالجة رسومية GB300 على أربعة محولات شبكة ConnectX-8 لوحدات معالجة الرسوميات الأربعة الخاصة بها.
يدعم كل منفذ من منافذ ConnectX-8 سرعة 800 جيجابت/ثانية ويمكن تهيئته على النحو التالي:
1 × 800 غرام → 2 × 400 غرام
يمكن بعد ذلك توصيل وصلتي 400G بشبكتي حوسبة منفصلتين.
وهذا يعطي:
72 وحدة معالجة رسومية ← 72 منفذ مضيف ConnectX-8 800G
وفي بنية سيسكو المرجعية البصرية:
72 وحدة معالجة رسومية → 72 وحدة بصرية ثنائية المنفذ بسرعة 800 جيجابت في الثانية مثبتة على جانب العقدة
مقارنة بين GB200 و GB300 في مجال الشبكات
| معمار | محول شبكة وحدة معالجة الرسومات | سرعة منفذ المضيف | بنية بصرية مرجعية |
| GB200 NVL72 | برنامج ConnectX-7 | 400غ | بصري واحد بسرعة 400 جيجابت تقريبًا لكل وحدة معالجة رسومية |
| GB300 NVL72 | برنامج ConnectX-8 | 800غ | ~1 × منفذ بصري مزدوج 800G لكل وحدة معالجة رسومية |
| اختراق GB300 | برنامج ConnectX-8 | 2 × 400 جرام | مسار واحد بسعة 400 جيجابت لكل مستوى حسابي |
هذا التمييز مهم عند تقدير عدد أجهزة الإرسال والاستقبال الضوئية الموجودة خلف GPT-6 Astra.
أكدت شركة OpenAI وجود أكثر من 100,000 وحدة معالجة رسومية، لكنها لم تكشف علنًا عن المزيج الدقيق لوحدات GB200/GB300 أو قائمة مكونات الشبكة الكاملة.
وبالتالي، فإن الاستنتاج الذي يمكن الدفاع عنه من الناحية الفنية هو:
إذا تم توصيل أكثر من 100,000 وحدة معالجة رسومية (GPU) من Astra باستخدام أجهزة إرسال واستقبال ضوئية قابلة للتوصيل وفقًا لهياكل NVL72 المرجعية الحالية، فإن جانب العقدة وحده قد يتطلب ما يقارب 100,000 موضع وحدة ضوئية.
لكن لا ينبغي وصف تلك الوحدات تلقائيًا بأنها 800G.
إذا استخدم النشر شبكة من فئة GB200، فسيكون العديد من روابط جانب العقدة بسرعة 400 جيجابت في الثانية. أما إذا استخدم شبكة من فئة GB300، فيمكن أن تكون واجهات المضيف المقابلة منافذ ConnectX-8 بسرعة 800 جيجابت في الثانية.
يمكن أن تؤدي الكابلات الضوئية النشطة، أو وصلات النحاس ذات التوصيل المباشر، أو خيارات الشبكات فائقة التوسع المخصصة الأخرى إلى تغيير عدد أجهزة الإرسال والاستقبال المنفصلة.
الشكل 2. من رفوف NVL72 إلى واجهات الألياف الضوئية على جانب العقدة
يحتوي رف NVL72 كامل على 72 وحدة معالجة رسومية. شبكة التوسع الداخلي NVLink مصنوعة من النحاس. تحتوي كل وحدة معالجة رسومية على واجهة شبكة توسعية: 400 جيجابت/ثانية مع ConnectX-7 في GB200 أو 800 جيجابت/ثانية مع ConnectX-8 في GB300.
عبر ما يقرب من 100,000 وحدة معالجة رسومية، هذا يعني ما يقرب من 100,000 منفذ شبكة عالي السرعة على جانب العقدة - ولكن ليس بالضرورة 100,000 وحدة بصرية متطابقة بسرعة 800 جيجابت في الثانية.
عدد مرات التشغيل الفعلية أعلى
تُعدّ البصريات الموجودة على جانب العقدة جزءًا واحدًا فقط من شبكة الذكاء الاصطناعي الكبيرة.
تتطلب منافذ التبديل أيضًا واجهات بصرية، وتحتوي المجموعات الكبيرة على اتصالات إضافية من الورقة إلى العمود الفقري، وشبكات تخزين، وشبكات أمامية، وشبكات إدارة، واتصالات خادم الدعم.
تُسهّل بنية Cisco N9000 Enterprise Reference Architecture for GB300 NVL72 رؤية النطاق.
بالنسبة لنشر GB300 بأربعة رفوف و288 وحدة معالجة رسومية ، إليك قائمة مكونات Cisco الكاملة:
- 288 وحدة تبريد OSFPR-800G-DR8 بالنسبة لجانب العقدة
- 1,112 OSFP-800G-DR8 وحدات تبريد متكاملة في أماكن أخرى من الهندسة المعمارية
- أجهزة إرسال واستقبال ضوئية إضافية بسرعة 400 جيجابت و200 جيجابت و100 جيجابت للاتصال المتقارب والتخزين والدعم والإدارة
هذا لا يعني أن كل مجموعة من 100,000 وحدة معالجة رسومية ستستخدم نفس النسبة.
قد تستخدم شركات الحوسبة السحابية الضخمة بنى تبديل مختلفة، ونسب اكتظاظ مختلفة، ومدى وصول الألياف الضوئية، وأنواع الكابلات، وتصميمات التخزين، أو أجهزة الشبكات المخصصة.
ولكن الاتجاه واضح:
إن عدد وحدات معالجة الرسومات وحده يقلل بشكل كبير من العدد الإجمالي للواجهات البصرية المطلوبة لبناء مصنع للذكاء الاصطناعي.
الشكل 3. بنية بصرية مبسطة لـ GB300
يتناسب عدد الوحدات النمطية على جانب العقدة بشكل وثيق مع عدد وحدات معالجة الرسومات، بينما تتطلب الشبكة الكاملة بصريات إضافية عبر الألياف الورقية والعمود الفقري والمتقاربة والتخزين والإدارة.
بالنسبة لـ GB300، يمكن تحويل منفذ 800G إلى منفذين 400G.
تُقدّم بنية GB300 تفاصيل أخرى مهمة في مجال الشبكات.
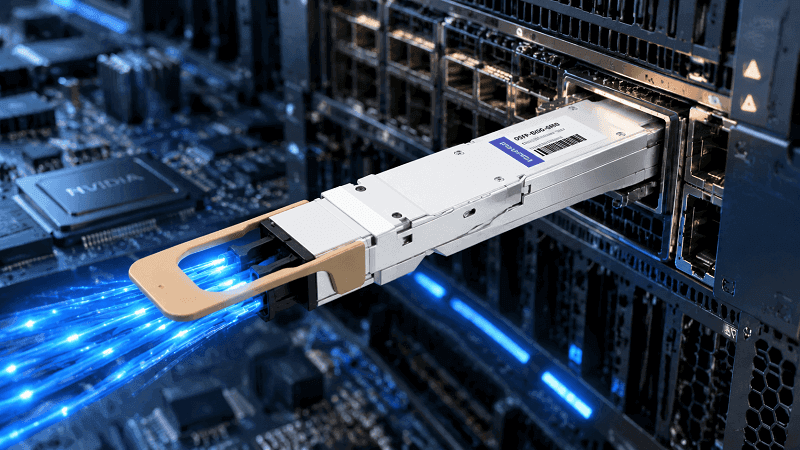
يمكن تقسيم منفذ المضيف ConnectX-8 بسرعة 800 جيجابت إلى:
اتصالان بسرعة 400 جيجابت/ثانية
تستخدم بنية NVL72 Enterprise Reference Architecture من NVIDIA هذين الاتصالين بسرعة 400 جيجابت عبر نسيج حسابي ثنائي المستوى.
يتصل مسار واحد بسرعة 400 جيجابت بالمستوى 1.
أما المسار الآخر بسرعة 400 جيجابت في الثانية فيتصل بالمستوى 2.
تستخدم كل طبقة بنية تبديل الأوراق الخاصة بها، مما يمنح نسيج الحوسبة مرونة إضافية، وتوازنًا في الأحمال، وعرض نطاق ترددي إجمالي.
لكن هناك فرقًا تقنيًا مهمًا.
لا تُعتبر مستويي الشبكة مستقلين تمامًا عن وحدة معالجة الرسومات وصولاً إلى الشبكة.
لا يزالون يتشاركون:
- غبو
- محول ConnectX-8
- منفذ المضيف 800G
- وعند استخدام منفذ بصري مزدوج، يكون جهاز الإرسال والاستقبال البصري على جانب المضيف
تنفصل المسارات عند دخولها إلى طبقات الكابلات والتحويل الخاصة بها.
لذا فإن الشبكات ثنائية المستوى تساعد في الحماية من الأعطال في مسارات التبديل الفردية ومستويات الشبكة، لكنها لا تقضي على كل نقطة فشل مشتركة.
ولهذا السبب فإن القول بأن المسارين يستخدمان "أجهزة إرسال واستقبال منفصلة بدون نقطة فشل مشتركة" سيكون غير دقيق.
يمكن وصف الهندسة المعمارية بشكل أفضل على النحو التالي:
واجهة مضيف واحدة بسرعة 800 جيجابت في الثانية ← مساران للشبكة بسرعة 400 جيجابت في الثانية ← مستويان للحوسبة
يوفر التصميم كلاً من عرض النطاق الترددي والمرونة.
في حال تعطل أحد مستويات الشبكة، قد يظل مسار البيانات متاحًا عبر المستوى الآخر، وذلك بحسب موقع العطل وآلية استعادة النظام البرمجية. قد ينخفض الأداء، وقد يؤثر تعطل بطاقة الشبكة المشتركة أو وحدة البصريات على جانب المضيف على كلا المسارين.
على نطاق 100,000 ألف وحدة معالجة رسومية، يصبح احتواء الأعطال بنفس أهمية عرض النطاق الترددي الخام تقريبًا. قد يتسبب عطل واحد في الأجهزة في بدء عمليات استعادة تتجاوز بكثير المكون المعطل.
الشكل 4. واجهة ConnectX-8 800G واحدة متصلة بمستويين 400G
يمكن لوحدة بصرية ثنائية المنافذ بسرعة 800 جيجابت في الثانية توفير وصلتين بسرعة 400 جيجابت في الثانية، واحدة لكل مستوى حسابي. يتم فصل مسارات المحول والكابل، لكن الوصلتين لا تزالان تشتركان في بطاقة الشبكة والوحدة البصرية على جانب وحدة معالجة الرسومات.
لماذا يُعد هذا المستوى من التكرار ضروريًا؟
لأن الإخفاقات على نطاق واسع تتوقف عن كونها أحداثاً استثنائية.
تصبح جزءًا من عملية المجموعة العادية.
تُعدّ عملية التدريب التي أجرتها شركة ميتا على برنامج Llama 3 405B واحدة من أفضل الأمثلة الموثقة علنًا.
تم تدريب نموذج Meta Llama 3 405B باستخدام 16,384 وحدة معالجة رسومية NVIDIA H100.
خلال فترة تدريب مسبق مدتها 54 يومًا، شهدت المجموعة ما يلي:
- 466 انقطاعًا إجماليًا في العمل
- 47 انقطاعًا مخططًا له
- 419 انقطاعًا غير متوقع
وهذا يعني حدوث انقطاع غير متوقع واحد تقريبًا كل 3.1 ساعة.
يُعد تحليل أسباب الفشل مفيداً بشكل خاص.
أفادت ميتا بما يلي:
- 148 انقطاعًا معيبًا لوحدة معالجة الرسومات
- 72 حالة فشل في ذاكرة HBM3
- 54 انقطاعًا بسبب أخطاء برمجية
- 35 انقطاعًا في محول الشبكة/الكابل
- 32 انقطاعًا غير مخطط له في صيانة المضيف
- 19 حالة فشل في ذاكرة SRAM لوحدة معالجة الرسومات
- 17 حالة فشل في معالج نظام وحدة معالجة الرسومات
- 7 انقطاعات متعلقة ببطاقة الشبكة
- عطلان فقط في وحدة المعالجة المركزية
وبالتالي تسببت محولات الشبكة والكابلات في 35 انقطاعًا، أو 8.4٪ من الانقطاعات غير المتوقعة.
هذا أمر جوهري، لكنه لم يكن أكبر فئة من فئات الفشل.
كانت المشاكل المتعلقة بوحدة معالجة الرسومات أكثر أهمية بكثير: فقد ذكرت شركة ميتا أن مشاكل وحدة معالجة الرسومات تمثل 58.7٪ من حالات الانقطاع غير المتوقعة.
لاما 3 405B — ما الذي تعطل فعلاً
| متري | نتيجة |
| لمحة تدريبية | 54 يوم |
| وحدات معالجة الرسومات | 16,384 هـ 100 |
| انقطاعات تامة | 466 |
| انقطاعات غير متوقعة | 419 |
| انقطاعات في محول الشبكة/الكابل | 35 |
| حصة الشبكة من الانقطاعات غير المتوقعة | 8.4% |
يبلغ عدد وحدات معالجة الرسومات المعلن عنها في GPT-6 Astra أكثر من ستة أضعاف حجم مجموعة Llama 3 405B.
ومع ذلك، سيكون من الخطأ ببساطة ضرب معدل فشل Meta في 6.1.
تستخدم أسترا جيلًا مختلفًا من الأجهزة، وبنية شبكية مختلفة، ومجموعة برامج مختلفة، وبيئة تشغيل مختلفة، ونظام إدارة الأعطال مختلف، وربما استراتيجيات مختلفة لنقاط التفتيش.
ما توضحه بيانات ميتا هو شيء أكثر عمومية:
مع ازدياد حجم مجموعات وحدات معالجة الرسومات المتزامنة، تزداد أهمية موثوقية المكونات والتعافي التلقائي من الأعطال.
قد يتمتع مكون واحد بموثوقية فردية ممتازة، بينما تحدث أعطال في مكان ما ضمن أسطول من المكونات المكونة من ستة أرقام بشكل منتظم.
ولهذا السبب تستثمر مجموعات الذكاء الاصطناعي الكبيرة بكثافة في:
- قياس بيانات الشبكة
- مراقبة صحة الروابط
- عزل الأخطاء تلقائيًا
- نقاط التفتيش
- استعادة سريعة للوظيفة
- مسارات الشبكة الزائدة
- الصيانة الوقائية
وقالت شركة OpenAI أيضاً إن الأجيال السابقة من نماذجها لعبت دوراً رئيسياً في عملية تدريب Astra.
تدعم التقارير العامة فكرة أن النماذج السابقة ساعدت أو أشرفت على أجزاء من عملية التدريب. ومع ذلك، لا توجد أدلة عامة كافية للاستنتاج بأن النماذج السابقة أصلحت أعطال الشبكة أو الأجهزة بشكل مستقل "في غضون ثوانٍ".
لا تزال النقطة الأوسع قائمة: تشغيل مجموعة وحدات معالجة الرسومات المكونة من ستة أرقام يتطلب أتمتة أكثر بكثير من مجرد تثبيت وحدات معالجة الرسومات وإطلاق مهمة تدريب.
أين توجد أجهزة الإرسال والاستقبال الضوئية فعلياً في مجموعة التدريب؟
لا يتم استخدام أجهزة الإرسال والاستقبال الضوئية للاتصال بين وحدات معالجة الرسومات ذات النطاق الترددي الأعلى داخل رف NVL72.
هذه المهمة من اختصاص شركة NVLink.
يقوم جهاز NVIDIA GB200 NVL72 بإنشاء نطاق NVLink مكون من 72 وحدة معالجة رسومات مع نطاق ترددي عالي للغاية واتصال منخفض الكمون داخل الحامل باستخدام محولات NVLink واتصال نحاسي سلبي.
يصبح الربط البصري بالغ الأهمية عندما يتعين على النظام التوسع إلى ما هو أبعد من رف واحد.
بالنسبة لـ GB200:
وحدة معالجة الرسومات → ConnectX-7 400G → نسيج الحوسبة
بالنسبة لـ GB300:
وحدة معالجة الرسومات → ConnectX-8 800G → مستويان حسابيان 400G
بالإضافة إلى وصلة العقدة بالورقة، تظهر المزيد من الوحدات البصرية في:
- الوصلات بين الورقة والعمود الفقري
- روابط العمود الفقري بالعمود الفقري الفائق على نطاق أوسع
- شبكات التخزين
- الشبكات الأمامية أو الشبكات المتقاربة
- شبكات الإدارة داخل النطاق
- اتصالات خادم الدعم
- الربط البيني لمراكز البيانات
ولهذا السبب لا يمكن حساب الفرصة البصرية التي توفرها البنية التحتية للذكاء الاصطناعي ببساطة عن طريق ضرب شحنات وحدات معالجة الرسومات في واحد.
يوفر عدد وحدات معالجة الرسومات نقطة انطلاق مفيدة لتقدير المنافذ عالية السرعة على جانب العقدة.
تعتمد قائمة المواد البصرية الكاملة على النسيج بأكمله.
والموثوقية لا تقل أهمية عن الكمية.
لا تُعتبر الوحدة البصرية مجرد بند في قائمة مكونات النظام. إنها جزء من نظام موزع متزامن حيث يمكن أن تؤثر سلامة الإشارة والأداء الحراري ومعدل خطأ البت وقابلية التشغيل البيني واستقرار الرابط واستعادة الأعطال بشكل مباشر على استخدام المجموعة.
على نطاق 100,000 وحدة معالجة رسومية، حتى الانخفاض الطفيف في موثوقية الاتصال يمكن أن يترجم إلى تأثير تشغيلي ذي مغزى.
في الوقت نفسه، سيكون من المبالغة الادعاء بأن كل وحدة بصرية معطلة تتسبب تلقائيًا في توقف المجموعة بأكملها. صُممت بنى الذكاء الاصطناعي الحديثة وبرامج التدريب لعزل أنواع عديدة من الأعطال، وإعادة توجيهها، وفحصها، والتعافي منها.
وبالتالي، فإن التحدي الهندسي الحقيقي ليس:
"هل يمكن أن تتعطل وحدة بصرية؟"
أنه:
"هل يستطيع النظام اكتشاف هذا العطل وعزله والتعافي منه بسرعة كافية للحفاظ على إنتاجية وحدات معالجة الرسومات باهظة الثمن؟"
الأسئلة الشائعة
كم عدد أجهزة الإرسال والاستقبال الضوئية التي استخدمها جهاز GPT-6 Astra فعلياً؟
لم يتم الكشف عن العدد الدقيق علنًا.
أكدت OpenAI أن نموذج Astra تم تدريبه مسبقًا على أكثر من 100,000 وحدة معالجة رسومية (GPU). في بنى NVIDIA NVL72 المرجعية الحالية، يوجد منفذ شبكة واحد عالي السرعة تقريبًا لكل وحدة معالجة رسومية.
لذلك، إذا استخدم كل اتصال قابل للتوسع يواجه وحدة معالجة الرسومات جهاز إرسال واستقبال ضوئي منفصل قابل للتوصيل، فقد يتطلب جانب العقدة وحده ما يقرب من 100,000 وحدة ضوئية.
ومع ذلك، لا ينبغي وصفها تلقائيًا بأنها وحدات 800G.
يستخدم جهاز GB200 NVL72 منافذ ConnectX-7 400G لشبكة الحوسبة، بينما يستخدم جهاز GB300 NVL72 منافذ ConnectX-8 800G. ولم يُكشف عن المزيج الدقيق لأجهزة أسترا.
ستتطلب المجموعة الكاملة عددًا أكبر بكثير من الواجهات البصرية بمجرد تضمين التبديل إلى التبديل والتخزين وبنى الشبكة الأخرى.
هل توجد أجهزة إرسال واستقبال ضوئية داخل رف NVL72؟
لا تستخدم بنية NVLink GPU-to-GPU نفسها أجهزة الإرسال والاستقبال الضوئية.
تستخدم أنظمة GB200 و GB300 NVL72 محولات NVLink وبنية تحتية لكابلات النحاس السلبية لربط وحدات معالجة الرسومات الـ 72 داخل نطاق NVLink.
ومع ذلك، لا يزال بإمكان الرف أن يحتوي على وحدات بصرية في واجهات شبكة ConnectX و BlueField المستخدمة لتوصيل النظام بشبكات الحوسبة والتخزين والإدارة الخارجية.
لماذا يتم تقسيم اتصال GB300 800G إلى رابطين 400G؟
يمكن لبنية NVIDIA المرجعية GB300 NVL72 تقسيم كل منفذ ConnectX-8 800G إلى رابطين 400G.
كل وصلة بسرعة 400 جيجابت في الثانية تتصل بمستوى مختلف من شبكة الحوسبة.
يوفر هذا نطاق ترددي إجمالي يبلغ 800 جيجابت في الثانية مع زيادة مرونة البنية وقدرة موازنة الأحمال.
المساران منفصلان على جانب الشبكة، لكنهما لا يزالان يشتركان في وحدة معالجة الرسومات، ومحول ConnectX-8، ووحدة الألياف الضوئية ثنائية المنفذ 800G الموجودة عادةً على جانب المضيف.
لماذا لا يستخدم NVL72 وحدات بصرية لتقنية NVLink من وحدة معالجة الرسومات إلى وحدة معالجة الرسومات داخل الحامل؟
تستخدم أنظمة NVL72 الحالية النحاس السلبي لنسيج NVLink داخل الرف لأن المسافات قصيرة ويمكن للنحاس أن يوفر نطاق ترددي عالي للغاية دون الحاجة إلى الطاقة الإضافية وتعقيد التحويل من الكهرباء إلى الضوء.
تزداد قيمة البصريات عندما يتعين على الإشارات أن تنتقل لمسافات أطول عبر شبكة مركز البيانات المتوسعة.
قد تؤدي التقنيات المستقبلية مثل الإدخال/الإخراج البصري والبصريات المدمجة في التغليف في نهاية المطاف إلى تقريب هذا الحد من وحدة معالجة الرسومات.
هل تبحث عن أجهزة إرسال واستقبال ضوئية بسرعة 400 جيجابت أو 800 جيجابت لشبكات الذكاء الاصطناعي؟
توفر FiberMall أجهزة الإرسال والاستقبال الضوئية 400G و 800G OSFP و QSFP-DD لتطبيقات الربط البيني لمراكز بيانات الذكاء الاصطناعي عالية السرعة، بما في ذلك التكوينات المستخدمة مع ConnectX-7 و ConnectX-8 و InfiniBand وشبكات تبديل Ethernet.
بالنسبة لعمليات نشر مجموعات الذكاء الاصطناعي الكبيرة، يمكن لـ FiberMall أيضًا دعم متطلبات التوريد المخصصة للوحدات البصرية، وDAC/AOC، وكابلات الألياف، وقائمة مكونات النظام.