
La mayor prueba de entrenamiento realizada por OpenAI hasta la fecha utilizó más de 100 000 GPU en su infraestructura Stargate en Texas. Todo el mundo está evaluando el rendimiento de GPT-6 Astra, pero mucha menos gente se pregunta qué tipo de red se necesitó para conectar un clúster de GPU de seis cifras.
La respuesta es más compleja que simplemente decir "100,000 GPU equivalen a 100,000 módulos ópticos de 800G".
El número de GPU es público. La combinación exacta de hardware y la lista de materiales ópticos no lo son.
Para comprender qué puede exigir la infraestructura de IA a escala Astra a las interconexiones ópticas, necesitamos separar lo que OpenAI y NVIDIA han revelado realmente de lo que se puede calcular utilizando las arquitecturas de referencia de NVIDIA y Cisco.
100,000 GPU, no 100,000 sistemas.
El jueves pasado, OpenAI lanzó GPT-6 Astra. Unos días después, el CEO de NVIDIA, Jensen Huang, publicó información sobre el lanzamiento, indicando que Astra había sido entrenado en aproximadamente "más de 100" GPU NVIDIA Grace Blackwell NVLink72 y que otras 400,000 GPU se pondrían en funcionamiento.
La redacción generó cierta confusión porque "NVL72" describe un sistema a escala de rack que contiene 72 GPU Blackwell, no una GPU individual.
El informe de OpenAI ofrece la respuesta más clara.
Aidan Clark, vicepresidente de investigación de OpenAI, declaró a los periodistas que Astra representaba, con diferencia, la mayor prueba de entrenamiento realizada por la compañía y marcaba la primera vez que OpenAI preentrenaba un modelo en más de 100,000 GPU en su centro Stargate de Texas.
Por lo tanto, la cifra principal debe interpretarse como:
Más de 100,000 GPU, no 100,000 racks NVL72.
Si las 100,000 GPU se asignaran a sistemas NVL72 de 72 GPU completamente poblados, el equivalente teórico sería:
100,000 ÷ 72 ≈ 1,389 racks NVL72
o aproximadamente 1,400 racks NVL72 completos.
Esto debe interpretarse como un cálculo equivalente en racks, no como un recuento físico confirmado de racks. OpenAI no ha revelado públicamente la combinación exacta de sistemas GB200, GB300 u otros sistemas Grace Blackwell utilizados en el clúster de entrenamiento Astra.
Escala de entrenamiento Astra
| Métrico | Escala aproximada |
| GPU utilizadas para el preentrenamiento de Astra | 100,000+ |
| Equivalente completo al rack NVL72 | ~ 1,400 |
| GPU por rack NVL72 | 72 |
| GPU adicionales a las que hace referencia Jensen Huang | 400,000 |
Figura 1. Configuración del rack NVIDIA NVL72
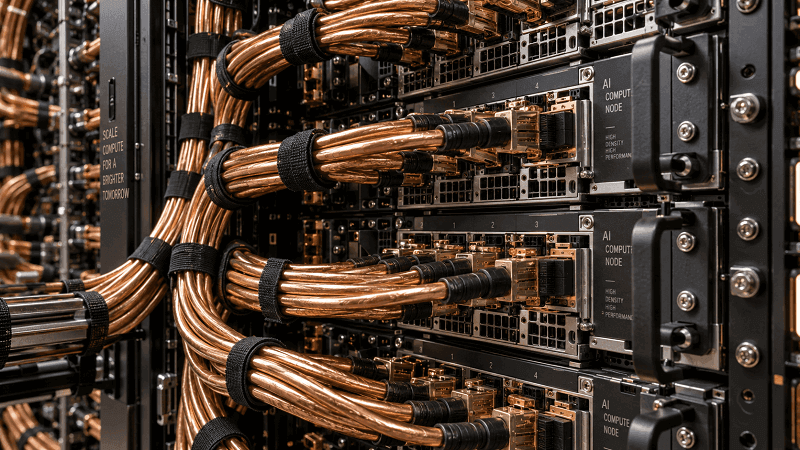
Un rack NVL72 completo contiene 72 GPU Blackwell conectadas mediante NVIDIA NVLink. La topología exacta de la implementación de Astra no se ha divulgado públicamente, por lo que la cifra de aproximadamente 1,400 racks debe entenderse como un cálculo equivalente y no como un inventario confirmado del sitio.
Dentro del rack: cero módulos ópticos en la estructura NVLink.
Esto puede parecer contradictorio, pero es una de las distinciones más importantes en la infraestructura de IA a escala de rack.
En el interior de los sistemas NVIDIA GB200 y GB300 NVL72, las 72 GPU se comunican a través de una estructura NVIDIA NVLink mediante conmutadores NVLink y un plano posterior de cable de cobre pasivo.
El dominio NVLink de GPU a GPU en sí mismo no requiere transceptores ópticos conectables.
Eso no significa que un rack NVL72 no contenga módulos ópticos. Se pueden instalar transceptores ópticos en las interfaces de red ConnectX o BlueField que se utilizan para conectar el rack a redes externas de computación, almacenamiento y administración.
La distinción es:
Estructura de escalado NVLink dentro del rack: cobre
Arquitectura de computación escalable entre racks: interfaces de red de alta velocidad que pueden utilizar transceptores ópticos.
El cobre resulta idóneo para las distancias cortas dentro de un rack, ya que evita la conversión innecesaria de electricidad a fibra óptica, al tiempo que ofrece un ancho de banda extremadamente alto y un consumo de energía relativamente bajo para conexiones de corto alcance.
Una vez que el tráfico tiene que salir del rack y viajar a través del clúster de IA más grande, la conectividad óptica se vuelve cada vez más importante porque la fibra admite un mayor alcance, una alta densidad de puertos y topologías de red a gran escala de manera más eficiente.
El límite que importa
Escalado de GPU dentro del mismo rack: NVLink sobre infraestructura de cobre pasiva.
Escalabilidad horizontal de GPU entre racks: las interfaces de red ConnectX se conectan mediante redes InfiniBand o Ethernet, que normalmente utilizan enlaces ópticos de alta velocidad en implementaciones a gran escala.
Esta frontera es importante hoy en día, pero no debe considerarse permanente. Tecnologías como la óptica integrada, la óptica cercana al encapsulado y las E/S ópticas podrían, con el tiempo, acercar la conectividad óptica al paquete de procesamiento.
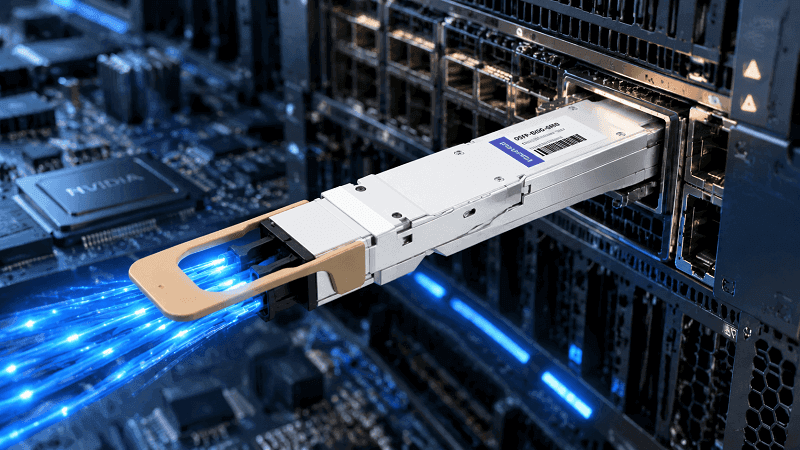
Fuera del rack: aproximadamente un puerto de red del lado del nodo por GPU.
De aquí surge la idea original de "una GPU, un módulo óptico", pero existe una importante distinción generacional.
GB200 NVL72: 400G por GPU
La arquitectura DGX GB200 NVL72 de NVIDIA contiene 18 bandejas de procesamiento.
Cada bandeja contiene:
- 4 GPU Blackwell
- 4 tarjetas de red NVIDIA ConnectX-7
- Cada interfaz ConnectX-7 admite una conexión de red informática de 400 Gb/s.
Eso da como resultado el estante:
72 GPU → 72 puertos de red de computación ConnectX-7 400G
En una implementación óptica de la estructura de computación, esto corresponde aproximadamente a un transceptor óptico de 400G en el nodo por cada GPU.
GB300 NVL72: 800G por GPU
La nueva generación GB300 NVL72 modifica la capa de red.
Cada bandeja de procesamiento GB300 incluye cuatro adaptadores de red ConnectX-8 para sus cuatro GPU.
Cada puerto ConnectX-8 admite 800 Gb/s y se puede configurar de la siguiente manera:
1 × 800 g → 2 × 400 g
Los dos enlaces de 400G pueden conectarse a dos planos de red informática separados.
Esto da como resultado:
72 GPU → 72 puertos host ConnectX-8 800G
y, en la arquitectura de referencia óptica de Cisco:
72 GPU → 72 módulos ópticos de nodo de doble puerto 800G
Redes GB200 vs. GB300
| Arquitectura de interiores | Adaptador de red de GPU | Velocidad del puerto host | Arquitectura óptica de referencia |
| GB200 NVL72 | Conectar X-7 | 400G | ~1 × óptica de 400G por GPU |
| GB300 NVL72 | Conectar X-8 | 800G | ~1 × óptica de doble puerto 800G por GPU |
| Ruptura de GB300 | Conectar X-8 | 2 × 400G | Una ruta de 400G a cada plano de cómputo |
Esta distinción es importante a la hora de estimar el número de transceptores ópticos que hay detrás del GPT-6 Astra.
OpenAI ha confirmado el uso de más de 100,000 GPU, pero no ha revelado públicamente la combinación precisa de GB200/GB300 ni la lista completa de materiales de la red (BOM).
Por lo tanto, la conclusión técnicamente defendible es:
Si las más de 100,000 GPU de Astra se conectaran mediante transceptores ópticos enchufables siguiendo las arquitecturas de referencia NVL72 actuales, solo el lado del nodo podría requerir del orden de 100,000 posiciones para módulos ópticos.
Pero esos módulos no deberían describirse automáticamente como 800G.
Si la implementación utilizara redes de clase GB200, muchos enlaces del lado del nodo serían de 400G. Si utilizara redes de clase GB300, las interfaces de host correspondientes podrían ser puertos ConnectX-8 de 800G.
Los cables ópticos activos, las conexiones de cobre de conexión directa u otras opciones de redes hiperescalables personalizadas también podrían cambiar la cantidad de transceptores discretos.
Figura 2. Desde los bastidores NVL72 hasta las interfaces ópticas del lado del nodo.
Un rack NVL72 completo contiene 72 GPU. La red interna de escalado vertical NVLink es de cobre. Cada GPU dispone de una interfaz de red de escalado horizontal: 400G con ConnectX-7 en GB200 o 800G con ConnectX-8 en GB300.
En aproximadamente 100,000 GPU, eso significa aproximadamente 100,000 puertos de red de alta velocidad en el lado del nodo, pero no necesariamente 100,000 módulos ópticos 800G idénticos.
El recuento óptico real es mayor.
La óptica del lado del nodo es solo una parte de una gran red de IA.
Los puertos de conmutación también requieren interfaces ópticas, y los clústeres grandes contienen conexiones adicionales de hoja a columna vertebral, estructuras de almacenamiento, redes de front-end, redes de administración y conexiones de servidores de soporte.
La arquitectura de referencia empresarial N9000 de Cisco para GB300 NVL72 facilita la visualización de la escala.
Para una implementación GB300 de cuatro racks con 288 GPU , la lista completa de materiales de Cisco es la siguiente:
- 288 módulos OSFPR-800G-DR8 con disipador de calor montado para el lado del nodo
- 1,112 OSFP-800G-DR8 módulos disipadores de calor integrados en otras partes de la arquitectura
- Transceptores ópticos adicionales de 400G, 200G y 100G para conectividad convergente, de almacenamiento, soporte y gestión.
Eso no significa que todos los clústeres de 100,000 GPU vayan a utilizar la misma proporción.
Los proveedores de servicios en la nube a gran escala pueden utilizar diferentes topologías de conmutación, índices de sobreasignación, alcances de fibra óptica, tipos de cable, diseños de almacenamiento o hardware de red personalizado.
Pero la dirección es clara:
El número de GPU por sí solo subestima significativamente la cantidad total de interfaces ópticas necesarias para construir una fábrica de IA.
Figura 3. Arquitectura óptica GB300 simplificada.
La cantidad de módulos en el lado del nodo aumenta proporcionalmente con la cantidad de GPU, mientras que la red completa requiere óptica adicional en las estructuras leaf, spine, convergente, de almacenamiento y de administración.
Para el GB300, ese puerto de 800G puede convertirse en dos planos de 400G.
La arquitectura GB300 introduce otro detalle importante en lo que respecta a la red.
Un puerto host ConnectX-8 de 800G se puede dividir en:
2 conexiones de 400 Gb/s
La arquitectura de referencia empresarial NVL72 de NVIDIA utiliza estas dos conexiones de 400G a través de una estructura de computación de doble plano.
Una ruta de 400G se conecta al Plano 1.
La otra ruta de 400G se conecta al Plano 2.
Cada plano utiliza su propia infraestructura de conmutación de hojas, lo que proporciona a la estructura de computación mayor resiliencia, equilibrio de carga y ancho de banda agregado.
Pero existe un importante matiz técnico.
Los dos planos de red no son completamente independientes de la GPU hasta la red.
Todavía comparten:
- La GPU
- El adaptador ConnectX-8
- El puerto host 800G
- Y, cuando se utiliza una óptica de doble puerto, el transceptor óptico del lado del host
Los caminos se separan al entrar en sus respectivos planos de cableado y conmutación.
Por lo tanto, la red de doble plano ayuda a proteger contra fallas en las rutas de conmutación individuales y los planos de red, pero no elimina todos los puntos de falla compartidos.
Por eso, afirmar que las dos rutas utilizan "transceptores separados sin un punto de fallo común" sería inexacto.
La arquitectura se describe mejor como:
Una interfaz de host de 800G → dos rutas de red de 400G → dos planos de cómputo
El diseño proporciona tanto ancho de banda como resiliencia.
Si un plano de red deja de estar disponible, el tráfico aún podría tener una ruta a través del otro plano, dependiendo de la ubicación de la falla y el comportamiento de recuperación del software. El rendimiento podría verse reducido, y una falla en la tarjeta de red compartida o en el módulo óptico del host aún podría afectar ambas rutas.
En una configuración de 100 000 GPU, la contención de fallos es casi tan importante como el ancho de banda bruto. Un único fallo de hardware puede desencadenar un proceso de recuperación que va mucho más allá del componente que falló.
Figura 4. Una interfaz ConnectX-8 de 800G conectada a dos planos de 400G.
Un módulo óptico de 800G con doble puerto puede proporcionar dos enlaces de 400G, uno para cada plano de cómputo. El conmutador y las rutas de cableado están separados, pero ambos enlaces comparten la tarjeta de red del lado de la GPU y el módulo óptico.
Por qué es necesario este nivel de redundancia
Porque a gran escala, los fallos dejan de ser sucesos excepcionales.
Se integran al funcionamiento normal del clúster.
La prueba de entrenamiento Llama 3 405B de Meta proporciona uno de los mejores ejemplos documentados públicamente.
Meta entrenó a Llama 3 405B utilizando 16,384 GPU NVIDIA H100.
Durante un período de 54 días de preentrenamiento, el clúster experimentó lo siguiente:
- 466 interrupciones laborales en total
- 47 interrupciones planificadas
- 419 interrupciones inesperadas
Eso equivale aproximadamente a una interrupción inesperada cada 3.1 horas.
El análisis de fallos resulta especialmente útil.
Meta informó:
- 148 interrupciones de GPU defectuosas
- 72 fallos de memoria HBM3
- 54 interrupciones por errores de software
- 35 interrupciones en conmutadores/cables de red
- 32 interrupciones no planificadas por mantenimiento del host
- 19 fallos en la memoria SRAM de la GPU
- 17 fallos en el procesador del sistema GPU
- 7 interrupciones relacionadas con la tarjeta de red
- Solo 2 fallos de CPU
Por lo tanto, los conmutadores y cables de red causaron 35 interrupciones, o el 8.4% de las interrupciones inesperadas.
Eso es considerable, pero no fue la categoría de fallos más numerosa.
Los problemas relacionados con la GPU fueron mucho más significativos: Meta informó que los problemas con la GPU representaron el 58.7% de las interrupciones inesperadas.
Llama 3 405B — ¿Qué fue lo que realmente se rompió?
| Métrico | Resultado |
| Resumen de la capacitación | 54 días |
| GPU | 16,384H100 |
| interrupciones totales | 466 |
| Interrupciones inesperadas | 419 |
| Interrupciones en el conmutador/cable de red | 35 |
| Porcentaje de interrupciones inesperadas en la red | 8.4% |
El número de GPU que se han revelado para GPT-6 Astra es más de seis veces mayor que el del clúster Llama 3 405B.
Sin embargo, sería incorrecto simplemente multiplicar la tasa de fallos de Meta por 6.1.
Astra utiliza una generación de hardware, una topología de red, una pila de software, un entorno operativo, un sistema de gestión de fallos y, potencialmente, estrategias de puntos de control diferentes.
Lo que demuestran los datos de Meta es algo más general:
A medida que los clústeres de GPU síncronos aumentan de tamaño, la fiabilidad de los componentes y la recuperación automática de fallos se vuelven cada vez más importantes.
Un solo componente puede tener una fiabilidad individual excelente, mientras que en una flota de componentes valorada en cientos de miles de dólares se producen fallos con regularidad.
Por eso, los grandes clústeres de IA invierten fuertemente en:
- Telemetría de red
- Monitoreo de estado de enlace
- Aislamiento automatizado de fallas
- Punto de control
- Rápida recuperación del empleo
- Rutas de red redundantes
- Mantenimiento predictivo
OpenAI también afirmó que las generaciones anteriores de sus modelos desempeñaron un papel fundamental en el proceso de entrenamiento de Astra.
Los informes públicos respaldan la idea de que los modelos anteriores asistieron o supervisaron partes del proceso de entrenamiento. Sin embargo, no hay suficiente evidencia pública para concluir que los modelos anteriores repararon de forma autónoma fallas individuales de red o hardware "en cuestión de segundos".
La idea principal sigue siendo válida: operar un clúster de GPU de seis cifras requiere mucha más automatización que simplemente instalar GPU y ejecutar una tarea de entrenamiento.
Ubicación real de los transceptores ópticos en un clúster de entrenamiento.
Los transceptores ópticos no se utilizan para la comunicación de GPU a GPU de mayor ancho de banda dentro de un rack NVL72.
Ese trabajo le corresponde a NVLink.
El GB200 NVL72 de NVIDIA crea un dominio NVLink de 72 GPU con una comunicación de ancho de banda extremadamente alto y baja latencia dentro del rack, utilizando conmutadores NVLink y conectividad de cobre pasiva.
La interconexión óptica se vuelve fundamental cuando el sistema tiene que escalarse más allá de un solo rack.
Para GB200:
GPU → ConnectX-7 400G → tejido de cómputo
Para GB300:
GPU → ConnectX-8 800G → 2 × 400G planos de cómputo
Más allá de la conexión nodo-hoja, aparecen más módulos ópticos en:
- Conexiones de la hoja a la espina
- Enlaces entre espinas vertebrales y superespinas a mayor escala
- Redes de almacenamiento
- Redes de interfaz o convergentes
- Redes de gestión en banda
- Conexiones con el servidor de soporte
- Interconexión de centros de datos
Por eso, la oportunidad que ofrece la infraestructura de IA en el ámbito óptico no se puede calcular simplemente multiplicando por uno los envíos de GPU.
El número de GPU proporciona un punto de partida útil para estimar los puertos de alta velocidad del nodo.
La lista de materiales ópticos completa depende de todo el tejido.
Y la fiabilidad importa tanto como la cantidad.
Un módulo óptico no es simplemente un elemento más en una lista de materiales. Forma parte de un sistema distribuido síncrono en el que la integridad de la señal, el rendimiento térmico, la tasa de error de bits, la interoperabilidad, la estabilidad del enlace y la recuperación ante fallos pueden influir directamente en la utilización del clúster.
En una configuración de 100,000 GPU, incluso una pequeña reducción en la fiabilidad del enlace puede traducirse en un impacto operativo significativo.
Al mismo tiempo, sería exagerado afirmar que cada módulo óptico defectuoso paraliza automáticamente todo el clúster. Las arquitecturas de IA modernas y el software de entrenamiento están diseñados para aislar, redirigir, establecer puntos de control y recuperarse de muchos tipos de fallos.
Por lo tanto, el verdadero desafío de ingeniería no es:
“¿Puede fallar un módulo óptico?”
Es:
“¿Puede el sistema detectar, aislar y recuperarse de ese fallo con la suficiente rapidez como para mantener la productividad de las costosas GPU?”
Preguntas frecuentes
¿Cuántos transceptores ópticos utilizó realmente GPT-6 Astra?
La cifra exacta no se ha hecho pública.
OpenAI confirmó que Astra fue preentrenado en más de 100 000 GPU. En las arquitecturas de referencia NVIDIA NVL72 actuales, hay aproximadamente un puerto de red de alta velocidad escalable por GPU.
Por lo tanto, si cada conexión de escalabilidad horizontal orientada hacia la GPU utilizara un transceptor óptico enchufable discreto, solo el lado del nodo podría requerir aproximadamente 100,000 módulos ópticos.
Sin embargo, no deberían describirse automáticamente como módulos de 800G.
El GB200 NVL72 utiliza puertos de red y computación ConnectX-7 de 400G, mientras que el GB300 NVL72 utiliza puertos ConnectX-8 de 800G. La configuración exacta del hardware de Astra no se ha revelado.
El clúster completo requeriría muchas más interfaces ópticas una vez que se incluyan la comunicación entre conmutadores, el almacenamiento y otras estructuras de red.
¿Hay transceptores ópticos dentro de un rack NVL72?
La propia arquitectura NVLink de comunicación GPU a GPU no utiliza transceptores ópticos.
Los sistemas GB200 y GB300 NVL72 utilizan conmutadores NVLink e infraestructura de cable de cobre pasivo para interconectar las 72 GPU dentro del dominio NVLink.
Sin embargo, el rack aún puede contener módulos ópticos en las interfaces de red ConnectX y BlueField que se utilizan para conectar el sistema a redes externas de computación, almacenamiento y administración.
¿Por qué se divide una conexión GB300 de 800G en dos enlaces de 400G?
La arquitectura de referencia GB300 NVL72 de NVIDIA puede dividir cada puerto ConnectX-8 de 800G en dos enlaces de 400G.
Cada enlace de 400G se conecta a un plano de red informática diferente.
Esto proporciona un ancho de banda agregado de 800G, al tiempo que aumenta la resiliencia de la red y la capacidad de equilibrio de carga.
Las dos rutas están separadas en el lado de la red, pero aún comparten la GPU, el adaptador ConnectX-8 y, por lo general, el módulo óptico de 800G de doble puerto del lado del host.
¿Por qué el NVL72 no utiliza módulos ópticos para la comunicación NVLink entre GPU dentro del rack?
Los sistemas NVL72 actuales utilizan cobre pasivo para su estructura NVLink dentro del rack porque las distancias son cortas y el cobre puede proporcionar un ancho de banda extremadamente alto sin la potencia adicional ni la complejidad de la conversión eléctrica a óptica.
La óptica adquiere mayor valor cuando las señales deben viajar más lejos a través de la red del centro de datos escalable.
Las tecnologías futuras, como la E/S óptica y la óptica integrada, podrían eventualmente acercar este límite a la GPU.
¿Busca transceptores ópticos de 400G u 800G para arquitecturas de IA?
FiberMall ofrece transceptores ópticos OSFP y QSFP-DD de 400G y 800G para aplicaciones de interconexión de alta velocidad en centros de datos de IA, incluidas configuraciones utilizadas con ConnectX-7, ConnectX-8, InfiniBand y redes de conmutación Ethernet.
Para implementaciones de clústeres de IA a gran escala, FiberMall también puede brindar soporte para requisitos personalizados de abastecimiento de módulos ópticos, DAC/AOC, cableado de fibra y listas de materiales (BOM).