
Après être entré dans l'ère des grands modèles, le développement de grands modèles est devenu le cœur de l'intelligence artificielle, mais la formation de grands modèles est en réalité une tâche compliquée car elle nécessite une grande quantité de ressources GPU et un long temps de formation.
De plus, un seul thread de travail GPU a une mémoire limitée et la taille de nombreux grands modèles dépasse la portée d'un seul GPU. Par conséquent, il est nécessaire de mettre en œuvre la formation de modèles sur plusieurs GPU. Cette méthode de formation implique la communication distribuée et NVLink.
Quand on parle de communications distribuées et de NVLink, nous sommes dans un domaine technique passionnant et évolutif. Ensuite, nous présenterons brièvement les principes de la communication distribuée et l'évolution de NVLink, la technologie qui permet d'obtenir une communication distribuée efficace.
La communication distribuée fait référence à la connexion de plusieurs nœuds dans un système informatique afin qu'ils puissent communiquer et collaborer les uns avec les autres pour accomplir des tâches communes. NVLink est une technologie de communication à haut débit et à faible latence qui est généralement utilisée pour connecter des GPU ou des GPU à d'autres appareils afin d'obtenir un calcul et une transmission de données hautes performances.
Parallélisme distribué
Actuellement, le deep learning est entré dans l’ère des grands modèles, à savoir les Foundation Models. Le grand modèle, comme son nom l’indique, se concentre sur le « grand ». Il comprend principalement les aspects suivants :
- Grande taille de données
Les grands modèles utilisent généralement des méthodes d'apprentissage auto-supervisées, ce qui réduit les coûts d'annotation des données, de formation et de R&D, tandis que de grandes quantités de données peuvent améliorer la capacité de généralisation et les performances du modèle.
- Grande échelle de paramètres
À mesure que l'échelle des paramètres du modèle continue d'augmenter, le modèle peut mieux capturer les relations et les modèles complexes dans les données, et devrait encore dépasser les limites de précision de la structure du modèle existant.
- Exigences élevées en matière de puissance de calcul
Les données et paramètres à grande échelle rendent impossible l’exécution et le calcul du modèle sur une seule machine. D'une part, cela nécessite une amélioration continue du matériel informatique et, d'autre part, cela nécessite également que le cadre d'IA dispose de capacités de formation parallèles distribuées.
Par conséquent, afin de résoudre les problèmes ci-dessus, nous devons introduire une stratégie parallèle distribuée.
Parallélisme des données
Data Parallel (DP) est une stratégie de formation d'apprentissage en profondeur couramment utilisée qui permet un traitement parallèle en distribuant les données sur plusieurs GPU. Dans un cadre parallèle aux données, chaque GPU (ou unité de travail) stocke une copie complète du modèle afin que chaque GPU puisse effectuer indépendamment des calculs de propagation vers l'avant et vers l'arrière sur le sous-ensemble de données qui lui est attribué.
Workflow parallèle de données :
- Synchronisation des paramètres : Avant de commencer la formation, toutes les unités de travail synchronisent les paramètres du modèle pour garantir que les copies du modèle sur chaque GPU sont identiques.
- Répartition des données : Les données d'entraînement sont divisées en lots, chaque lot est ensuite divisé en sous-ensembles et chaque GPU est responsable du traitement d'un sous-ensemble de données.
- Calcul de gradient indépendant: Chaque GPU effectue indépendamment une propagation vers l'avant et vers l'arrière sur son sous-ensemble de données et calcule les gradients correspondants.
- Agrégation de dégradés: Une fois le calcul terminé, les pentes de toutes les unités de travail doivent être agrégées. Ceci est généralement réalisé via une communication réseau, par exemple à l'aide d'un algorithme All-Reduce, qui permet de moyenner efficacement les gradients sur différents GPU.
- Mise à jour des paramètres: Une fois les dégradés moyennés, chaque GPU utilise ce dégradé moyenné pour mettre à jour les paramètres de sa copie du modèle.
- Répétition du processus : Ce processus est répété sur chaque lot de données jusqu'à ce que le modèle soit formé sur l'ensemble de données.
Avantages et défis du parallélisme des données :
Le parallélisme des données peut permettre au processus de formation d'évoluer horizontalement vers davantage de GPU, accélérant ainsi la formation. Ses avantages résident dans la simplicité de mise en œuvre et dans la possibilité d'ajuster de manière flexible le nombre d'unités de travail pour s'adapter aux ressources matérielles disponibles. Actuellement, de nombreux frameworks d’apprentissage profond fournissent une prise en charge intégrée.
Cependant, à mesure que le nombre de GPU parallèles augmente, davantage de copies de paramètres doivent être stockées, ce qui entraîne une surcharge de mémoire importante. De plus, l'étape d'agrégation par gradient nécessite de synchroniser une grande quantité de données entre les GPU, ce qui peut devenir un goulot d'étranglement du système, notamment lorsque le nombre d'unités de travail augmente.
Application du schéma de synchronisation asynchrone dans le parallélisme des données :
Afin de résoudre le problème des goulots d'étranglement de communication dans le parallélisme des données, les chercheurs ont proposé divers schémas de synchronisation asynchrone. Dans ces schémas, chaque thread de travail GPU peut traiter les données indépendamment des autres threads, sans attendre que les autres threads de travail terminent leurs calculs de gradient et leur synchronisation. Cette approche peut réduire considérablement les temps morts causés par la communication, améliorant ainsi le débit du système.
Le principe de mise en œuvre est que lors de l'étape de calcul du gradient, une fois que chaque GPU a terminé sa propre propagation vers l'avant et vers l'arrière, il met immédiatement à jour le gradient sans attendre les autres GPU. De plus, chaque GPU lit les dernières pondérations globales disponibles en cas de besoin sans avoir à attendre que tous les GPU atteignent un point de synchronisation.
Cependant, cette approche présente également des inconvénients. Étant donné que les poids des modèles sur différents GPU peuvent ne pas être synchronisés, les threads de travail peuvent utiliser des poids obsolètes pour les calculs de gradient, ce qui peut entraîner une diminution de l'efficacité statistique, c'est-à-dire que la précision ne peut pas être strictement garantie.
Parallélisme du modèle
Model Parallel (MP) fait généralement référence à la formation d'un grand modèle d'apprentissage en profondeur de manière distribuée sur plusieurs nœuds informatiques, où chaque nœud est responsable d'une partie du modèle. Cette méthode est principalement utilisée pour résoudre la situation où un seul nœud de calcul ne peut pas accueillir l’intégralité du modèle. Le parallélisme des modèles peut être subdivisé en plusieurs stratégies, y compris, mais sans s'y limiter, le parallélisme de pipeline (PP) et le parallélisme tensoriel (TP).
Le parallélisme des modèles est une méthode permettant de résoudre le problème selon lequel un seul nœud informatique ne peut pas prendre en charge tous les paramètres du modèle. Contrairement au parallélisme des données, dans lequel chaque nœud traite un sous-ensemble différent de données pour le modèle complet, le parallélisme des modèles distribue différentes parties du modèle sur plusieurs nœuds, chaque nœud étant responsable d'une partie seulement des paramètres du modèle. Cela peut réduire efficacement les besoins en mémoire et la charge de calcul d'un seul nœud.
Dans le parallélisme des modèles, plusieurs couches d'un réseau neuronal profond peuvent être divisées et attribuées à différents nœuds. Par exemple, nous pouvons regrouper plusieurs couches consécutives et attribuer le groupe de couches à un nœud. Cette stratégie hiérarchique permet à chaque nœud de traiter uniquement une partie des paramètres de modèle qui lui sont attribués, réduisant ainsi l'utilisation de la mémoire et des ressources informatiques.
Cependant, de simples implémentations parallèles à un modèle peuvent entraîner un temps d'attente important et une utilisation inefficace des ressources de calcul, car les couches avec des dépendances séquentielles doivent attendre la fin du calcul de la couche précédente.
Afin de réduire cette perte d’efficacité, le Pipeline Parallel (PP) a été proposé. Dans le parallélisme pipeline, un grand lot de données est divisé en plusieurs petits micro-lots. Chaque micro-lot doit être traité proportionnellement plus rapidement, et chaque travailleur commence à traiter le micro-lot suivant dès qu'il est disponible, accélérant ainsi l'exécution du pipeline. S'il y a suffisamment de microbatches, les travailleurs (cartes GPU) peuvent être pleinement utilisés et les « bulles » de temps d'inactivité au début et à la fin des étapes peuvent être minimisées.
Dans le parallélisme de pipeline, chaque nœud traite séquentiellement une couche de modèle différente et des micro-lots circulent entre les nœuds comme dans un pipeline. Les gradients sont moyennés sur tous les mini-lots, puis utilisés pour mettre à jour les paramètres du modèle.
Le parallélisme des pipelines divise le modèle « verticalement » en couches. Nous pouvons également diviser certaines opérations au sein d'une couche « horizontalement », souvent appelée formation Tensor Parallel (TP) pour améliorer encore l'efficacité.
Dans le parallélisme tensoriel, les grandes opérations de multiplication matricielle dans un modèle sont divisées en parties plus petites qui peuvent être exécutées en parallèle sur plusieurs nœuds de calcul. Par exemple, dans le modèle Transformer, la multiplication matricielle constitue un goulot d’étranglement informatique majeur. Avec le parallélisme tensoriel, nous pouvons diviser la matrice de poids en blocs plus petits, dont chacun est traité en parallèle sur différents nœuds.
En pratique, le parallélisme des modèles peut inclure une combinaison de parallélisme de pipeline et de parallélisme tensoriel. Un nœud peut être responsable d'une partie du modèle (parallélisme du modèle) et traiter différents micro-lots simultanément (parallélisme du pipeline), et au sein de ce nœud, les opérations matricielles importantes peuvent être davantage réparties sur plusieurs processeurs (parallélisme tensoriel). Une telle combinaison peut exploiter pleinement les ressources informatiques distribuées et améliorer l'efficacité de la formation de modèles à grande échelle.
Distribution du cadre d'IA
Pour la formation de modèles, quelle que soit la stratégie parallèle utilisée, son essence consiste à diviser le modèle « verticalement » ou « horizontalement », puis à placer les divisions séparées sur différentes machines pour que le calcul utilise pleinement les ressources informatiques.
Dans les cadres d'IA actuels, une approche parallèle mixte de plusieurs stratégies est généralement adoptée pour accélérer la formation des modèles. Pour prendre en charge le modèle de formation de plusieurs stratégies parallèles, il est nécessaire d'impliquer la manière dont les différentes parties du modèle « fractionné » communiquent.
Segmentation des graphiques d'entraînement IA
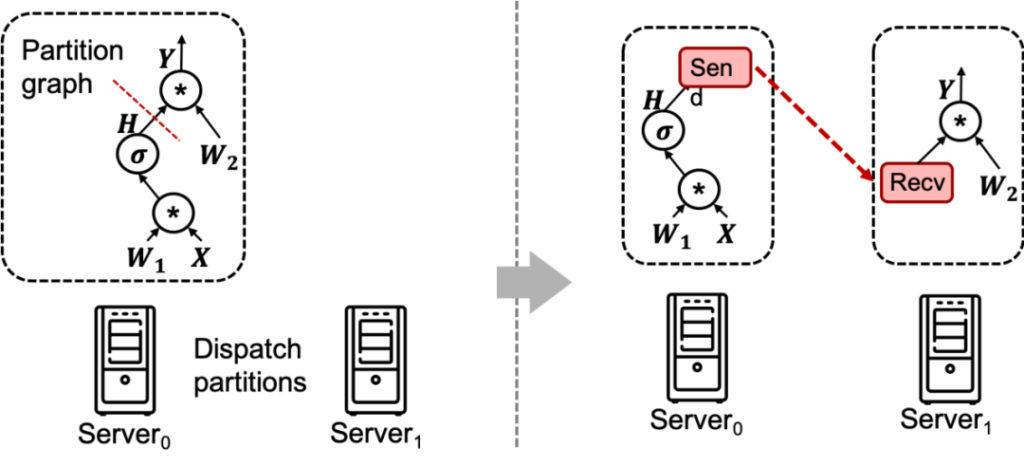
Comme le montre la figure ci-dessus, dans le cadre informatique de l'IA, nous devons diviser le modèle de réseau d'origine et le distribuer sur différentes machines à des fins informatiques. Ici, la communication s'effectue en insérant des nœuds Send et Recv dans le modèle.
De plus, dans la formation de modèles distribués, en raison de la segmentation du modèle, nous devons également placer les paramètres du modèle sur les machines où se trouvent les différentes parties du modèle. Au cours du processus de formation, nous impliquerons l'interaction et la synchronisation des paramètres de différents nœuds du modèle, ce qui nécessite également une synchronisation entre nœuds des données et des paramètres. Il s’agit d’une formation distribuée.
Ce que nous avons présenté ci-dessus, ce sont des stratégies et des algorithmes distribués au niveau logiciel. Voyons ensuite comment la communication est implémentée sur le matériel.
Matériel de communication
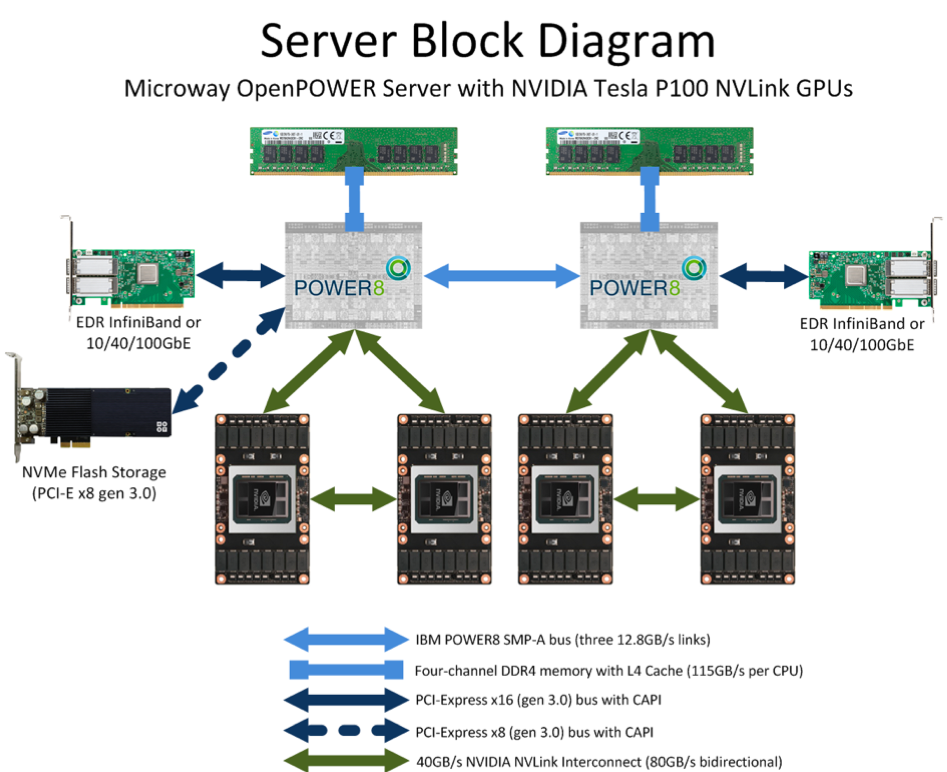
La communication distribuée est essentielle dans la formation à l'IA, en particulier lorsqu'il s'agit de modèles volumineux et de quantités massives de données. La communication distribuée implique la transmission de données et la coordination entre différents appareils ou nœuds pour réaliser un calcul parallèle et une synchronisation des paramètres du modèle, comme le montre la figure suivante.
Structure des services GPU
En matière de communication intra-machine, il existe plusieurs matériels courants :
- La memoire partagée: Plusieurs processeurs ou threads peuvent accéder à la même mémoire physique afin de pouvoir communiquer en lisant et en écrivant des données en mémoire. La mémoire partagée convient au calcul parallèle sur la même machine.
- PCIe (Interconnexion de composants périphériques Express) : Le bus PCIe est une interface standard pour connecter des périphériques informatiques, généralement utilisée pour connecter des GPU, des cartes accélératrices ou d'autres périphériques externes. Grâce au bus PCIe, les données peuvent être transférées entre différents appareils informatiques pour réaliser une informatique distribuée.
- NVLien : NVLink est une technologie d'interconnexion haut débit développée par NVIDIA qui permet une communication directe entre les GPU. NVLink peut fournir une bande passante plus élevée et une latence plus faible que PCIe, ce qui convient aux tâches nécessitant des performances de communication plus élevées.
En termes de communication de machine à machine, le matériel commun comprend :
- Réseau TCP/IP: Le protocole TCP/IP est la base de la communication Internet, qui permet la transmission de données entre différentes machines sur le réseau. En informatique distribuée, les réseaux TCP/IP peuvent être utilisés pour la communication et le transfert de données entre machines.
- Réseau RDMA (accès direct à la mémoire) : RDMA est une technologie de communication réseau haute performance qui permet de transférer des données directement d'une zone mémoire à une autre sans impliquer le CPU. Les réseaux RDMA sont souvent utilisés pour créer des clusters de calcul hautes performances afin de fournir une transmission de données à faible latence et à haut débit.
Après avoir compris le matériel, la bibliothèque qui fournit des fonctions de communication collective est indispensable pour réaliser la communication. Parmi elles, l’une des bibliothèques de communication collective les plus utilisées est MPI (Message Passing Interface), largement utilisée sur les CPU. Sur les GPU NVIDIA, la bibliothèque de communications collectives la plus couramment utilisée est NCCL (NVIDIA Collective Communications Library).
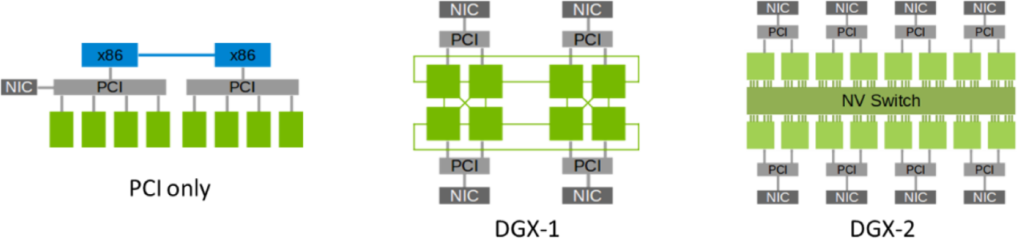
NVLink et NVSwitch
Comme le montre la figure ci-dessus, grâce à la bibliothèque NCCL, nous pouvons utiliser NVLink ou NVSwitch pour connecter différents GPU entre eux. NCCL fournit des API externes au niveau de l'algorithme, grâce auxquelles nous pouvons facilement effectuer des opérations de communication collective sur plusieurs GPU. L'API de NCCL couvre les opérations de communication collective courantes, telles que la diffusion, la réduction, la réduction globale, la synchronisation globale, etc., offrant ainsi aux développeurs des outils de calcul parallèle riches et efficaces.
Communication collective
Les communications collectives sont une opération de communication globale impliquant tous les processus d'un groupe de processus. Il comprend une série d'opérations de base, telles que l'envoi, la réception, la copie, la synchronisation des barrières de processus intra-groupe (Barrier) et la synchronisation des processus inter-nœuds (signal + attente). Ces opérations de base peuvent être combinées pour former un ensemble de modèles de communication, également appelés primitives de communication. Par exemple, diffusion un-à-plusieurs, rassemblement plusieurs-à-un, rassemblement plusieurs-à-plusieurs (rassemblement de tous), diffusion un-à-plusieurs (scatter), réduction plusieurs-à-un, plusieurs-à- plusieurs réduisent (tout-réduit), une réduction et une dispersion combinées (réduction-diffusion), plusieurs à plusieurs (tout à tous), etc. Présentons brièvement quelques-uns d'entre eux ci-dessous.
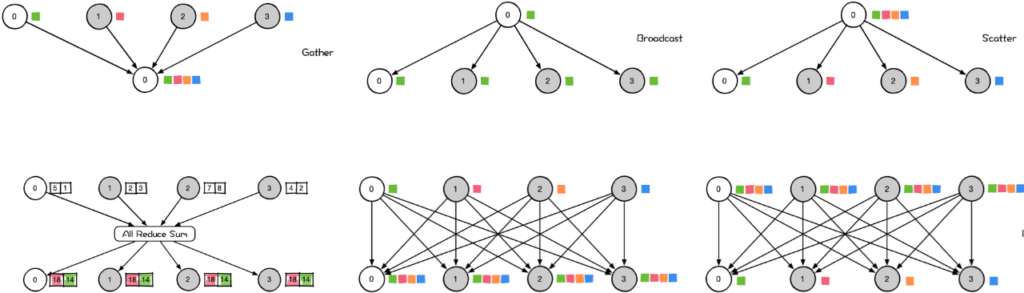
Communication collective
L'opération Gather est une primitive de communication plusieurs-à-un avec plusieurs expéditeurs de données et un récepteur de données. Il peut collecter des données de plusieurs nœuds vers un nœud du cluster. Son fonctionnement inverse correspond au Scatter.
La diffusion est une primitive de communication un-à-plusieurs, avec un expéditeur de données et plusieurs récepteurs de données. Il peut diffuser les propres données d'un nœud vers d'autres nœuds du cluster. Comme le montre la figure ci-dessus, lorsque le nœud maître 0 exécute la diffusion, les données sont diffusées du nœud maître 0 vers les autres nœuds.
Scatter est une distribution de données un à plusieurs. Il divise les données d'une carte GPU en fragments et les distribue à toutes les autres cartes GPU.
AllReduce est une primitive de communication plusieurs-à-plusieurs avec plusieurs expéditeurs de données et plusieurs récepteurs de données. Il effectue la même opération de réduction sur tous les nœuds du cluster et peut envoyer les résultats des opérations de réduction des données sur tous les nœuds du cluster à tous les nœuds. En termes simples, AllReduce est une opération de réduction de données plusieurs-à-plusieurs, qui réduit les données de toutes les cartes GPU (telles que SUM) à chaque carte GPU du cluster.
AllGather est une primitive de communication plusieurs-à-plusieurs avec plusieurs expéditeurs de données et plusieurs récepteurs de données. Il peut collecter des données de plusieurs nœuds du cluster vers un nœud maître (Gather), puis distribuer les données collectées à d'autres nœuds.
L'opération AllToAll disperse les données de chaque nœud sur tous les nœuds du cluster, et chaque nœud rassemble également les données de tous les nœuds du cluster. AllToAll est une extension d'AllGather. La différence est que dans l'opération AllGather, les données collectées à partir d'un certain nœud par différents nœuds sont les mêmes, tandis que dans AllToAll, les données collectées à partir d'un certain nœud par différents nœuds sont différentes.
Développement NVLlink et NVSwitch
NVLink et NVSwitch sont deux technologies révolutionnaires introduites par NVIDIA qui redéfinissent la façon dont les CPU et les GPU, ainsi que les GPU et les GPU, fonctionnent ensemble et communiquent efficacement.
NVLink est un protocole de bus et de communication avancé. NVLink utilise une structure point à point et une transmission série pour connecter l'unité centrale (CPU) et l'unité de traitement graphique (GPU). Il peut également être utilisé pour connecter plusieurs unités de traitement graphique (GPU).
NVSwitch : une technologie d'interconnexion à haut débit. En tant que puce NVLink indépendante, elle fournit jusqu'à 18 interfaces NVLink, qui peuvent réaliser une transmission de données à haut débit entre plusieurs GPU.
L'introduction de ces deux technologies apporte une bande passante de communication plus élevée et une latence plus faible aux scénarios d'application tels que les clusters GPU et les systèmes d'apprentissage profond, améliorant ainsi les performances et l'efficacité globales du système.
Développement NVLink
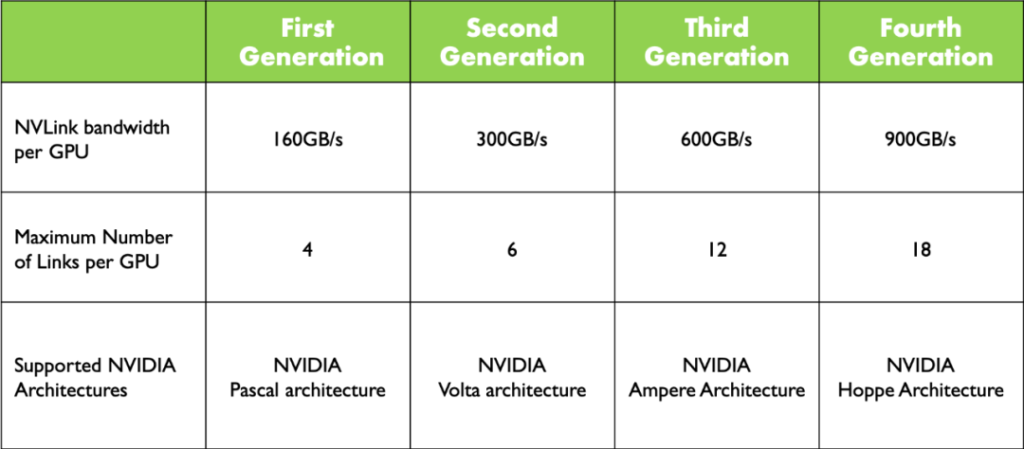
Développement NVLink
Comme le montre la figure ci-dessus, NVLink a traversé quatre générations de développement et d'évolution de l'architecture Pascal à l'architecture Hoppe. Lors de la conférence GTC en 2024, NVIDIA a publié l'architecture Blackwell, dans laquelle NVLink a été à nouveau mis à jour et le NVLink de cinquième génération a été publié, avec une bande passante d'interconnexion de 1800 XNUMX Go/s.
A chaque mise à jour de NVLink, la bande passante d'interconnexion de chaque GPU est continuellement améliorée. Le nombre de GPU pouvant être interconnectés entre NVLinks est également passé de 4 dans la première génération à 18 dans la quatrième génération. La dernière architecture Blackwell n'a pas augmenté le nombre maximum de GPU interconnectés.
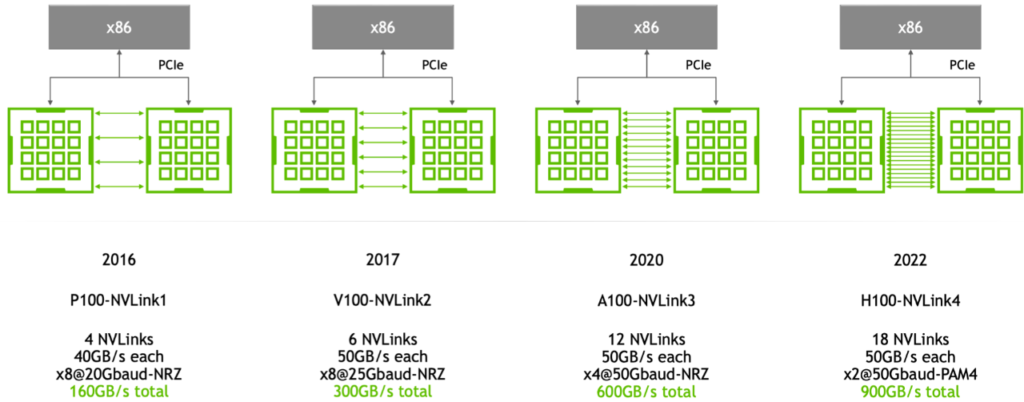
Développement NVLink
Comme le montre la figure ci-dessus, chaque NVLink du P100 ne dispose que de 40 Go/s, tandis que du V100 au H100 de deuxième génération, chaque lien NVLink dispose de 50 Go/s. La bande passante globale augmente en augmentant le nombre de liens.
Développement NVSwitch
La technologie NVSwitch a subi trois générations d'évolution et de développement depuis l'architecture Volta jusqu'à l'architecture Hopper. Le nombre de chipsets interconnectés par GPU est resté constant à huit pour chaque génération, ce qui signifie que la structure de base de l'interconnexion reste stable et cohérente. Avec la mise à niveau de l'architecture NVLink, la bande passante entre les GPU a atteint une augmentation significative, car NVSwitch est le module de puce spécifiquement transporté par NVLink, de 300 Go/s dans l'architecture Volta à 900 Go/s dans l'architecture Hopper.
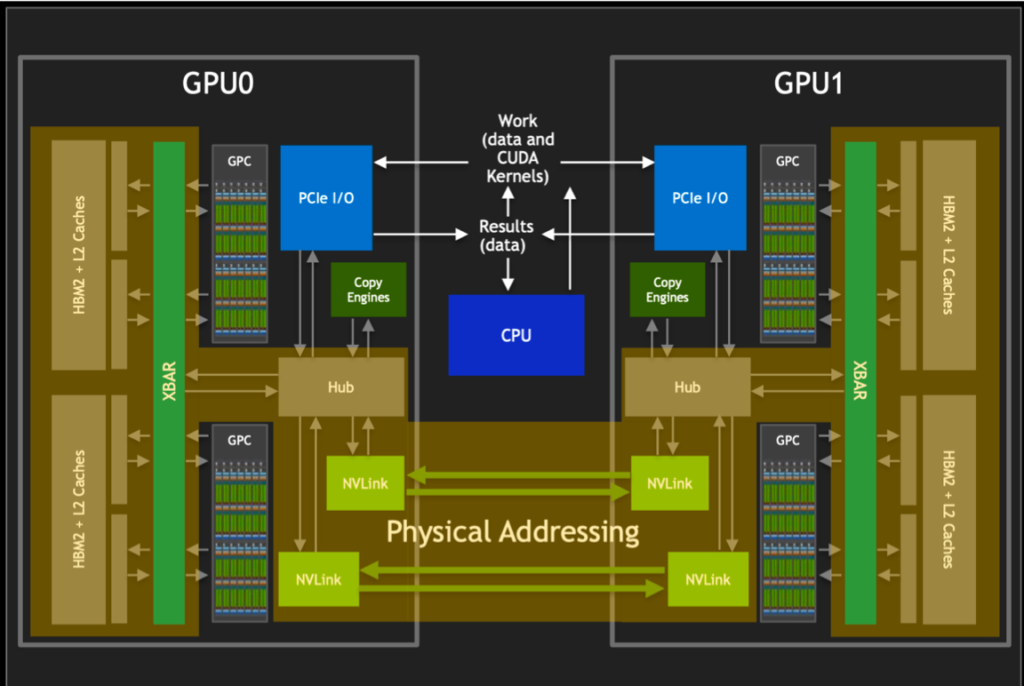
Examinons ensuite la relation entre NVLink et NVSwitch sur le serveur.
Développement NVSwitch
Comme le montre la figure ci-dessus, il n'y a que NVLink dans le P100 et les GPU sont interconnectés via CubeMesh. Dans P100, chaque GPU dispose de 4 interconnexions, et toutes les 4 forment un CubeMesh.
Dans la version V100, chaque GPU peut être interconnecté avec un autre GPU via NVSwitch. Dans A100, NVSwitch a de nouveau été mis à niveau, économisant ainsi de nombreux liens. Chaque GPU peut être interconnecté avec n'importe quel autre GPU via NVSwitch.
Le H100 marque une nouvelle avancée technologique. Il y a 8 cartes GPU H100 dans une seule machine, et il existe une bande passante d'interconnexion bidirectionnelle de 900 Go/s entre deux cartes H100 quelconques. Il convient de noter que dans le système DGX H100, quatre NVSwitches réservent 72 connexions NVLink4 pour la connexion à d'autres systèmes DGX H100 via NVLink-Network Switch, facilitant ainsi la formation d'un système DGX H100 SuperPod. La bande passante bidirectionnelle totale des 72 connexions NVLink4 est d'environ 3.6 To/s.
Résumé
À l’ère des grands modèles, le développement de l’intelligence artificielle s’appuie de plus en plus sur des ressources de calcul puissantes, notamment les ressources GPU. Afin de former ces grands modèles, nous devons adopter une stratégie parallèle distribuée pour répartir les tâches de formation des modèles sur plusieurs GPU ou nœuds de calcul. Cela implique non seulement des stratégies telles que le parallélisme des données et le parallélisme des modèles, mais nécessite également des technologies de communication distribuées efficaces, telles que NVLink et NVSwitch, pour garantir une transmission et une synchronisation rapides des données entre les différentes unités informatiques.
Les frameworks d'IA à l'ère des grands modèles doivent non seulement prendre en charge différentes stratégies parallèles distribuées, mais doivent également impliquer et prendre en compte des technologies de communication distribuées telles que NVLink et NVSwitch pour prendre en charge une communication inter-nœuds efficace.
À mesure que la taille du modèle continue de croître à l’avenir, la demande en ressources informatiques continuera d’augmenter. Nous devons continuellement optimiser les stratégies parallèles distribuées et développer des technologies de communication distribuées plus efficaces. Il ne s’agit pas seulement d’une mise à jour d’optimisation stratégique sur le logiciel, mais implique également des mises à jour d’optimisation au niveau matériel.
NVLink et NVSwitch sont constamment mis à jour pour améliorer encore la vitesse et l'efficacité de la formation des modèles d'apprentissage profond. Comprendre ces innovations et avancées en matière de technologies de communication peut nous aider à mieux former des modèles plus grands et à pousser l’intelligence artificielle à un niveau plus profond.
Produits associés:
-
 NVIDIA MMA4Z00-NS400 Compatible 400G OSFP SR4 Flat Top PAM4 850nm 30m sur OM3/50m sur OM4 MTP/MPO-12 Module émetteur-récepteur optique FEC multimode
$400.00
-
Module émetteur-récepteur optique NVIDIA MMA4Z00-NS-FLT compatible 800GBASE 2 x SR4/SR8 OSFP RHS/Flat Top PAM4 850 nm 100 m DOM double MPO-12 MMF
$600.00
-
Module émetteur-récepteur optique double MMF MPO-12 compatible NVIDIA MMA4Z00-NS 800GBASE 2 x SR4/SR8 OSFP PAM4 850 nm 100 m DOM
$550.00
-
Module émetteur-récepteur optique NVIDIA MMS4X00-NM compatible 800GBASE 2 x DR4/DR8 OSFP IHS/à ailettes fermées PAM4 1310 nm 500 m DOM double MTP/MPO-12 SMF
$600.00
-
Module émetteur-récepteur optique SMF double MTP/MPO-12 compatible NVIDIA MMS4X00-NM-FLT 800GBASE 2 x DR4/DR8 OSFP à sommet plat PAM4 1310 nm 500 m DOM
$650.00
-
NVIDIA MMS4X00-NS400 Compatible 400G OSFP DR4 Flat Top PAM4 1310nm MTP/MPO-12 500m SMF FEC Module Émetteur-Récepteur Optique
$450.00
-
Module émetteur-récepteur optique compatible NVIDIA (Mellanox) MMA1T00-HS 200G Infiniband HDR QSFP56 SR4 850 nm 100 m MPO-12 APC OM3/OM4 FEC PAM4
$139.00
-
NVIDIA MFP7E10-N010 Compatible 10 m (33 pieds) 8 fibres faible perte d'insertion femelle à femelle câble tronc MPO polarité B APC vers APC LSZH multimode OM3 50/125
$47.00
-
NVIDIA MCP7Y00-N003-FLT Compatible 3m (10ft) OSFP double port 800G à 2x400G Flat Top OSFP InfiniBand NDR Breakout DAC
$260.00
-
NVIDIA MCP7Y70-H002 Compatible 2 m (7 pieds) 400G double port 2x200G OSFP à 4x100G QSFP56 câble en cuivre à connexion directe à dérivation passive
$155.00
-
Câble en cuivre actif NVIDIA MCA4J80-N003-FTF 3 m (10 pieds) 800G double port 2x400G OSFP vers 2x400G OSFP InfiniBand NDR, dessus plat à une extrémité et dessus à ailettes à l'autre
$600.00
-
NVIDIA MCP7Y10-N002 Compatible 2 m (7 pieds) 800G InfiniBand NDR double port OSFP vers 2x400G QSFP112 Breakout DAC
$190.00