
OpenAI는 지금까지 진행한 최대 규모의 학습에서 텍사스에 있는 스타게이트 인프라에 100,000만 개 이상의 GPU를 사용했습니다. 모두가 GPT-6 Astra의 벤치마킹에 열중하고 있지만, 수십만 개의 GPU 클러스터를 연결하는 데 어떤 네트워크가 필요했는지 묻는 사람은 훨씬 적습니다.
답은 단순히 "GPU 100,000만 개는 800G 광 모듈 100,000만 개와 같다"라고 말하기보다 더 복잡합니다.
GPU 개수는 공개되어 있지만, 정확한 하드웨어 구성 및 광학 부품 목록은 공개되지 않았습니다.
Astra 규모의 AI 인프라가 광 인터커넥트에 요구하는 사항을 이해하려면 OpenAI와 NVIDIA가 실제로 공개한 내용과 NVIDIA 및 Cisco 참조 아키텍처를 사용하여 계산할 수 있는 내용을 구분해야 합니다.
100,000만 개의 GPU — 100,000만 개의 시스템이 아닙니다.
지난 목요일, OpenAI는 GPT-6 아스트라를 출시했습니다. 며칠 후, NVIDIA CEO 젠슨 황은 출시 소식을 전하며 아스트라가 약 100만 개 이상의 NVIDIA Grace Blackwell NVLink72 GPU로 학습되었으며, 추가로 400,000만 개의 GPU가 가동될 예정이라고 밝혔습니다.
"NVL72"라는 용어가 개별 GPU가 아닌 72개의 Blackwell GPU가 포함된 랙 규모 시스템을 설명하기 때문에 표현에 혼란이 생겼습니다.
OpenAI 자체 브리핑에서 가장 명확한 답변을 찾을 수 있습니다.
오픈AI의 연구 부사장인 에이단 클라크는 기자들에게 아스트라 프로젝트가 회사 역사상 가장 큰 규모의 학습 실행이었으며, 텍사스 스타게이트 시설에서 100,000만 개 이상의 GPU를 사용하여 모델을 사전 학습시킨 최초의 사례라고 밝혔습니다.
따라서 헤드라인 수치는 다음과 같이 해석해야 합니다.
100,000만 개 이상의 GPU입니다. 100,000만 개의 NVL72 랙이 아닙니다.
만약 100,000만 개의 GPU가 모두 72개의 GPU로 구성된 NVL72 시스템에 탑재된다면, 이론적인 등가 사양은 다음과 같습니다.
100,000 ÷ 72 ≈ 1,389 NVL72 랙
또는 대략 1,400개의 NVL72 랙에 해당하는 양입니다.
이는 확정된 실제 랙 개수가 아니라 랙 등가 계산으로 간주해야 합니다. OpenAI는 Astra 학습 클러스터에 사용된 GB200, GB300 또는 기타 Grace Blackwell 시스템의 정확한 조합을 공개적으로 밝히지 않았습니다.
아스트라 훈련 척도
| 메트릭 | 대략적인 규모 |
| Astra 사전 학습에 사용되는 GPU | 100,000+ |
| NVL72 랙 전체 용량과 동일 | ~ 1,400 |
| NVL72 랙당 GPU 개수 | 72 |
| Jensen Huang이 언급한 추가 GPU | 400,000 |
그림 1. NVIDIA NVL72 랙 구성
NVL72 랙 하나에는 NVIDIA NVLink를 통해 연결된 72개의 Blackwell GPU가 포함되어 있습니다. Astra 구축의 정확한 토폴로지는 공개되지 않았으므로, 약 1,400개의 랙은 확정된 사이트 재고가 아닌 그에 상응하는 수치로 이해해야 합니다.
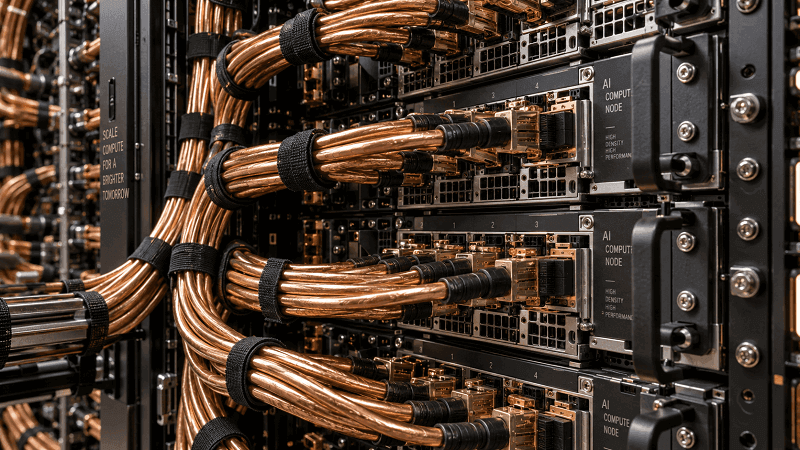
랙 내부 — NVLink 패브릭에 광 모듈은 하나도 없습니다.
언뜻 보기에는 직관에 어긋나는 것처럼 들리지만, 이는 랙 규모 AI 인프라에서 가장 중요한 차이점 중 하나입니다.
NVIDIA GB200 및 GB300 NVL72 시스템 내부에서 72개의 GPU는 NVLink 스위치와 수동 구리 케이블 백플레인을 사용하는 NVIDIA NVLink 패브릭을 통해 통신합니다.
GPU 간 NVLink 도메인 자체에는 플러그형 광 트랜시버가 필요 하지 않습니다.
그렇다고 해서 NVL72 랙에 광 모듈이 전혀 없다는 의미는 아닙니다. 광 트랜시버는 랙을 외부 컴퓨팅, 스토리지 및 관리 네트워크에 연결하는 데 사용되는 ConnectX 또는 BlueField 네트워크 인터페이스에 설치할 수 있습니다.
차이점은 다음과 같습니다.
랙 내부의 NVLink 스케일업 패브릭: 구리
랙 간 확장형 컴퓨팅 패브릭: 광 트랜시버를 사용할 수 있는 고속 네트워크 인터페이스
랙 내부의 짧은 거리에는 구리 케이블이 적합합니다. 불필요한 전기-광 변환을 피하면서도 매우 높은 대역폭을 제공하고, 단거리 연결에 필요한 전력 소모는 상대적으로 낮기 때문입니다.
트래픽이 랙을 벗어나 더 큰 AI 클러스터를 통과해야 하는 경우, 광섬유는 더 긴 도달 거리, 높은 포트 밀도 및 대규모 네트워크 토폴로지를 보다 효율적으로 지원하기 때문에 광 연결의 중요성이 점점 더 커집니다.
중요한 경계
랙 내 GPU 확장: 수동 구리 인프라를 통한 NVLink.
랙 간 GPU 확장: ConnectX 네트워크 인터페이스는 InfiniBand 또는 이더넷 패브릭을 통해 연결되며, 대규모 구축 환경에서는 일반적으로 고속 광 링크를 사용합니다.
이 경계는 오늘날 중요하지만 영구적인 것으로 간주해서는 안 됩니다. 코패키징 광학 장치, 근접 패키지 광학 장치 및 광학 I/O와 같은 기술은 궁극적으로 광학 연결을 컴퓨팅 패키지에 더 가깝게 이동시킬 수 있습니다.
랙 외부 - GPU당 노드 측 네트워크 포트 약 1개
이것이 바로 "GPU 하나당 광학 모듈 하나"라는 원래 아이디어의 기원이지만, 중요한 세대적 차이점이 있습니다.
GB200 NVL72: GPU당 400G
NVIDIA의 DGX GB200 NVL72 아키텍처에는 18개의 컴퓨팅 트레이가 포함되어 있습니다.
각 트레이에는 다음이 포함되어 있습니다:
- 4개의 블랙웰 GPU
- NVIDIA ConnectX-7 NIC 4개
- 각 ConnectX-7 인터페이스는 400Gb/s의 컴퓨팅-네트워크 연결을 지원합니다.
그러면 랙이 완성됩니다:
72개의 GPU → 72개의 ConnectX-7 400G 컴퓨팅 네트워크 포트
컴퓨팅 패브릭의 광학적 구현에서 이는 GPU당 약 1개의 400G 노드 측 광 트랜시버 에 해당합니다.
GB300 NVL72: GPU당 800G
최신 GB300 NVL72 세대는 네트워킹 계층을 변경했습니다.
각 GB300 컴퓨팅 트레이에는 4개의 GPU를 위한 4개의 ConnectX-8 네트워크 어댑터가 포함되어 있습니다.
각 ConnectX-8 포트는 800Gb/s를 지원하며 다음과 같이 구성할 수 있습니다.
1 × 800G → 2 × 400G
두 개의 400G 링크는 각각 별개의 컴퓨팅 네트워크 평면에 연결될 수 있습니다.
이것은 다음을 제공합니다.
72개의 GPU → 72개의 ConnectX-8 800G 호스트 포트
그리고 시스코의 광학 레퍼런스 아키텍처에서는 다음과 같습니다.
72개의 GPU → 72개의 듀얼 포트 800G 노드 측 광 모듈
GB200과 GB300 네트워킹 비교
| 아키텍처 | GPU 네트워크 어댑터 | 호스트 포트 속도 | 참조 광학 아키텍처 |
| GB200 NVL72 | 커넥트X-7 | 400G | GPU당 약 1개의 400G 광학 소자 |
| GB300 NVL72 | 커넥트X-8 | 800G | GPU당 듀얼 포트 800G 광학 모듈 약 1개 |
| GB300 브레이크아웃 | 커넥트X-8 | 2 × 400G | 각 컴퓨팅 평면에 400G 경로 하나씩 |
이러한 차이점은 GPT-6 Astra에 사용된 광 송수신기 수를 추정할 때 중요합니다.
OpenAI는 100,000만 개 이상의 GPU를 보유하고 있다고 확인했지만, 정확한 GB200/GB300 구성 비율이나 전체 네트워크 BOM은 공개하지 않았습니다.
따라서 기술적으로 타당한 결론은 다음과 같습니다.
만약 아스트라의 100,000만 개 이상의 GPU를 현재의 NVL72 레퍼런스 아키텍처에 따라 플러그형 광 트랜시버를 사용하여 연결한다면, 노드 측에서만 약 100,000만 개의 광 모듈 위치가 필요할 수 있습니다.
하지만 그러한 모듈들을 자동으로 800G라고 설명해서는 안 됩니다.
만약 구축에 GB200급 네트워킹이 사용된다면, 노드 측 링크의 상당수는 400G가 될 것입니다. GB300급 네트워킹이 사용된다면, 해당 호스트 인터페이스는 800G ConnectX-8 포트가 될 수 있습니다.
능동형 광케이블, 직접 연결 구리선 연결 또는 기타 맞춤형 하이퍼스케일 네트워킹 옵션에 따라 개별 트랜시버 개수가 변경될 수도 있습니다.
그림 2. NVL72 랙에서 노드 측 광 인터페이스까지
NVL72 랙 하나에는 72개의 GPU가 장착됩니다. 내부 NVLink 스케일업 네트워크는 구리 케이블을 사용합니다. 각 GPU는 확장형 네트워크 인터페이스를 갖추고 있는데, GB200 랙에서는 ConnectX-7을 통해 400G, GB300 랙에서는 ConnectX-8을 통해 800G를 지원합니다.
약 100,000만 개의 GPU를 고려하면, 노드 측 고속 네트워크 포트가 약 100,000만 개 필요하다는 의미이지만, 반드시 100,000만 개의 동일한 800G 광 모듈이 필요한 것은 아닙니다.
실제 광학 계수는 더 높습니다.
노드 측 광학 장치는 대규모 AI 네트워크의 한 부분일 뿐입니다.
스위치 포트에는 광 인터페이스도 필요하며, 대규모 클러스터에는 추가적인 리프-스파인 연결, 스토리지 패브릭, 프런트엔드 네트워크, 관리 네트워크 및 지원 서버 연결이 포함됩니다.
Cisco의 GB300 NVL72용 N9000 엔터프라이즈 참조 아키텍처를 통해 확장성을 더욱 쉽게 파악할 수 있습니다.
288개의 GPU를 사용하는 4개의 랙으로 구성된 GB300 구축 의 경우 , 시스코의 전체 BOM 목록은 다음과 같습니다.
- 288개의 OSFPR-800G-DR8 라이딩 방열판 모듈 노드 측의 경우
- 1,112 OSFP-800G-DR8 통합 방열판 모듈 건축물의 다른 부분
- 통합, 스토리지, 지원 및 관리 연결을 위한 추가 400G, 200G 및 100G 광 트랜시버
그렇다고 해서 모든 100,000만 개 GPU 클러스터가 동일한 비율을 사용한다는 의미는 아닙니다.
하이퍼스케일러는 서로 다른 스위치 토폴로지, 과다 가입 비율, 광섬유 도달 거리, 케이블 유형, 스토리지 설계 또는 맞춤형 네트워킹 하드웨어를 사용할 수 있습니다.
하지만 방향은 명확합니다.
GPU 개수만으로는 AI 공장을 구축하는 데 필요한 전체 광학 인터페이스 수를 상당히 과소평가하는 것입니다.
그림 3. 단순화된 GB300 광학 구조
노드 측 모듈 수는 GPU 수에 비례하여 증가하는 반면, 전체 네트워크에는 리프, 스파인, 컨버전스, 스토리지 및 관리 패브릭 전반에 걸쳐 추가적인 광학 장치가 필요합니다.
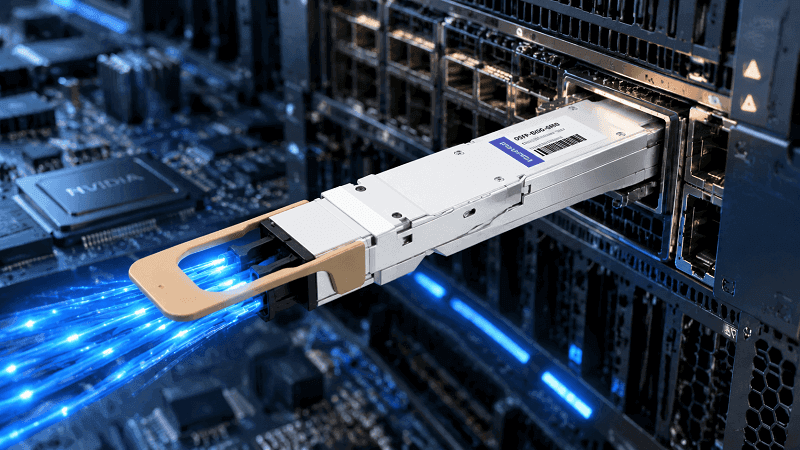
GB300의 경우, 800G 포트 하나를 두 개의 400G 플레인으로 나눌 수 있습니다.
GB300 아키텍처는 또 다른 중요한 네트워킹 세부 사항을 소개합니다.
800G ConnectX-8 호스트 포트는 다음과 같이 분할될 수 있습니다.
2 × 400Gb/s 연결
NVIDIA의 NVL72 엔터프라이즈 레퍼런스 아키텍처는 듀얼 플레인 컴퓨팅 패브릭을 통해 이 두 개의 400G 연결을 사용합니다.
400G 경로 하나가 1번 평면에 연결됩니다.
다른 400G 경로는 2번 평면에 연결됩니다.
각 평면은 자체 리프 스위치 인프라를 사용하므로 컴퓨팅 패브릭에 추가적인 복원력, 로드 밸런싱 및 총 대역폭을 제공합니다.
하지만 중요한 기술적 차이가 있습니다.
두 네트워크 평면은 GPU에서 네트워크에 이르기까지 완전히 독립적이지는 않습니다.
그들은 여전히 다음을 공유합니다:
- GPU
- ConnectX-8 어댑터
- 800G 호스트 포트
- 그리고 듀얼 포트 광 모듈을 사용하는 경우 호스트 측 광 트랜시버는
각 경로가 케이블링 및 스위칭 평면에 진입하면서 분리됩니다.
따라서 이중 평면 네트워킹은 개별 스위치 경로 및 네트워크 평면의 장애로부터 보호하는 데 도움이 되지만 모든 공통 장애 지점을 제거하는 것은 아닙니다 .
따라서 두 경로가 "공유 장애 지점이 없는 별도의 송수신기를 사용한다"라고 말하는 것은 정확하지 않습니다.
해당 건축 구조는 다음과 같이 설명하는 것이 더 적절합니다.
800G 호스트 인터페이스 1개 → 400G 네트워크 경로 2개 → 컴퓨팅 플레인 2개
이 설계는 대역폭과 복원력을 모두 제공합니다.
하나의 네트워크 평면을 사용할 수 없게 되더라도 장애 위치 및 소프트웨어 복구 동작에 따라 다른 평면을 통해 트래픽이 계속 전달될 수 있습니다. 하지만 성능이 저하될 수 있으며, 공유 NIC 또는 호스트 측 광 모듈에 장애가 발생하면 두 경로 모두에 영향을 미칠 수 있습니다.
100,000만 개의 GPU 규모에서는 장애 확산 방지가 순수 대역폭만큼이나 중요합니다. 단 하나의 하드웨어 오류로 인해 오류가 발생한 구성 요소의 범위를 훨씬 넘어 복구 작업이 필요할 수 있습니다.
그림 4. 하나의 ConnectX-8 800G 인터페이스가 두 개의 400G 평면에 연결된 모습
듀얼 포트 800G 광 모듈은 각 컴퓨팅 평면에 하나씩, 총 두 개의 400G 링크를 제공할 수 있습니다. 스위치와 케이블 경로는 분리되어 있지만, 두 링크 모두 GPU 측 NIC와 광 모듈을 공유합니다.
이 정도의 중복성이 필요한 이유
대규모로 진행될 경우, 실패는 더 이상 예외적인 사건이 아니게 되기 때문입니다.
그것들은 정상적인 클러스터 운영의 일부가 됩니다.
Meta의 Llama 3 405B 학습 실행은 공개적으로 문서화된 사례 중 가장 훌륭한 사례 중 하나입니다.
Meta는 16,384개의 NVIDIA H100 GPU를 사용하여 Llama 3 405B를 학습시켰습니다.
54일간의 사전 학습 기간 동안 클러스터는 다음과 같은 현상을 겪었습니다.
- 총 466건의 업무 중단이 발생했습니다.
- 47회의 계획된 중단
- 419건의 예상치 못한 중단
이는 대략 3.1시간 마다 한 번씩 예상치 못한 중단이 발생한다는 것을 의미합니다.
고장 분석은 특히 유용합니다.
메타가 보고했습니다:
- 148개의 잘못된 GPU 인터럽트 발생
- 72건의 HBM3 메모리 오류
- 54건의 소프트웨어 버그로 인한 중단
- 35건의 네트워크 스위치/케이블 장애
- 예기치 않은 호스트 유지 관리 중단 32건
- 19개의 GPU SRAM 메모리 오류
- 17개의 GPU 시스템 프로세서 오류
- 7. NIC 관련 중단
- CPU 오류는 단 2건 발생
따라서 네트워크 스위치와 케이블로 인해 35건의 장애가 발생했으며, 이는 예상치 못한 장애의 8.4%에 해당합니다.
그 수치는 상당하지만, 가장 큰 실패 범주는 아니었습니다.
GPU 관련 문제는 훨씬 더 심각했습니다. Meta는 GPU 문제가 예기치 않은 중단의 58.7%를 차지한다고 보고했습니다.
Llama 3 405B — 실제로 고장난 부분은 무엇인가요?
| 메트릭 | 결과 |
| 훈련 스냅샷 | 54 일 동안 |
| GPU | 16,384년 상반기 |
| 전체 중단 | 466 |
| 예상치 못한 중단 | 419 |
| 네트워크 스위치/케이블 중단 | 35 |
| 예기치 않은 중단의 네트워크 점유율 | 8.4% |
GPT-6 Astra의 공개된 GPU 개수는 Llama 3 405B 클러스터보다 6배 이상 많습니다.
하지만 Meta의 실패율에 단순히 6.1을 곱하는 것은 잘못된 것입니다.
Astra는 다른 세대의 하드웨어, 네트워크 토폴로지, 소프트웨어 스택, 운영 환경, 장애 관리 시스템, 그리고 경우에 따라 다른 체크포인트 전략을 사용합니다.
메타의 데이터가 보여주는 것은 좀 더 일반적인 사실입니다.
동기식 GPU 클러스터의 규모가 커짐에 따라 구성 요소의 신뢰성과 자동화된 오류 복구가 점점 더 중요해지고 있습니다.
개별 부품 하나는 뛰어난 신뢰성을 가질 수 있지만, 수십만 개에 달하는 부품으로 구성된 대규모 시스템에서는 어딘가에서 고장이 빈번하게 발생할 수 있습니다.
이것이 바로 대규모 AI 클러스터가 다음과 같은 분야에 집중적으로 투자하는 이유입니다.
- 네트워크 원격 측정
- 링크 상태 모니터링
- 자동 오류 격리
- 체크포인트
- 빠른 직업 복구
- 중복 네트워크 경로
- 예측 정비
OpenAI는 또한 이전 세대의 모델들이 Astra의 훈련 과정에서 중요한 역할을 했다고 밝혔습니다.
공개된 자료들을 보면 초기 모델들이 학습 워크플로의 일부를 지원하거나 감독했다는 점은 뒷받침됩니다. 하지만 초기 모델들이 개별 네트워크 또는 하드웨어 오류를 "몇 초 안에" 자율적으로 복구했다는 결론을 내릴 만큼 충분한 공개 증거는 없습니다.
핵심은 여전히 유효합니다. 수십만 달러 규모의 GPU 클러스터를 운영하려면 단순히 GPU를 설치하고 학습 작업을 시작하는 것보다 훨씬 더 많은 자동화가 필요합니다.
교육용 클러스터에서 광 송수신기의 실제 위치는 어디일까요?
NVL72 랙 내부에서 최고 대역폭의 GPU 간 통신에는 광 트랜시버가 사용되지 않습니다.
그 일은 NVLink가 담당합니다.
NVIDIA의 GB200 NVL72는 NVLink 스위치와 수동 구리 연결을 사용하여 랙 내부에서 초고대역폭, 저지연 통신을 지원하는 72개 GPU NVLink 도메인을 생성합니다.
시스템이 단일 랙을 넘어 확장 되어야 할 때 광 인터커넥트가 매우 중요해집니다.
GB200의 경우:
GPU → ConnectX-7 400G → 컴퓨팅 패브릭
GB300의 경우:
GPU → ConnectX-8 800G → 2 × 400G 컴퓨팅 플레인
노드-리프 연결 외에도 더 많은 광 모듈이 다음과 같은 곳에 나타납니다.
- 잎과 가시의 연결
- 더 큰 규모의 스파인-슈퍼 스파인 링크
- 저장 네트워크
- 프런트엔드 또는 통합 네트워크
- 대역 내 관리 네트워크
- 지원 서버 연결
- 데이터센터 인터커넥트
이것이 바로 AI 인프라가 창출하는 광학적 기회를 단순히 GPU 출하량에 1을 곱하는 방식으로 계산할 수 없는 이유입니다.
GPU 개수는 노드 측 고속 포트를 추정하는 데 유용한 출발점을 제공합니다.
광학 부품의 전체 BOM은 전체 원단에 따라 달라집니다.
그리고 신뢰성은 양만큼이나 중요합니다.
광 모듈은 단순히 BOM(자재명세서)의 한 항목이 아닙니다. 신호 무결성, 열 성능, 비트 오류율, 상호 운용성, 링크 안정성 및 장애 복구가 클러스터 활용도에 직접적인 영향을 미칠 수 있는 동기식 분산 시스템의 구성 요소입니다.
100,000만 개의 GPU 규모에서는 링크 안정성이 조금만 떨어져도 운영에 상당한 영향을 미칠 수 있습니다.
동시에, 모든 광 모듈 고장이 전체 클러스터를 자동으로 중단시킨다고 주장하는 것은 과장된 표현입니다. 최신 AI 패브릭과 학습 소프트웨어는 다양한 유형의 오류를 격리하고, 경로를 변경하고, 체크포인트를 설정하고, 복구하도록 설계되었습니다.
그러므로 진정한 엔지니어링 과제는 다음과 같지 않습니다.
광 모듈이 고장날 수 있나요?
그것은:
"시스템이 해당 오류를 충분히 신속하게 감지, 격리 및 복구하여 고가의 GPU가 계속 작동하도록 유지할 수 있습니까?"
자주 묻는 질문
GPT-6 아스트라는 실제로 몇 개의 광 송수신기를 사용했습니까?
정확한 수치는 공개되지 않았습니다.
OpenAI는 Astra가 100,000만 개 이상의 GPU에서 사전 학습되었다고 확인했습니다. 현재 NVIDIA NVL72 레퍼런스 아키텍처에는 GPU당 대략 하나의 고속 확장형 네트워크 포트가 있습니다.
따라서 모든 GPU 연결용 스케일아웃 연결에 개별 플러그형 광 트랜시버를 사용하는 경우 노드 측에서만 약 100,000만 개의 광 모듈이 필요할 수 있습니다.
하지만 이러한 모듈들을 자동으로 800G 모듈이라고 부르는 것은 적절하지 않습니다.
GB200 NVL72는 ConnectX-7 400G 컴퓨팅 네트워크 포트를 사용하고, GB300 NVL72는 ConnectX-8 800G 포트를 사용합니다. 정확한 Astra 하드웨어 구성은 공개되지 않았습니다.
스위치 간 연결, 스토리지 및 기타 네트워크 패브릭을 포함하면 전체 클러스터에는 훨씬 더 많은 광 인터페이스가 필요합니다.
NVL72 랙 내부에 광 트랜시버가 있습니까?
NVLink GPU 간 패브릭 자체는 광 트랜시버를 사용하지 않습니다.
GB200 및 GB300 NVL72 시스템은 NVLink 스위치와 수동 구리 케이블 인프라를 사용하여 NVLink 도메인 내의 72개 GPU를 상호 연결합니다.
하지만 랙에는 시스템을 외부 컴퓨팅, 스토리지 및 관리 네트워크에 연결하는 데 사용되는 ConnectX 및 BlueField 네트워크 인터페이스의 광 모듈이 여전히 포함될 수 있습니다.
GB300 800G 연결이 두 개의 400G 링크로 분할되는 이유는 무엇입니까?
NVIDIA의 GB300 NVL72 레퍼런스 아키텍처는 각 ConnectX-8 800G 포트를 두 개의 400G 링크 로 분할할 수 있습니다.
각 400G 링크는 서로 다른 컴퓨팅 네트워크 평면에 연결됩니다.
이를 통해 총 800G의 대역폭을 제공하는 동시에 패브릭 복원력과 로드 밸런싱 기능을 향상시킬 수 있습니다.
두 경로는 네트워크 측면에서는 분리되어 있지만, GPU, ConnectX-8 어댑터, 그리고 일반적으로 호스트 측 듀얼 포트 800G 광 모듈은 공유합니다.
NVL72는 왜 랙 내부의 GPU 간 NVLink에 광 모듈을 사용하지 않습니까?
현재 NVL72 시스템은 랙 내 NVLink 패브릭에 수동 구리 케이블을 사용하는데, 이는 거리가 짧고 구리 케이블이 전기-광 변환에 필요한 추가적인 전력 소모와 복잡성 없이 매우 높은 대역폭을 제공할 수 있기 때문입니다.
신호가 확장형 데이터센터 네트워크를 통해 더 먼 거리를 이동해야 할 때 광학 기술의 가치가 더욱 높아집니다.
광학 I/O 및 코패키징 광학 장치와 같은 미래 기술은 궁극적으로 이러한 경계를 GPU에 더 가깝게 이동시킬 수 있습니다.
AI 패브릭용 400G 또는 800G 광 트랜시버를 찾고 계십니까?
FiberMall은 ConnectX-7, ConnectX-8, InfiniBand 및 이더넷 스위칭 패브릭과 함께 사용되는 구성을 포함하여 고속 AI 데이터 센터 상호 연결 애플리케이션을 위한 400G 및 800G OSFP 및 QSFP-DD 광 트랜시버를 제공합니다.
대규모 AI 클러스터 구축의 경우, FiberMall은 맞춤형 광 모듈, DAC/AOC, 광섬유 케이블 및 BOM 조달 요구 사항도 지원할 수 있습니다.