
NVLink는 NVIDIA의 고속 칩 간 인터커넥트이며, NVSwitch는 이를 여러 GPU에 걸쳐 확장하는 스위치 패브릭입니다. 이 둘 덕분에 최신 AI 시스템은 수조 개의 매개변수를 가진 모델을 학습하고 제공할 수 있습니다. 이제 단일 GPU 도메인은 72개의 GPU 간에 초당 테라바이트(TB/s) 속도로 데이터를 전송할 수 있는데, 이는 2016년에 출시된 1세대 NVLink가 제공했던 총 대역폭보다 약 800배 더 높은 수치입니다. 이들의 발전은 AI 컴퓨팅 붐의 거의 모든 단계를 궤적해 왔습니다.
이 글에서는 NVLink와 NVSwitch가 세대별로 어떻게 발전해왔는지, GPU 개수가 늘어남에 따라 네트워크 토폴로지가 어떻게 변화했는지, 그리고 각 단계별 대역폭과 케이블 구성은 어떠했는지 설명합니다. 또한 GB300 Blackwell Ultra 세대와 NVLink 6를 지원하는 Vera Rubin 플랫폼을 포함한 2026년 현재 상황도 다룹니다. NVIDIA AI 인프라용 연결 계층을 설계, 구축 또는 구매하는 경우, 마지막 부분에서는 각 NVLink 세대에 실제로 필요한 트랜시버, DAC 케이블 및 광 모듈을 연결하여 보여줍니다.
NVLink와 NVSwitch란 무엇인가요?
NVLink는 NVIDIA에서 GPU 간 및 GPU와 CPU 간 통신을 위해 개발한 와이어 기반 직렬 인터커넥트입니다. PCIe가 멀티 GPU 시스템에서 병목 현상을 일으키면서 NVLink가 개발되었습니다. NVLink를 사용하면 GPU가 메모리를 공유하고 CPU, 호스트 메모리 및 PCIe 버스를 거치지 않고 데이터를 직접 전송할 수 있습니다. 각 NVLink 세대가 출시될 때마다 레인당 속도가 향상되고 GPU당 링크 수가 추가되어 총 대역폭이 1세대 160GB/s에서 NVLink 6의 3.6TB/s까지 증가했습니다.
NVSwitch는 다른 문제를 해결합니다. 직접 NVLink 링크는 GPU를 몇 개의 인접한 GPU와 연결하지만, 수많은 GPU로 구성된 완전 연결 메시는 물리적 링크를 너무 많이 소모하게 됩니다. NVSwitch는 모든 GPU가 NVLink 대역폭을 최대한 활용하여 서로 연결할 수 있는 패브릭을 생성하는 스위치 ASIC입니다. NVIDIA는 2018년 DGX-2와 함께 NVSwitch를 선보였으며, 현재 GB200 NVL72와 같은 랙 규모의 NVLink 도메인은 최대 72개의 GPU를 하나의 대형 GPU처럼 처리합니다.
이 글 전체에 걸쳐 두 가지 용어가 반복적으로 사용되므로 지금 바로 수정해 두는 것이 좋습니다.
- NVLink 도메인NVLink를 통해 일관성 있는 메모리를 공유하고 하나의 논리적 장치처럼 프로그래밍할 수 있는 GPU 그룹.
- NVSwitch 트레이도메인 내의 GPU들을 서로 연결하는 NVSwitch ASIC을 포함하는 하드웨어 모듈.
NVLink 및 NVSwitch 세대별 특징 요약
아래 표는 6세대에 걸친 NVLink의 발전 과정을 정리한 것입니다. GPU별 대역폭은 양방향 총합(송신 + 수신)입니다. NVIDIA의 공식 세대별 사양은 NVLink에 대한 위키피디아 문서에서도 확인할 수 있습니다.
| 세대 | 출간연도 | GPU/아키텍처 | GPU당 링크 수 | GPU당 총 대역폭 | 신호 법 |
| NV링크 1.0 | 2016 | 테슬라 P100 (파스칼) | 4 | 160 GB / 초 | 레인당 20Gb/s |
| NV링크 2.0 | 2017 | 테슬라 V100 (볼타) | 6 | 300 GB / 초 | 레인당 25Gb/s |
| NV링크 3.0 | 2020 | A100(암페어) | 12 | 600 GB / 초 | 레인당 50Gb/s |
| NV링크 4.0 | 2022 | H100 / H200 (호퍼) | 18 | 900 GB / 초 | 레인당 100Gb/s |
| NV링크 5.0 | 2024 | B200 / GB200 / GB300 (블랙웰) | 18 | 1.8 TB / 초 | 레인당 200Gb/s |
| NV링크 6.0 | 2026 | 베라 루빈 | 36까지 | 3.6 TB / 초 | 양방향 SerDes |
신호 방식의 변화는 쉽게 파악할 수 있습니다. 초기 NVLink 세대는 NRZ 인코딩과 비교적 낮은 레인당 전송 속도를 사용했지만, NVIDIA는 NVLink 4.0에서 PAM4 신호 방식으로 전환하면서 레인당 전송 속도를 지속적으로 높였습니다. NVLink 6은 GPU당 링크 수를 최대 36개로 두 배로 늘리고, 1.6T 이더넷 광 모듈에서 사용되는 것과 동일한 고속 전기 신호 방식인 양방향 SerDes를 채택했습니다. 이러한 이유로 NVLink의 물리 계층은 이제 광 트랜시버 산업과 직접적으로 겹치게 되었습니다.
토폴로지 진화: GPU 네트워크의 성장 과정
세대 간 가장 중요한 변화는 단순히 속도가 아니라 토폴로지입니다. 매 세대마다 GPU를 연결하는 방식이 바뀌었습니다.
GPU 간 직접 메시 연결(스위치 없음)
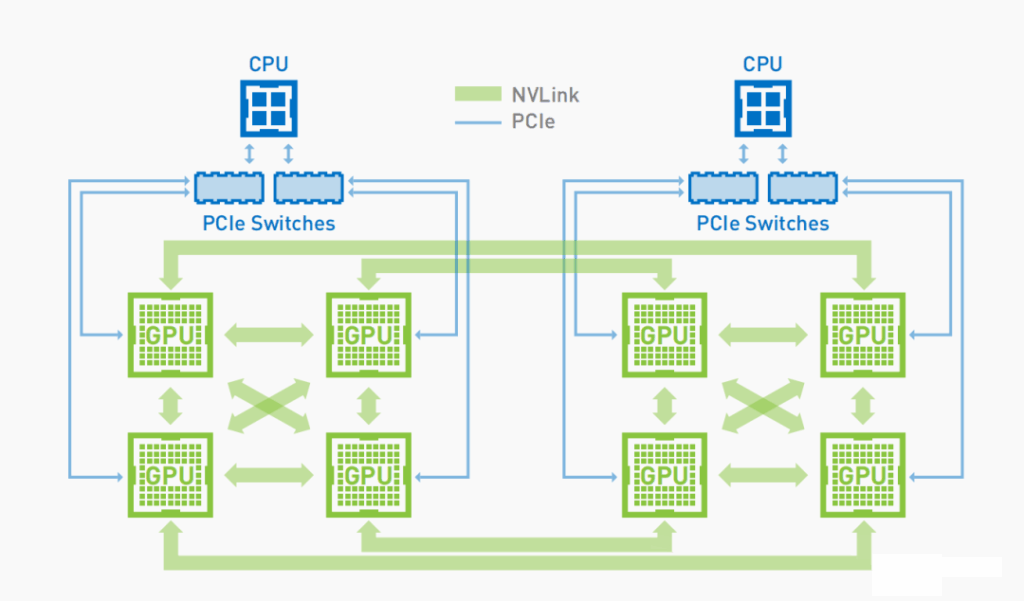
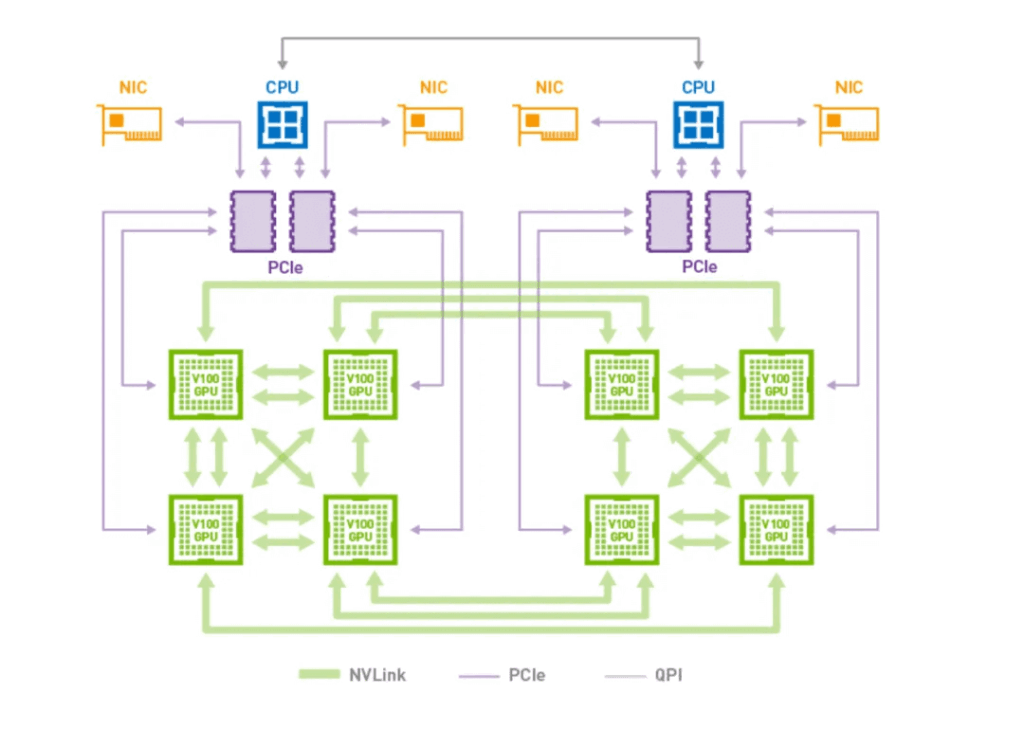
초기 NVLink 제품들은 GPU들을 인접한 GPU에 직접 연결했습니다. Tesla P100과 Volta V100은 각각 최대 4개와 6개의 링크를 인접한 GPU에 연결하여 소규모 메시 네트워크를 형성했습니다. 이 방식은 GPU 수가 적은 시스템에서는 효과적이었지만, GPU가 추가될수록 각 GPU가 더 많은 링크를 처리해야 하므로 확장성이 떨어졌습니다. 8개의 V100 GPU를 탑재한 DGX-1은 스위치 없이 모든 GPU를 연결하는 하이브리드 큐브 메시 방식을 사용했습니다.
최초의 NVSwitch 패브릭(2018)
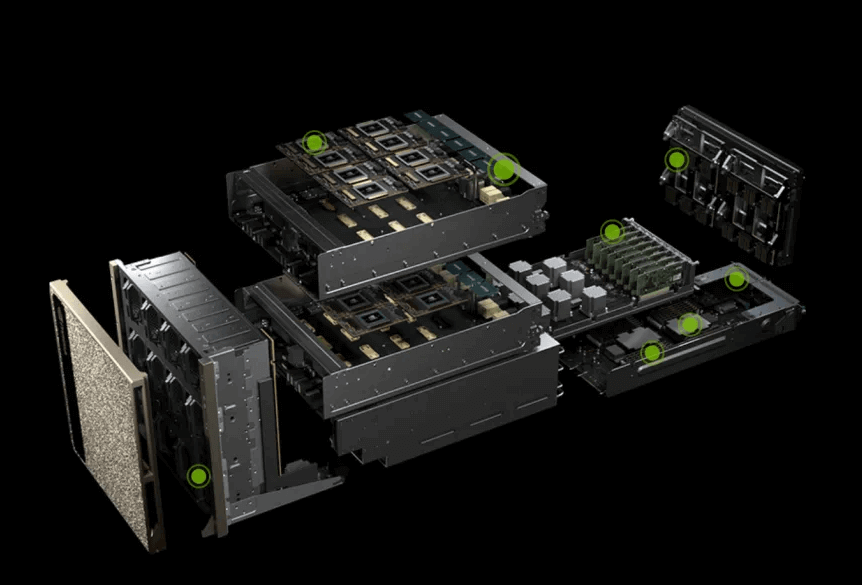
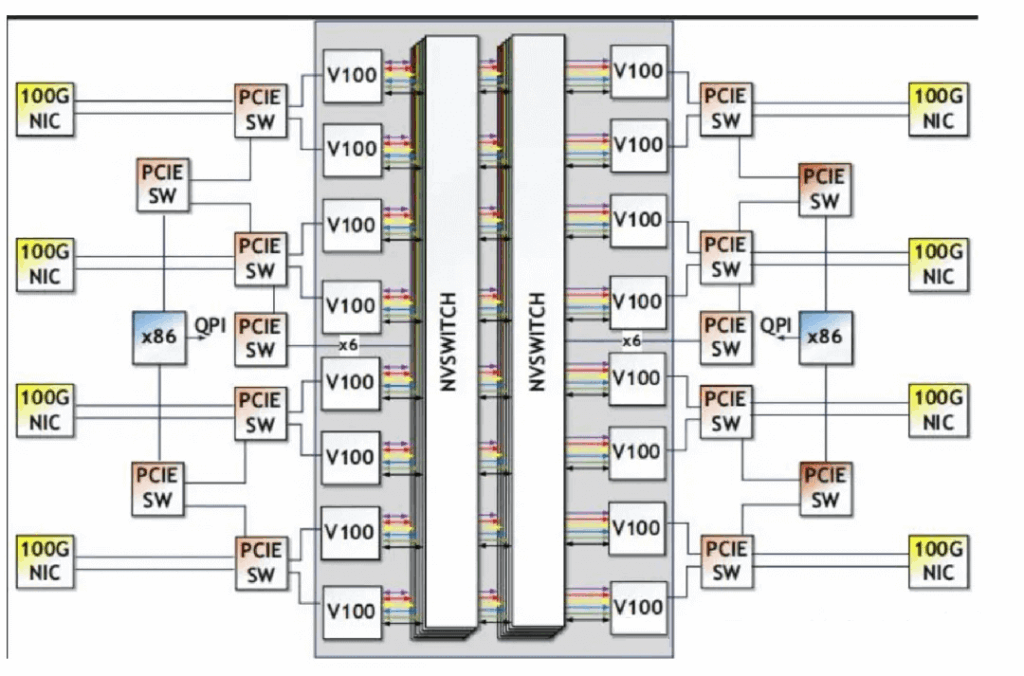
NVIDIA는 2018년 16개의 V100 GPU를 탑재한 DGX-2를 통해 다이렉트 메시의 확장성 한계에 도달했습니다. 모든 GPU를 서로 직접 연결하는 대신, NVIDIA는 NVSwitch를 도입했습니다. DGX-2는 두 개의 베이스보드 각각에 6개의 1세대 NVSwitch ASIC을 탑재했고, 각 GPU는 다른 GPU와 직접 통신하는 대신 스위치 패브릭과 통신했습니다. 그 결과, 모든 GPU 쌍은 최대 NVLink 속도로 통신할 수 있었고, 시스템은 단일 16개 GPU 도메인처럼 작동했습니다.
8개 GPU 표준 영역(2020년~2022년)
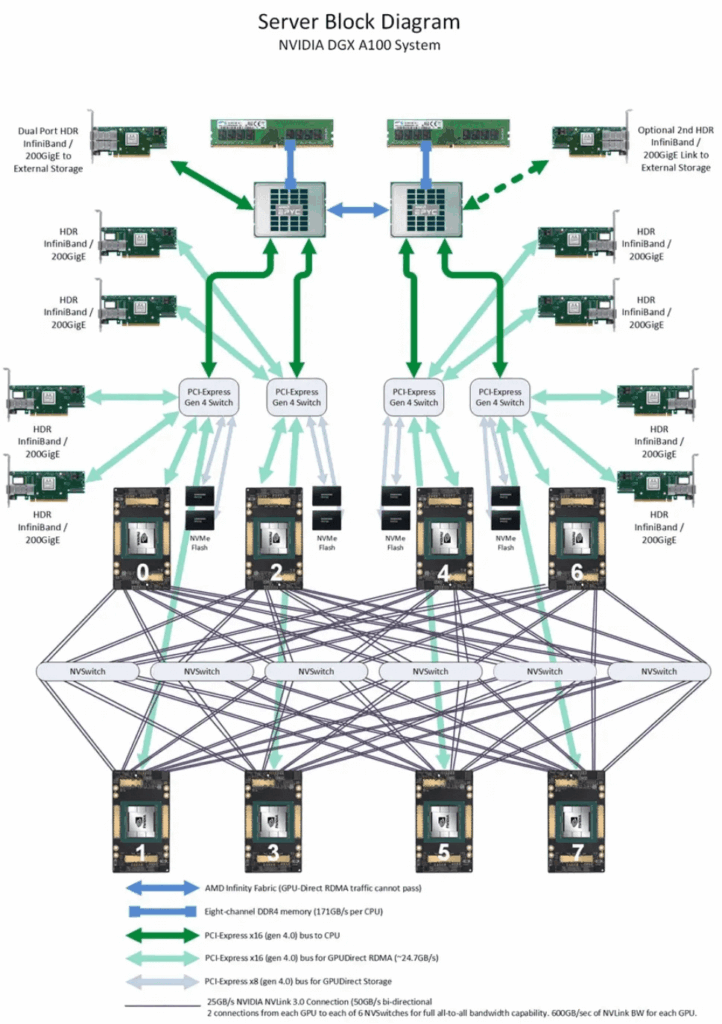
NVIDIA는 A100부터 8개의 GPU로 구성된 빌딩 블록을 표준으로 채택했습니다. DGX A100 시스템은 8개의 A100 GPU와 6개의 2세대 NVSwitch ASIC으로 연결되어, 모든 GPU가 600GB/s의 속도로 다른 모든 GPU와 통신할 수 있는 풀 메시 도메인을 구성합니다. DGX H100은 4개의 3세대 NVSwitch 칩을 사용하여 동일한 구성을 구현했으며, 각 H100은 패브릭에 대해 최대 900GB/s의 속도를 유지합니다.
랙 스케일 전체 도메인 간 통신(2024)
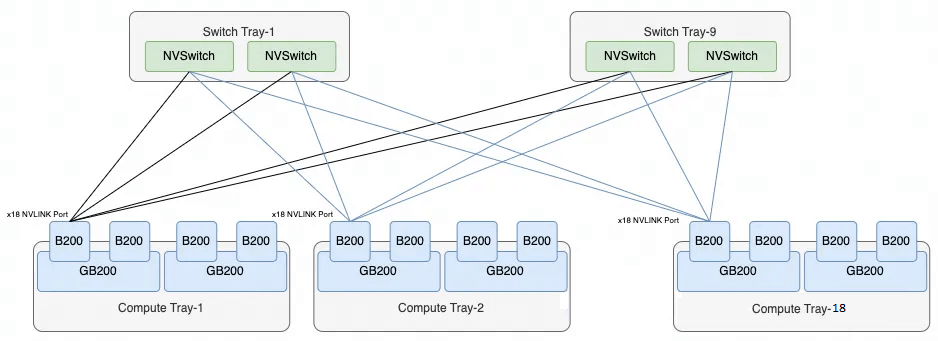
블랙웰 세대는 규모의 기준을 다시 한번 바꾸어 놓았습니다. GB200 NVL72 랙에는 72개의 GPU와 36개의 Grace CPU를 장착할 수 있으며, 9개의 NVSwitch 트레이를 통해 72개의 GPU로 구성된 NVLink 도메인을 생성할 수 있습니다. 랙에 있는 각 GPU는 다른 모든 GPU와 1.8TB/s의 속도로 통신하며, 전체 패브릭은 약 130TB/s의 속도를 제공합니다. NVIDIA는 동일한 72개 GPU 도메인을 두 가지 물리적 구성으로 제공합니다. 하나는 단일 랙 구성의 NVL72이고, 다른 하나는 1.6TB OSFP 링크로 연결된 두 개의 캐비닛에 도메인을 분산시키는 2랙 구성의 NVL36x2입니다.
하나의 랙을 넘어선 외부 NVLink 도메인
NVLink는 랙 경계에 얽매이지 않습니다. NVIDIA는 각각 두 개의 NVSwitch 칩을 탑재하고 OSFP 케이지를 제공하는 1U 크기의 외부 NVLink 스위치 모듈을 판매하여, 운영자가 8개 또는 72개의 GPU 도메인을 연결하여 더 큰 규모의 패브릭을 구성할 수 있도록 합니다. DGX H100 세대에서는 외부 NVLink 스위치를 통해 최대 256개의 GPU를 연결하고 총 57.6TB/s의 대역폭을 제공했습니다. Blackwell 세대에서는 외부 NVLink 스위치를 사용하여 NVL72 랙을 연결함으로써 하나의 랙에 수용할 수 없는 모델까지 더 큰 규모의 NVLink 도메인을 구성할 수 있습니다. 이러한 확장형 패브릭은 가장 크고 비용이 많이 드는 광 연결이 필요한 영역입니다.
NVLink와 NVSwitch의 진화
2016년: 파스칼과 테슬라 P100, 1세대 NVLink
NVIDIA는 2014년에 NVLink를 처음 발표했으며, 이 기술은 2016년 파스칼 아키텍처 기반의 Tesla P100에 적용되었습니다. NVLink 1.0은 P100에 양방향 총합 160GB/s의 대역폭을 가진 4개의 링크를 제공했는데, 이는 PCIe 3.0 x16 슬롯의 약 5배에 달하는 대역폭이었습니다. 덕분에 PCIe 버스가 병목 현상을 일으키지 않고도 4개 또는 8개의 GPU를 사용하는 구성이 가능해졌습니다. 당시에는 NVSwitch가 없었기 때문에 GPU들은 서로 직접 통신했습니다.
2017년: 볼타 및 테슬라 V100, 2세대 NVLink
2017년 볼타(Volta) 기반의 테슬라 V100은 인터커넥트 성능을 두 배로 향상시켰습니다. NVLink 2.0은 각 V100에 6개의 링크를 제공하여 300GB/s의 양방향 대역폭을 구현했습니다. V100 GPU를 탑재한 DGX-1은 하이브리드 메시를 사용하여 최대 8개의 GPU로 확장 가능했으며, NVLink는 처음으로 서로 다른 PCIe 스위치에 있는 GPU를 지원하여 단일 일관성 메모리 공간이 전체 노드에 걸쳐 존재할 수 있도록 했습니다.
2018년: DGX-2와 최초의 NVSwitch
16개의 GPU를 탑재한 DGX-2는 NVSwitch의 등장을 알렸습니다. 각 베이스보드에는 6개의 1세대 NVSwitch ASIC이 탑재되어 GPU들을 연결했으며, 스위치 패브릭을 통해 시스템 내의 모든 GPU가 NVLink의 최대 속도로 데이터를 교환할 수 있었습니다. 이는 이후 출시된 모든 NVIDIA 시스템의 토폴로지가 되었습니다. NVSwitch는 지점 간 링크로 이루어진 네트워크를 진정한 스위치 패브릭으로 전환시켰습니다.
2020년: 암페어 및 A100, 3세대 NVLink
A100 세대는 8개의 GPU 도메인을 표준화했습니다. NVLink 3.0은 각 A100에 600GB/s의 양방향 대역폭을 위한 12개의 링크를 제공했으며, DGX A100에 탑재된 2세대 NVSwitch 칩은 8개의 GPU를 풀 메시 도메인으로 연결했습니다. A100과 NVSwitch를 탑재한 HGX 베이스보드는 서버 제조업체들이 기반으로 삼는 레퍼런스 디자인이 되었으며, 호스트 서버가 PCIe를 통해 연결하는 모듈이기도 합니다.
2022년: Hopper 및 H100, 4세대 NVLink
H100에 탑재된 NVLink 4.0은 PAM4 시그널링을 최초로 사용하여 레인당 속도를 100Gb/s까지 향상시켰고, 각 H100은 18개의 링크를 통해 총 900Gb/s의 속도를 제공하여 PCIe 5.0 x16 슬롯의 약 14배에 달하는 성능을 구현했습니다. 3세대 NVSwitch 칩은 SHARP 인네트워크 리듀스 엔진을 패브릭에 도입하여 모든 리듀스(all-reduce)와 같은 집합 연산을 스위치 내부에서 실행할 수 있도록 했습니다. 더 큰 규모의 클러스터를 위해 NVIDIA는 DGX H100 SuperPOD처럼 최대 256개의 GPU 도메인을 구축할 수 있는 외부 NVLink 스위치 모듈을 출시했습니다.
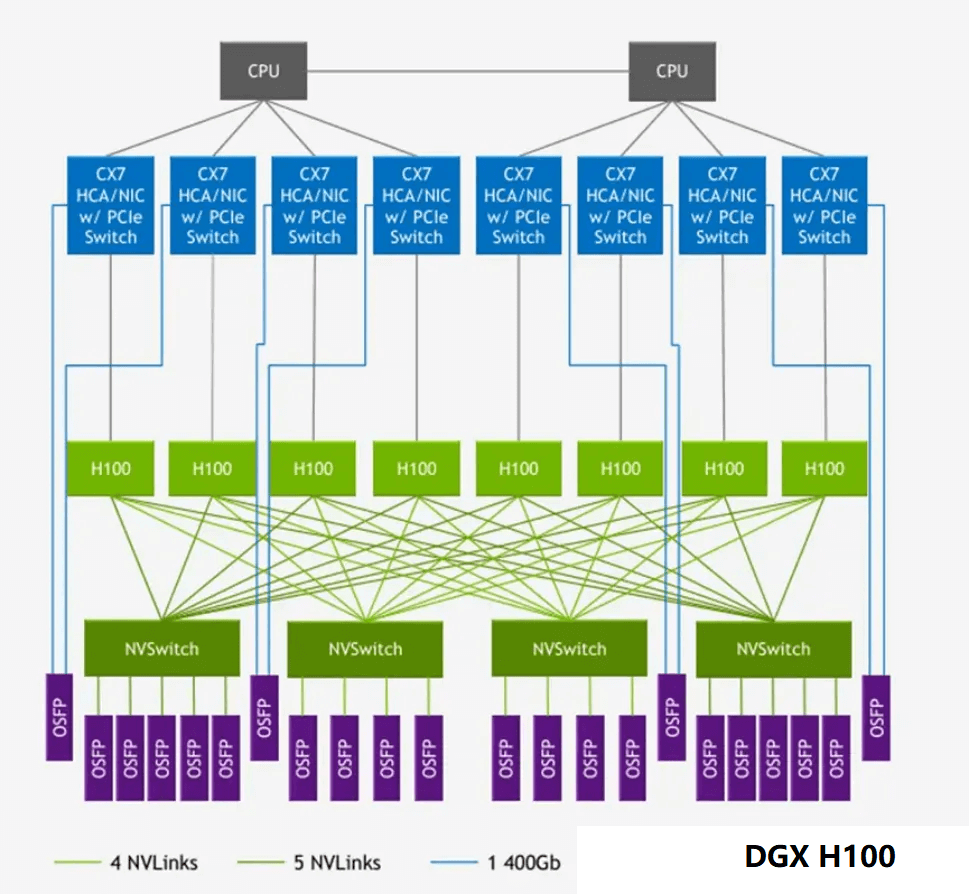
2024년: Blackwell B200, 5세대 NVLink
블랙웰 세대는 NVLink를 노드 인터커넥트에서 랙 인터커넥트로 전환했습니다. NVLink 5.0은 각 B200에 1.8개의 링크를 통해 18TB/s의 속도를 제공하며, GB200 NVL72 랙은 약 130TB/s의 패브릭 대역폭을 가진 단일 72개 GPU 도메인을 구성합니다. NVIDIA는 NVSwitch도 지속적으로 개선했습니다. 각 NVL72 스위치 트레이에는 차세대 NVSwitch ASIC이 두 개 탑재되어 있으며, 도메인은 캐비닛 내부의 구리 케이블을 사용하면서도 전체 랙에 걸쳐 확장됩니다.
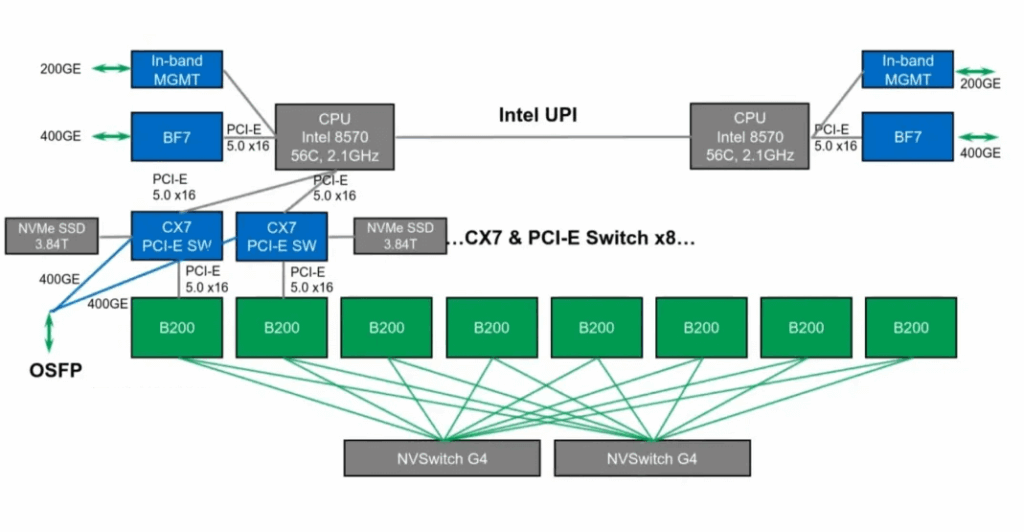
2025년부터 2026년까지: GB300 블랙웰 울트라
블랙웰 울트라(GB300 세대)는 2026년까지 주력 플랫폼으로 자리 잡을 예정입니다. B300 GPU는 메모리를 288GB의 HBM3e로 확장하고 NVL72 랙의 전력 소비를 약 132kW까지 끌어올렸으며, 스케일아웃 네트워크는 800G ConnectX-8 네트워크 카드로 업그레이드되었습니다. NVLink 자체는 300세대 기술을 유지하지만, 랙 설계의 핵심 요소인 구리 및 광 분리 방식을 도입했습니다. 즉, 랙 내부에는 구리 NVLink를 사용하고, 거리가 멀어질수록 광 링크를 사용합니다.
2026년: 베라 루빈, 6세대 NVLink
베라 루빈(Vera Rubin) 플랫폼은 NVLink 6.0을 지원합니다. NVIDIA가 2025년에 발표하고 2026년 초까지 상세 내용을 공개한 NVLink 6는 GPU당 최대 3.6개의 링크를 통해 GPU 대역폭을 36TB/s로 두 배로 늘리고, 함께 출시되는 NVSwitch는 랙 규모의 패브릭 대역폭을 약 260TB/s까지 향상시킵니다. 첫 번째 플래그십 시스템인 베라 루빈 NVL144는 2026년 하반기에 출시될 예정이며, 루빈 울트라(NVL576)는 광학 모듈이 함께 패키징된 형태로 출시될 예정입니다. 현재 케이블과 광학 모듈을 구매하는 사람이라면 NVLink 6 시스템이 패브릭 대역폭의 상당 부분을 고속 광케이블과 액티브 전기 케이블로 전환하기 때문에 이 전환기를 주목해야 합니다.
NVLink와 PCIe의 대역폭 비교
NVLink의 속도는 NVLink가 우회하도록 설계된 범용 버스인 PCIe와 비교하면 더 쉽게 이해할 수 있습니다. 아래 표는 양방향 속도를 기준으로 작성되었습니다.
| 상호 연결 | 일반적인 최대 양방향 대역폭 | 직위별 |
| PCIe 4.0 x16 | ~ 64GB/초 | 일반 용도 I/O |
| PCIe 5.0 x16 | ~ 128GB/초 | 일반 용도 I/O |
| NVLink 3.0(A100) | GPU당 600GB/s | 노드 내 스케일업 |
| NVLink 4.0 (H100) | GPU당 900GB/s | 노드 내 스케일업 |
| NVLink 5.0 (B200) | GPU당 1.8TB/s | 랙 내에서 스케일업 |
| NVLink 6.0 (루빈) | GPU당 3.6TB/s | 랙 전반에 걸친 확장 |
실질적인 결과는 텐서 병렬 처리 및 기타 모델 병렬 패턴이 NVLink에 의존한다는 것입니다. GPU가 매 학습 단계마다 가중치 기울기를 교환해야 할 때, NVLink 도메인은 PCIe보다 훨씬 빠른 속도로 해당 트래픽을 처리하므로 대규모 모델 학습에 NVLink가 필수적인 이유입니다.
AI 및 HPC에서 NVLink와 NVSwitch가 중요한 이유
모든 주요 AI 클러스터가 NVLink 및 NVSwitch에 의존하는 이유는 다음 세 가지 기능으로 설명할 수 있습니다.
- 일관성 있는 공유 메모리. NVLink 도메인 내의 GPU는 통합된 메모리 공간을 공유하므로 소프트웨어는 메시지 전달을 관리하는 대신 여러 가속기를 하나의 큰 장치처럼 처리할 수 있습니다.
- 거의 선형적인 규모 확장. 스위치 패브릭은 모든 GPU 쌍에 최대 대역폭을 제공하므로 링 또는 메시 구성과 달리 GPU를 추가해도 통신 속도가 저하되지 않습니다.
- 직물 내 가속도. 최신 NVSwitch 세대는 집단 운영 환경에서 네트워크 트래픽을 줄이거나 없애 수백 개의 GPU 간 동기화에 소요되는 시간을 단축합니다.
설계상의 절충점은 이러한 고성능에는 물리적 제약이 따른다는 것입니다. NVLink 대역폭이 GPU당 900GB/s를 넘어서면서 신호 무결성과 도달 거리가 설계에 중요한 요소가 되는데, 바로 다음 섹션에서 다룰 케이블 및 광학 장치 관련 결정이 여기서 비롯됩니다.
케이블 및 연결: NVLink GPU 도메인에 필요한 사항
네트워크 설계자와 구매자에게 NVLink 이야기의 흥미로운 부분은 물리 계층입니다. 세대가 바뀔 때마다 패브릭에 사용되는 구리 및 광 제품의 종류가 바뀌었기 때문입니다. 바로 이 부분에서 NVLink와 NVIDIA 호환 트랜시버 및 케이블 포트폴리오인 FiberMall이 연결됩니다.
랙 내장형 NVLink: 구리 케이블의 승리
NVIDIA는 단일 랙 내부에서 NVLink에 가능한 모든 곳에 구리 케이블을 사용합니다. GB200 NVL72는 캐비닛 후면에 구리 NVLink 케이블을 사용하여 광 링크에 비해 랙당 약 20kW의 전력을 절감하고 지연 시간을 낮춥니다. 이러한 구리 케이블은 고속 이중 축 케이블(기본적으로 대형 DAC 어셈블리)로, 컴퓨팅 트레이와 NVSwitch 트레이에 연결됩니다. NVLink에서 구리 케이블이 주로 사용되는 이유는 전송 거리가 짧고(몇 미터 미만) 전력 절감 효과가 크기 때문입니다.
랙 투 랙 NVLink: 광학 및 AEC
NVLink가 랙 사이를 연결하면 구리 케이블로는 더 이상 연결할 수 없습니다. 예를 들어 GB200 NVL36x2는 72개의 GPU로 구성된 하나의 도메인을 두 개의 랙에 분산시키고, NVSwitch 트레이는 1.6T OSFP 케이지를 통해 두 랙을 연결합니다. 이러한 링크는 실제 NVLink 트래픽을 전송하므로 고성능 OSFP 광 모듈 또는 1.6T 액티브 전기 케이블(AEC)과 저손실 케이블이 필요합니다. 랙들을 연결하여 더 큰 도메인을 구성하는 외부 NVLink 스위치 네트워크에도 동일하게 적용됩니다.
확장형 네트워킹: 인피니밴드 및 이더넷
NVLink 스케일업과 더불어 모든 NVIDIA 클러스터는 작업, 스토리지 및 멀티랙 트래픽을 위한 스케일아웃 네트워크를 갖추고 있습니다. DGX H100 시스템은 400G ConnectX-7 InfiniBand를 사용하고, GB300은 800G ConnectX-8로 전환되며, 패브릭은 Quantum-X800(InfiniBand) 또는 Spectrum-X800(이더넷) 스위치를 기반으로 구축됩니다. 이 계층은 NVIDIA 호환 400G 및 800G OSFP 모듈과 QSFP-DD 광 모듈이 네트워크 카드에 연결되는 부분입니다.
실용적인 선택 가이드
| 원단층 | 일반적인 링크 | 권장 연결 상태 |
| 랙 내장형 NVLink(NVL72) | Copper NVLink | 고속 DAC 케이블, 짧은 구리선 |
| 랙 간 NVLink(NVL36x2) | 1.6톤 OSFP 케이지 | 800G OSFP 광 모듈 또는 트윈 포트 DAC/AEC |
| 외부 NVLink 도메인 | NVLink 스위치의 OSFP | OSFP 광 모듈, MPO 광섬유 트렁크 |
| 스케일아웃 인피니밴드(GB300) | 800G 커넥트X-8 | 800G OSFP SR8/DR8 트랜시버, NDR DAC |
FiberMall은 이러한 링크에 최적화된 NVIDIA 호환 모듈을 제공합니다. 800G OSFP SR8 모듈은 단거리 NVLink 및 스케일아웃 패브릭에 사용되며, 800G OSFP 플랫탑 제품군은 DR8 싱글모드 연결을 지원하고, 800G NDR DAC 케이블은 랙 내부의 짧은 구리 홉 연결에 적합합니다. 랙 간 연결 및 외부 NVLink 도메인의 경우, 트윈 포트 OSFP 브레이크아웃 DAC와 MPO 광섬유 트렁크가 실용적인 구성 요소입니다. NVIDIA가 NVLink 스케일업과 이더넷 스케일아웃 아키텍처를 어떻게 구분하는지, 그리고 스케일아웃 패브릭에 필요한 구리 및 OSFP 제품은 무엇인지 자세히 알아보려면 400G NDR 스플리터 케이블 및 800G OSFP 구리 케이블 분석을 참조하십시오.
핵심은 다음과 같습니다. 거리가 짧고 전력 소모가 적은 경우에는 NVLink를 구리 케이블로 유지하고, 도달 거리나 밀도가 필요한 경우에는 광 케이블로 전환하며, 800G 및 1.6T OSFP를 미래 표준으로 간주하여 GB300 및 Vera Rubin 세대까지 케이블을 호환되도록 해야 합니다.
NVLink Fusion과 광학의 미래
NVLink의 다음 주요 변화는 광 연결입니다. NVIDIA는 2025년에 NVLink Fusion을 도입했는데, 이는 단일 NVLink 도메인이 캐비닛 가장자리에서 끝나지 않고 여러 랙에 걸쳐 연결될 수 있도록 광 인터커넥트를 통해 NVLink를 확장하는 방식입니다. NVLink Fusion은 코패키징된 광 모듈과 고속 광 모듈을 사용하여 GPU 랙 사이의 더 먼 거리에서도 NVLink 트래픽을 전송합니다. 이는 도메인 규모가 하나의 랙 용량을 초과할 때 매우 중요합니다.
광 산업계에 있어 이는 시장의 직접적인 확장을 의미합니다. 모든 NVLink Fusion 링크와 광 통신을 사용하는 차세대 NVSwitch 트레이는 800G 및 1.6T 이더넷에서 이미 사용되는 것과 동일한 등급의 트랜시버, AEC(Adaptive Enhancement Center), 그리고 구조화된 케이블을 필요로 합니다. NVIDIA의 NVLink Fusion 관련 개발자 자료에서는 NVLink Fusion을 확장형 네트워킹을 더욱 유연하게 만들어주는 방법으로 설명하며, 운영자에게 NVLink의 저지연 메모리 시맨틱스와 광 네트워크의 활용 범위를 제공한다고 강조합니다. 로드맵에서 Rubin Ultra(NVL576)와 그와 함께 패키징된 광 모듈은 NVLink와 광 네트워킹이 융합되고 있음을 가장 명확하게 보여주는 신호이며, FiberMall의 광 기술 전문성은 바로 이러한 전환을 위해 구축되었습니다. 이러한 시스템이 의존하는 고밀도 상호 연결 아키텍처에 대한 자세한 내용은 당사의 데이터 센터 상호 연결 가이드를 참조하십시오.
자주 묻는 질문
NVLink란 무엇인가요?
NVLink는 NVIDIA의 고속 GPU 칩 간 연결 기술입니다. PCIe보다 훨씬 높은 대역폭으로 GPU를 서로 연결하고 CPU와도 연결하여, 일관성 있는 공유 메모리와 직접적인 P2P(Peer-to-Peer) 데이터 전송을 가능하게 합니다. NVLink는 Tesla P100의 160GB/s에서 Vera Rubin의 GPU당 3.6TB/s까지 6세대에 걸쳐 발전해 왔습니다.
NVSwitch란 무엇인가요?
NVSwitch는 NVIDIA의 NVLink용 스위치 ASIC입니다. 이를 통해 도메인 내의 모든 GPU가 NVLink 대역폭을 최대한 활용하여 다른 모든 GPU와 연결할 수 있는 올투올 패브릭을 구축합니다. NVIDIA는 2018년 DGX-2와 함께 NVSwitch를 처음 선보였으며, 현재는 8개의 GPU로 구성된 소규모 GPU 도메인부터 72개의 GPU를 지원하는 GB200 NVL72와 같은 대규모 랙까지 확장 가능합니다.
NVLink 6의 속도는 얼마나 빠릅니까?
NVLink 6는 GPU당 3.6TB/s의 양방향 대역폭을 제공하며, 이는 블랙웰 세대의 NVLink 5의 1.8TB/s보다 두 배 높은 수치입니다. GPU당 최대 36개의 링크를 지원하며, 베라 루빈 플랫폼에 처음 탑재됩니다. 베라 루빈 플랫폼의 NVL144 시스템은 2026년 하반기에 출시될 예정입니다.
NVLink와 PCIe의 차이점은 무엇인가요?
NVLink는 GPU 전용 인터커넥트로, GPU당 대역폭이 테라바이트/초 단위로 측정됩니다. 반면 PCIe는 범용 I/O 버스로, x16 슬롯 기준 최대 64~128GB/s의 속도를 제공합니다. NVLink는 GPU 간 트래픽 처리 시 CPU와 호스트 메모리를 우회하므로 대규모 모델 학습에 필수적입니다.
NVLink는 구리 케이블을 사용하나요, 아니면 광 케이블을 사용하나요?
둘 다 가능합니다. NVLink는 랙 내부에서 구리 케이블을 사용하여 작동하며, GB200 NVL72의 경우 구리 케이블을 사용하면 캐비닛당 약 20kW의 전력을 절감할 수 있습니다. NVLink는 1.6T OSFP 광 모듈과 액티브 전기 케이블을 통해 랙 간 연결을 제공하며, NVIDIA의 NVLink Fusion 로드맵은 광 인터커넥트를 통해 NVLink를 더욱 많은 랙에 걸쳐 확장할 계획입니다.
NVL72 랙에는 어떤 케이블이 필요합니까?
NVL72 랙에는 캐비닛 내부의 컴퓨팅 트레이와 NVSwitch 트레이 사이에 짧고 빠른 구리 NVLink 케이블이 필요하며, 랙 간 및 스케일아웃 링크를 위해 800G OSFP 광 모듈과 DAC 또는 AEC 케이블도 필요합니다. FiberMall은 이러한 모든 요구 사항에 맞는 NVIDIA 호환 옵션을 제공합니다.
맺음말
NVLink와 NVSwitch는 2016년 4링크 GPU 인터커넥트에서 시작하여 72개의 GPU를 하나의 장치처럼 연결하는 랙 규모의 패브릭으로 발전했으며, 현재 로드맵은 광 모듈을 통해 NVLink를 랙 전체로 확장하는 것을 목표로 합니다. 이러한 세대별 발전 과정을 이해하면 오늘날 더 나은 구매 결정을 내리는 데 도움이 됩니다. 핵심 사항은 다음과 같습니다.
- NVLink 대역폭은 1.0년 만에 GPU당 160GB/s(NVLink 1.0, P100)에서 3.6TB/s(NVLink 6, Vera Rubin)로 약 22배 증가했습니다.
- 토폴로지가 직접적인 GPU 메시에서 NVSwitch 패브릭, 8개 GPU 도메인, 랙 규모의 NVL72 도메인, 그리고 랙에 걸쳐 있는 외부 NVLink 네트워크로 변경되었습니다.
- 물리적 계층은 랙 내 구리 NVLink와 랙 간 및 스케일아웃 트래픽을 위한 광 링크로 나뉘는데, 바로 이 부분에서 800G 및 1.6T OSFP 연결이 중요합니다.
- Vera Rubin의 NVLink 6 및 NVLink Fusion은 차세대 기술이며, 800G 및 1.6T용 광 모듈을 계획하면 GB300을 거쳐 Rubin까지 케이블 투자 비용을 보호할 수 있습니다.
NVIDIA GPU 클러스터용 연결 계층을 찾고 계신다면 FiberMall에서 NVIDIA 호환 OSFP 모듈 및 케이블을 살펴보세요. 스위치, 네트워크 카드 및 NVLink 패브릭에 맞는 모듈을 찾는 데 도움이 필요하시면 FiberMall 질문 페이지에서 엔지니어에게 문의하십시오.
관련 상품:
-
 NVIDIA MMA4Z00-NS400 호환 400G OSFP SR4 플랫 탑 PAM4 850nm 30m on OM3/50m on OM4 MTP/MPO-12 다중 모드 FEC 광 트랜시버 모듈
$400.00
-
NVIDIA MMA4Z00-NS-FLT 호환 800GBASE 2 x SR4/SR8 OSFP RHS/플랫탑 PAM4 850nm 100m DOM 듀얼 MPO-12 MMF 광 트랜시버 모듈
$600.00
-
NVIDIA MMA4Z00-NS 호환 800GBASE 2 x SR4/SR8 OSFP PAM4 850nm 100m DOM 듀얼 MPO-12 MMF 광 트랜시버 모듈
$550.00
-
NVIDIA MMS4X00-NM 호환 800GBASE 2 x DR4/DR8 OSFP IHS/폐쇄형 핀탑 PAM4 1310nm 500m DOM 듀얼 MTP/MPO-12 SMF 광 트랜시버 모듈
$600.00
-
NVIDIA MMS4X00-NM-FLT 호환 800GBASE 2 x DR4/DR8 OSFP 플랫탑 PAM4 1310nm 500m DOM 듀얼 MTP/MPO-12 SMF 광 트랜시버 모듈
$650.00
-
NVIDIA MMS4X00-NS400 호환 400G OSFP DR4 플랫 탑 PAM4 1310nm MTP/MPO-12 500m SMF FEC 광 트랜시버 모듈
$450.00
-
NVIDIA(Mellanox) MMA1T00-HS 호환 200G Infiniband HDR QSFP56 SR4 850nm 100m MPO-12 APC OM3/OM4 FEC PAM4 광 트랜시버 모듈
$139.00
-
NVIDIA MFP7E10-N010 호환 10m(33ft) 8 섬유 낮은 삽입 손실 암-암 MPO 트렁크 케이블 극성 B APC-APC LSZH 다중 모드 OM3 50/125
$47.00
-
NVIDIA MCP7Y00-N003-FLT 호환 3m(10피트) 800G 트윈 포트 OSFP - 2x400G 플랫 탑 OSFP InfiniBand NDR 브레이크아웃 DAC
$260.00
-
NVIDIA MCP7Y70-H002 호환 2m(7피트) 400G 트윈 포트 2x200G OSFP - 4x100G QSFP56 패시브 브레이크아웃 직접 연결 구리 케이블
$155.00
-
NVIDIA MCA4J80-N003-FTF 호환 3m(10피트) 800G 트윈 포트 2x400G OSFP - 2x400G OSFP InfiniBand NDR 활성 구리 케이블, 한쪽 끝은 평면 상단, 다른 쪽 끝은 핀형 상단
$600.00
-
NVIDIA MCP7Y10-N002 호환 가능한 2m(7피트) 800G InfiniBand NDR 트윈 포트 OSFP - 2x400G QSFP112 브레이크아웃 DAC
$190.00