
O maior treinamento da OpenAI até hoje utilizou mais de 100,000 GPUs em sua infraestrutura Stargate, no Texas. Todo mundo está comparando o desempenho do GPT-6 Astra. Bem menos gente está perguntando que tipo de rede foi necessária para conectar um cluster de GPUs de seis dígitos.
A resposta é mais complexa do que simplesmente dizer "100,000 GPUs equivalem a 100,000 módulos ópticos 800G".
A quantidade de GPUs é pública. A configuração exata do hardware e a lista de materiais ópticos não são.
Para entender o que a infraestrutura de IA em escala Astra pode exigir das interconexões ópticas, precisamos separar o que a OpenAI e a NVIDIA de fato divulgaram do que pode ser calculado usando as arquiteturas de referência da NVIDIA e da Cisco.
100,000 GPUs — Não 100,000 sistemas
Na última quinta-feira, a OpenAI lançou o GPT-6 Astra. Alguns dias depois, o CEO da NVIDIA, Jensen Huang, publicou sobre o lançamento, escrevendo que o Astra havia sido treinado em aproximadamente "mais de 100 mil" GPUs NVIDIA Grace Blackwell NVLink72 e que outras 400,000 mil GPUs estavam sendo disponibilizadas.
A redação gerou alguma confusão porque “NVL72” descreve um sistema em escala de rack contendo 72 GPUs Blackwell, e não uma GPU individual.
O próprio relatório da OpenAI fornece a resposta mais clara.
Aidan Clark, vice-presidente de pesquisa da OpenAI, disse a repórteres que o Astra representou o maior treinamento já realizado pela empresa e marcou a primeira vez que a OpenAI pré-treinou um modelo em mais de 100,000 GPUs em seu centro Stargate, no Texas.
Portanto, o número principal deve ser interpretado como:
Mais de 100,000 GPUs — não 100,000 racks NVL72.
Se todas as 100,000 GPUs fossem mapeadas em sistemas NVL72 totalmente populados com 72 GPUs, o equivalente teórico seria:
100,000 ÷ 72 ≈ 1,389 racks NVL72
ou aproximadamente 1,400 racks NVL72 completos.
Isso deve ser tratado como um cálculo equivalente em racks, e não como uma contagem física confirmada de racks. A OpenAI não divulgou publicamente a combinação exata de GB200, GB300 ou outros sistemas da Grace Blackwell usados no cluster de treinamento Astra.
Escala de Treinamento Astra
| métrico | Escala aproximada |
| GPUs usadas para o pré-treinamento do Astra | 100,000+ |
| Equivalente completo ao rack NVL72 | ~ 1,400 |
| GPUs por rack NVL72 | 72 |
| GPUs adicionais mencionadas por Jensen Huang | 400,000 |
Figura 1. Configuração do rack NVIDIA NVL72
Um rack NVL72 completo contém 72 GPUs Blackwell conectadas por meio do NVIDIA NVLink. A topologia exata de implantação do Astra não foi divulgada publicamente, portanto, o valor de aproximadamente 1,400 racks deve ser entendido como um cálculo equivalente, e não como um inventário confirmado do local.
Dentro do rack — Zero módulos ópticos na estrutura NVLink
Isso pode parecer contraintuitivo, mas é uma das distinções mais importantes na infraestrutura de IA em escala de rack.
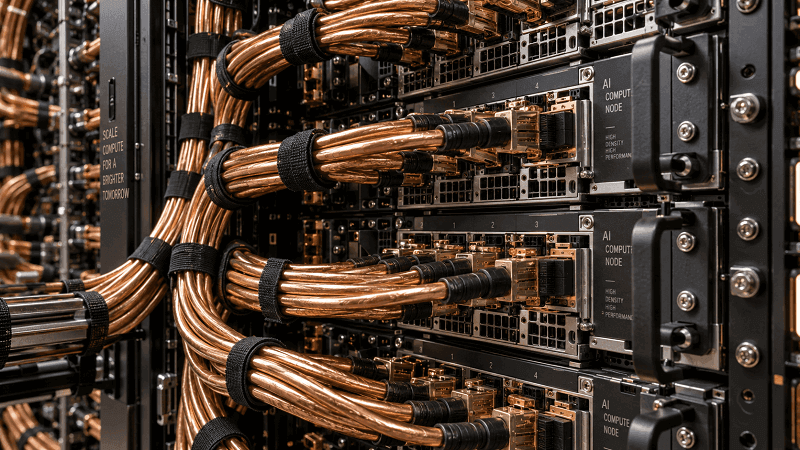
Nos sistemas NVIDIA GB200 e GB300 NVL72, as 72 GPUs comunicam-se através de uma estrutura NVIDIA NVLink, utilizando switches NVLink e um backplane de cabos de cobre passivos.
O domínio NVLink GPU-para-GPU em si não requer transceptores ópticos conectáveis.
Isso não significa que um rack NVL72 não contenha módulos ópticos em nenhum lugar. Transceptores ópticos podem ser instalados nas interfaces de rede ConnectX ou BlueField usadas para conectar o rack a redes externas de computação, armazenamento e gerenciamento.
A distinção é:
Malha de expansão NVLink dentro do rack: cobre
Matriz de computação escalável entre racks: interfaces de rede de alta velocidade que podem usar transceptores ópticos.
O cobre é uma opção viável para curtas distâncias dentro de um rack, pois evita a conversão desnecessária de sinal elétrico para óptico, ao mesmo tempo que oferece largura de banda extremamente alta e consumo de energia relativamente baixo para conexões de curto alcance.
Quando o tráfego precisa sair do rack e percorrer o cluster de IA maior, a conectividade óptica torna-se cada vez mais importante, pois a fibra suporta maior alcance, alta densidade de portas e topologias de rede em larga escala com mais eficiência.
A fronteira que importa
Aumento da escalabilidade de GPUs dentro do mesmo rack: NVLink sobre infraestrutura passiva de cobre.
Escalabilidade horizontal de GPUs entre racks: interfaces de rede ConnectX conectadas por meio de InfiniBand ou Ethernet, normalmente usando links ópticos de alta velocidade em grandes implantações.
Essa fronteira é importante hoje, mas não deve ser tratada como permanente. Tecnologias como óptica co-embalada, óptica próxima ao pacote e E/S óptica podem eventualmente aproximar a conectividade óptica do pacote de computação.
Fora do rack — Aproximadamente uma porta de rede do lado do nó por GPU
É daí que vem a ideia original de "uma GPU, um módulo óptico", mas existe uma importante distinção geracional.
GB200 NVL72: 400G por GPU
A arquitetura DGX GB200 NVL72 da NVIDIA contém 18 bandejas de computação.
Cada bandeja contém:
- 4 GPUs Blackwell
- 4 placas de rede NVIDIA ConnectX-7
- Cada interface ConnectX-7 suporta uma conexão de rede de computação de 400 Gb/s.
Isso dá o suporte:
72 GPUs → 72 portas de rede de computação ConnectX-7 400G
Em uma implementação óptica da estrutura de computação, isso corresponde aproximadamente a um transceptor óptico de 400G no lado do nó por GPU.
GB300 NVL72: 800G por GPU
A nova geração GB300 NVL72 altera a camada de rede.
Cada bandeja de computação GB300 inclui quatro adaptadores de rede ConnectX-8 para suas quatro GPUs.
Cada porta ConnectX-8 suporta 800 Gb/s e pode ser configurada da seguinte forma:
1 × 800g → 2 × 400g
As duas ligações de 400G podem então conectar-se a dois planos de rede de computação separados.
Isso resulta em:
72 GPUs → 72 portas de host ConnectX-8 800G
e, na arquitetura de referência óptica da Cisco:
72 GPUs → 72 módulos ópticos de 800G de porta dupla no lado do nó
Redes GB200 vs. GB300
| Plataforma | Adaptador de rede GPU | Velocidade da porta do host | Arquitetura Óptica de Referência |
| GB200 NVL72 | ConnectX-7 | 400G | ~1 óptica de 400G por GPU |
| GB300 NVL72 | ConnectX-8 | 800G | Aproximadamente 1 × óptica de 800G de porta dupla por GPU |
| GB300 breakout | ConnectX-8 | 2 × 400G | Um caminho de 400G para cada plano de computação. |
Essa distinção é importante ao estimar a quantidade de transceptores ópticos por trás do GPT-6 Astra.
A OpenAI confirmou mais de 100,000 GPUs, mas não divulgou publicamente a combinação exata de GB200/GB300 nem a lista completa de materiais (BOM) da rede.
Portanto, a conclusão tecnicamente defensável é:
Se as mais de 100,000 GPUs da Astra fossem conectadas usando transceptores ópticos plugáveis seguindo as arquiteturas de referência NVL72 atuais, somente o lado do nó poderia exigir cerca de 100,000 posições de módulos ópticos.
Mas esses módulos não devem ser automaticamente descritos como 800G.
Se a implementação utilizasse redes da classe GB200, muitas conexões do lado do nó seriam de 400G. Se utilizasse redes da classe GB300, as interfaces de host correspondentes poderiam ser portas ConnectX-8 de 800G.
Cabos ópticos ativos, conexões de cobre de fixação direta ou outras opções personalizadas de rede hiperescalável também podem alterar a quantidade de transceptores discretos.
Figura 2. Dos racks NVL72 às interfaces ópticas do lado do nó.
Um rack NVL72 completo contém 72 GPUs. A rede interna de expansão NVLink é de cobre. Cada GPU possui uma interface de rede de expansão horizontal: 400G com ConnectX-7 em GB200 ou 800G com ConnectX-8 em GB300.
Em aproximadamente 100,000 GPUs, isso significa cerca de 100,000 portas de rede de alta velocidade no lado do nó — mas não necessariamente 100,000 módulos ópticos 800G idênticos.
A contagem óptica real é maior.
A óptica do lado do nó é apenas uma parte de uma grande rede de IA.
As portas de switch também exigem interfaces ópticas, e clusters grandes contêm conexões adicionais leaf-to-spine, redes de armazenamento, redes front-end, redes de gerenciamento e conexões com servidores de suporte.
A arquitetura de referência empresarial N9000 da Cisco para GB300 NVL72 facilita a visualização da escala.
Para uma implementação GB300 de quatro racks com 288 GPUs , a lista completa de materiais (BOM) da Cisco é a seguinte:
- 288 módulos de dissipador de calor OSFPR-800G-DR8 para o lado do nó
- 1,112 OSFP-800G-DR8 módulos de dissipador de calor integrados em outros lugares da arquitetura
- Transceptores ópticos adicionais de 400G, 200G e 100G para conectividade convergente de armazenamento, suporte e gerenciamento.
Isso não significa que todos os clusters com 100,000 GPUs usarão a mesma proporção.
Os provedores de hiperescala podem usar diferentes topologias de switches, taxas de sobreassinatura, alcances de fibra, tipos de cabos, projetos de armazenamento ou hardware de rede personalizado.
Mas a direção é clara:
A simples contagem de GPUs subestima significativamente o número total de interfaces ópticas necessárias para construir uma fábrica de IA.
Figura 3. Arquitetura óptica simplificada do GB300
A quantidade de módulos no lado do nó escala de perto com a quantidade de GPUs, enquanto a rede completa requer óptica adicional em camadas como leaf, spine, convergentes, de armazenamento e de gerenciamento.
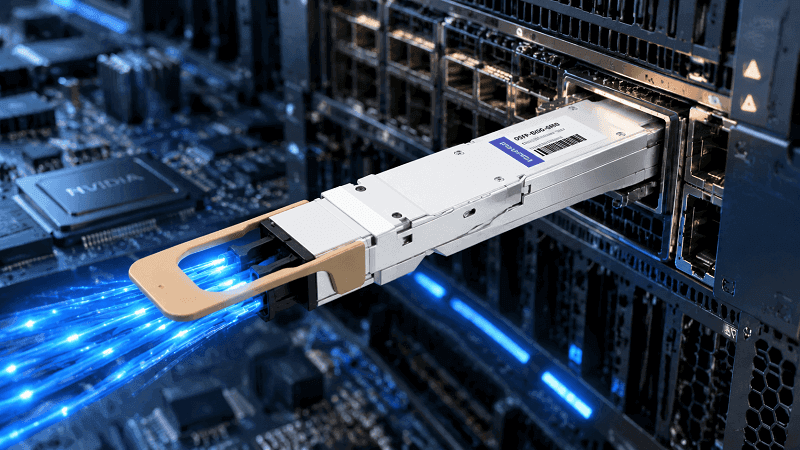
Para o GB300, essa porta de 800G pode se tornar duas portas de 400G.
A arquitetura GB300 introduz outro detalhe importante na rede.
Uma porta host ConnectX-8 de 800G pode ser dividida em:
2 conexões de 400 Gb/s
A arquitetura de referência empresarial NVL72 da NVIDIA utiliza essas duas conexões de 400G em uma estrutura de computação de plano duplo.
Um caminho de 400G conecta-se ao Plano 1.
O outro caminho de 400G conecta-se ao Plano 2.
Cada plano utiliza sua própria infraestrutura de switches de borda, proporcionando à estrutura de computação resiliência adicional, balanceamento de carga e largura de banda agregada.
Mas existe uma nuance técnica importante.
Os dois planos de rede não são completamente independentes desde a GPU até a rede.
Eles ainda compartilham:
- A GPU
- O adaptador ConnectX-8
- A porta host 800G
- E, quando se utiliza uma óptica de porta dupla, o transceptor óptico do lado do host
Os caminhos se separam ao entrarem em seus respectivos planos de cabeamento e comutação.
Assim, a rede de plano duplo ajuda a proteger contra falhas em caminhos de comutação individuais e planos de rede, mas não elimina todos os pontos de falha compartilhados.
Por isso, afirmar que os dois caminhos utilizam "transceptores separados, sem ponto de falha comum" seria impreciso.
A arquitetura pode ser melhor descrita como:
Uma interface de host de 800G → dois caminhos de rede de 400G → dois planos de computação
O projeto oferece tanto largura de banda quanto resiliência.
Se um plano de rede ficar indisponível, o tráfego ainda poderá ter um caminho através do outro plano, dependendo da localização da falha e do comportamento de recuperação do software. O desempenho pode ser reduzido e uma falha na placa de rede compartilhada ou na fibra óptica do host ainda pode afetar ambos os caminhos.
Em uma escala de 100,000 GPUs, o controle de falhas é quase tão importante quanto a largura de banda bruta. Uma única falha de hardware pode desencadear um trabalho de recuperação que vai muito além do componente que apresentou defeito.
Figura 4. Uma interface ConnectX-8 800G conectada a dois planos 400G
Um módulo óptico de 800G com duas portas pode fornecer duas conexões de 400G, uma para cada plano de computação. Os caminhos do switch e dos cabos são separados, mas ambas as conexões ainda compartilham a placa de rede (NIC) e o módulo óptico do lado da GPU.
Por que esse nível de redundância é necessário
Porque, em grande escala, as falhas deixam de ser eventos excepcionais.
Elas passam a fazer parte da operação normal do cluster.
O teste de voo Llama 3 405B da Meta fornece um dos melhores exemplos documentados publicamente.
Meta treinou Llama 3 405B usando 16,384 GPUs NVIDIA H100.
Durante um período de 54 dias de pré-treinamento, o cluster apresentou as seguintes características:
- 466 interrupções de trabalho no total.
- 47 interrupções planejadas
- 419 interrupções inesperadas
Isso equivale a aproximadamente uma interrupção inesperada a cada 3.1 horas.
A análise detalhada das falhas é particularmente útil.
Meta relatou:
- 148 interrupções defeituosas da GPU
- 72 falhas de memória HBM3
- 54 interrupções por bugs de software
- 35 interrupções de cabos/comutadores de rede
- 32 interrupções não planejadas para manutenção do host
- 19 falhas na memória SRAM da GPU
- 17 falhas no processador do sistema GPU
- 7 interrupções relacionadas à NIC
- Apenas 2 falhas de CPU
Os switches e cabos de rede causaram, portanto, 35 interrupções, ou 8.4% das interrupções inesperadas.
Isso é substancial, mas não foi a maior categoria de falhas.
Os problemas relacionados à GPU foram muito mais significativos: a Meta relatou que os problemas com a GPU representaram 58.7% das interrupções inesperadas.
Lhama 3 405B — O que realmente quebrou
| métrico | Resultado |
| Resumo do treinamento | 54 dias |
| GPUs | 16,384H100 |
| Interrupções totais | 466 |
| Interrupções inesperadas | 419 |
| Interrupções de cabos/comutadores de rede | 35 |
| Proporção da rede de interrupções inesperadas | 8.4% |
O número de GPUs divulgado para o GPT-6 Astra é mais de seis vezes maior que o do cluster Llama 3 405B.
No entanto, seria incorreto simplesmente multiplicar a taxa de falha da Meta por 6.1.
A Astra utiliza uma geração de hardware diferente, topologia de rede, pilha de software, ambiente operacional, sistema de gerenciamento de falhas e, potencialmente, estratégias de checkpoint diferentes.
O que os dados da Meta demonstram é algo mais geral:
À medida que os clusters de GPUs síncronas aumentam de tamanho, a confiabilidade dos componentes e a recuperação automatizada de falhas tornam-se cada vez mais importantes.
Um único componente pode ter excelente confiabilidade individual, enquanto falhas em algum ponto de uma frota de componentes que custa centenas de milhares de dólares ocorrem regularmente.
É por isso que os grandes clusters de IA investem fortemente em:
- Telemetria de rede
- Monitoramento da integridade do link
- Isolamento automático de falhas
- Ponto de verificação
- Recuperação rápida do emprego
- Caminhos de rede redundantes
- Manutenção preditiva
A OpenAI também afirmou que as gerações anteriores de seus modelos desempenharam um papel importante no processo de treinamento do Astra.
Relatórios públicos corroboram a ideia de que modelos anteriores auxiliavam ou supervisionavam partes do fluxo de trabalho de treinamento. No entanto, não há evidências públicas suficientes para concluir que modelos anteriores reparavam autonomamente falhas individuais de rede ou hardware "em segundos".
A ideia principal permanece a mesma: operar um cluster de GPUs de seis dígitos exige muito mais automação do que simplesmente instalar GPUs e executar uma tarefa de treinamento.
Localização exata dos transceptores ópticos em um cluster de treinamento
Transceptores ópticos não são usados para a comunicação GPU-para-GPU de maior largura de banda dentro de um rack NVL72.
Essa tarefa pertence à NVLink.
O GB200 NVL72 da NVIDIA cria um domínio NVLink de 72 GPUs com comunicação de altíssima largura de banda e baixa latência dentro do rack, utilizando switches NVLink e conectividade passiva de cobre.
A interconexão óptica torna-se crítica quando o sistema precisa ser expandido para além de um único rack.
Para GB200:
GPU → ConnectX-7 400G → malha de computação
Para GB300:
GPU → ConnectX-8 800G → 2 planos de computação de 400G
Além da conexão nó-folha, outros módulos ópticos aparecem em:
- Conexões folha-cabo
- Conexões espinha-superespinha em escala maior
- Redes de armazenamento
- Front-end ou redes convergentes
- Redes de gerenciamento em banda
- Conexões de servidor de suporte
- Interconexão de data centers
É por isso que a oportunidade óptica criada pela infraestrutura de IA não pode ser calculada simplesmente multiplicando-se as remessas de GPUs por um.
A quantidade de GPUs fornece um ponto de partida útil para estimar as portas de alta velocidade do lado do nó.
A lista completa de materiais ópticos depende de todo o tecido.
E a confiabilidade importa tanto quanto a quantidade.
Um módulo óptico não é simplesmente um item em uma lista de materiais. Ele faz parte de um sistema distribuído síncrono no qual a integridade do sinal, o desempenho térmico, a taxa de erro de bit, a interoperabilidade, a estabilidade do link e a recuperação de falhas podem influenciar diretamente a utilização do cluster.
Em uma escala de 100,000 GPUs, mesmo uma pequena redução na confiabilidade da conexão pode se traduzir em um impacto operacional significativo.
Ao mesmo tempo, seria um exagero afirmar que cada módulo óptico com falha paralisa automaticamente todo o cluster. As modernas estruturas de IA e softwares de treinamento são projetados para isolar, redirecionar, criar pontos de verificação e se recuperar de diversos tipos de falhas.
O verdadeiro desafio da engenharia, portanto, não é:
“Um módulo óptico pode falhar?”
Isto é:
"O sistema consegue detectar, isolar e se recuperar dessa falha com rapidez suficiente para manter as GPUs caras em produção?"
Perguntas frequentes
Quantos transceptores ópticos o GPT-6 Astra realmente utilizou?
O número exato não foi divulgado publicamente.
A OpenAI confirmou que o Astra foi pré-treinado em mais de 100,000 GPUs. Nas arquiteturas de referência NVIDIA NVL72 atuais, existe aproximadamente uma porta de rede de expansão horizontal de alta velocidade por GPU.
Portanto, se cada conexão de expansão horizontal voltada para a GPU utilizasse um transceptor óptico plugável discreto, somente o lado do nó poderia exigir aproximadamente 100,000 módulos ópticos.
No entanto, eles não devem ser automaticamente descritos como módulos 800G.
O GB200 NVL72 utiliza portas de rede e computação ConnectX-7 de 400G, enquanto o GB300 NVL72 utiliza portas ConnectX-8 de 800G. A configuração exata do hardware do Astra permanece em sigilo.
O cluster completo exigiria um número significativamente maior de interfaces ópticas, considerando a interconexão entre switches, o armazenamento e outras estruturas de rede.
Existem transceptores ópticos dentro de um rack NVL72?
A própria estrutura NVLink de comunicação GPU-para-GPU não utiliza transceptores ópticos.
Os sistemas GB200 e GB300 NVL72 utilizam switches NVLink e infraestrutura de cabos de cobre passivos para interconectar as 72 GPUs dentro do domínio NVLink.
No entanto, o rack ainda pode conter módulos ópticos nas interfaces de rede ConnectX e BlueField, usadas para conectar o sistema a redes externas de computação, armazenamento e gerenciamento.
Por que uma conexão GB300 de 800G é dividida em dois links de 400G?
A arquitetura de referência GB300 NVL72 da NVIDIA pode dividir cada porta ConnectX-8 800G em dois links de 400G.
Cada enlace de 400G conecta-se a um plano de rede computacional diferente.
Isso proporciona uma largura de banda agregada de 800G, ao mesmo tempo que aumenta a resiliência da estrutura e a capacidade de balanceamento de carga.
Os dois caminhos são separados no lado da rede, mas ainda compartilham a GPU, o adaptador ConnectX-8 e, normalmente, o módulo óptico de 800G de porta dupla do lado do host.
Por que o NVL72 não usa módulos ópticos para NVLink GPU-para-GPU dentro do rack?
Os sistemas NVL72 atuais usam cobre passivo para sua estrutura NVLink interna, pois as distâncias são curtas e o cobre pode fornecer largura de banda extremamente alta sem a necessidade de energia adicional e a complexidade da conversão eletro-óptica.
A óptica torna-se mais valiosa quando os sinais precisam percorrer distâncias maiores através da rede de data centers de grande escala.
Tecnologias futuras, como E/S óptica e óptica co-embalada, poderão eventualmente aproximar essa fronteira da GPU.
Procurando transceptores ópticos de 400G ou 800G para estruturas de IA?
A FiberMall fornece transceptores ópticos OSFP e QSFP-DD de 400G e 800G para aplicações de interconexão de data centers de IA de alta velocidade, incluindo configurações usadas com ConnectX-7, ConnectX-8, InfiniBand e switches Ethernet.
Para grandes implantações de clusters de IA, a FiberMall também pode dar suporte a requisitos personalizados de fornecimento de módulos ópticos, DAC/AOC, cabeamento de fibra e lista de materiais (BOM).