
NVLink é a interconexão de alta velocidade entre chips da NVIDIA, e NVSwitch é a matriz de comutação que a dimensiona para várias GPUs. Juntos, eles são a razão pela qual os sistemas de IA modernos podem treinar e fornecer modelos com trilhões de parâmetros: um único domínio de GPU agora pode mover dados entre 72 GPUs a velocidades de terabytes por segundo, o que representa aproximadamente 800 vezes mais largura de banda agregada do que a primeira geração do NVLink, lançada em 2016. Sua evolução acompanha praticamente todas as etapas do boom da computação de IA.
Este artigo explica como o NVLink e o NVSwitch evoluíram geração após geração, como a topologia da rede mudou com o aumento do número de GPUs e como a largura de banda e o cabeamento se apresentam em cada estágio. Ele também aborda o cenário atual de 2026, incluindo a geração GB300 Blackwell Ultra e a futura plataforma Vera Rubin com NVLink 6. Se você projeta, constrói ou adquire a camada de conectividade para a infraestrutura de IA da NVIDIA, as seções finais mapeiam cada geração do NVLink para os transceptores, cabos DAC e módulos ópticos realmente necessários.
O que são NVLink e NVSwitch?
NVLink é uma interconexão serial baseada em fios desenvolvida pela NVIDIA para comunicação entre GPUs e entre GPUs e CPUs. Sua existência se deve ao fato de o PCIe ter se tornado um gargalo em sistemas com múltiplas GPUs: com o NVLink, as GPUs compartilham memória e transmitem dados diretamente, em vez de passarem pela CPU, pela memória do host e pelo barramento PCIe. Cada geração do NVLink aumentou a velocidade por canal e adicionou links por GPU, de modo que a largura de banda agregada cresceu de 160 GB/s na primeira geração para 3.6 TB/s no NVLink 6.
O NVSwitch resolve um problema diferente. As conexões NVLink diretas conectam uma GPU a um pequeno número de GPUs vizinhas, mas uma malha totalmente conectada com muitas GPUs consome rapidamente muitas conexões físicas. O NVSwitch é um ASIC de comutação que cria uma malha de comunicação completa (all-to-all), permitindo que qualquer GPU alcance qualquer outra GPU com a largura de banda NVLink total. A NVIDIA apresentou o NVSwitch com o DGX-2 em 2018 e, atualmente, um domínio NVLink em escala de rack, como o GB200 NVL72, trata até 72 GPUs como uma única GPU de grande porte.
Dois termos se repetem ao longo deste artigo, por isso é útil corrigi-los agora:
- Domínio NVLink: um grupo de GPUs que compartilham memória coerente através do NVLink e podem ser programadas como um único dispositivo lógico.
- Bandeja NVSwitch: um módulo de hardware que contém ASICs NVSwitch que interligam as GPUs em um domínio.
Visão geral das gerações NVLink e NVSwitch
A tabela abaixo consolida a evolução ao longo das seis gerações do NVLink. A largura de banda por GPU é um agregado bidirecional (transmissão mais recepção). As especificações oficiais da NVIDIA para cada geração também são registradas no artigo da Wikipédia sobre NVLink.
| Generation | Ano | GPU / Arquitetura | Links por GPU | Largura de banda agregada por GPU | Sinalização |
| NV Link 1.0 | 2016 | Tesla P100 (Pascal) | 4 | 160 GB / s | 20 Gb/s por faixa |
| NV Link 2.0 | 2017 | Tesla V100 (Volta) | 6 | 300 GB / s | 25 Gb/s por faixa |
| NV Link 3.0 | 2020 | A100 (Ampere) | 12 | 600 GB / s | 50 Gb/s por faixa |
| NV Link 4.0 | 2022 | H100 / H200 (Funil) | 18 | 900 GB / s | 100 Gb/s por faixa |
| NV Link 5.0 | 2024 | B200 / GB200 / GB300 (Blackwell) | 18 | 1.8 TB / s | 200 Gb/s por faixa |
| NV Link 6.0 | 2026 | Vera Rubin | até 36 | 3.6 TB / s | SerDes bidirecional |
A tendência de sinalização é fácil de identificar. As primeiras gerações do NVLink usavam codificação NRZ e taxas modestas por canal. Em seguida, a NVIDIA migrou para a sinalização PAM4 no NVLink 4.0 e continuou aumentando a taxa por canal. O NVLink 6 dobra o número de links por GPU para até 36 e adota o SerDes bidirecional, a mesma classe de sinalização elétrica de alta velocidade que agora está presente em sistemas ópticos Ethernet de 1.6T. É por isso que a camada física do NVLink agora se sobrepõe diretamente à indústria de transceptores ópticos.
Evolução da Topologia: Como as Redes de GPUs Cresceram
A mudança mais importante entre as gerações não é a velocidade bruta, mas sim a topologia. Cada geração mudou a forma como as GPUs são interligadas.
Conexão direta de GPU para GPU em malha (sem comutador)
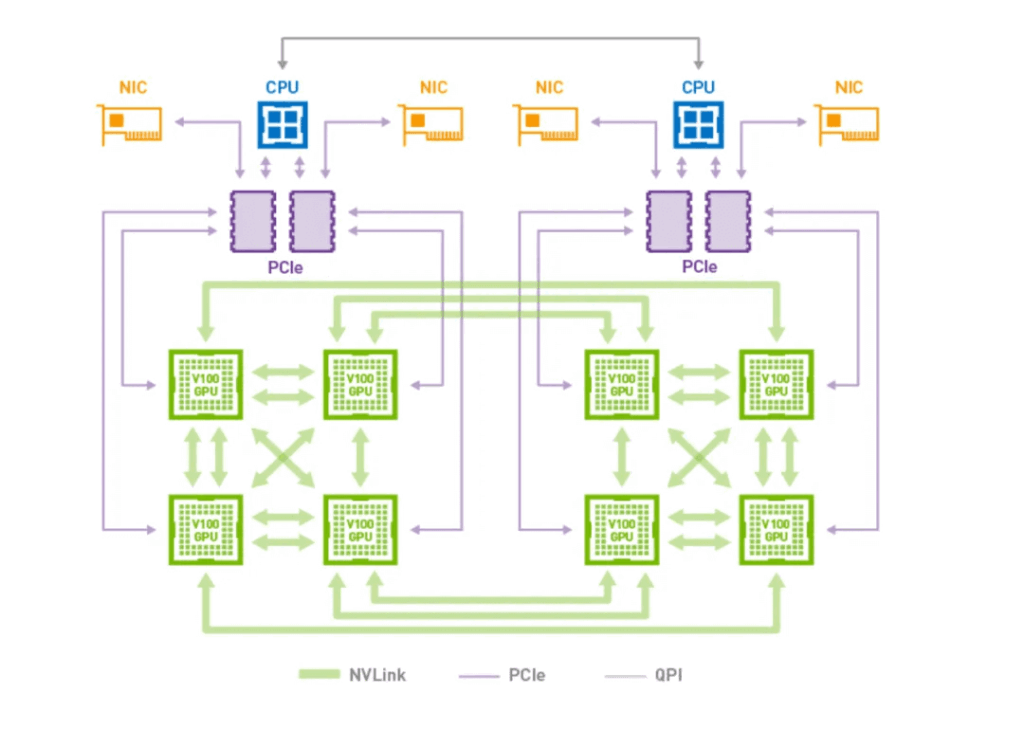
Os primeiros produtos NVLink conectavam GPUs diretamente umas às outras. As placas Tesla P100 e Volta V100 estabeleciam até quatro e seis links, respectivamente, para GPUs próximas, formando uma pequena malha. Isso funcionava para sistemas com poucas GPUs, mas não era escalável, pois adicionar GPUs obrigava cada uma a utilizar mais links. O DGX-1, que comportava oito GPUs V100, utilizava um arranjo híbrido de cubo e malha que mantinha todas as oito GPUs conectadas sem a necessidade de um switch.
A primeira NVSwitch Fabric (2018)
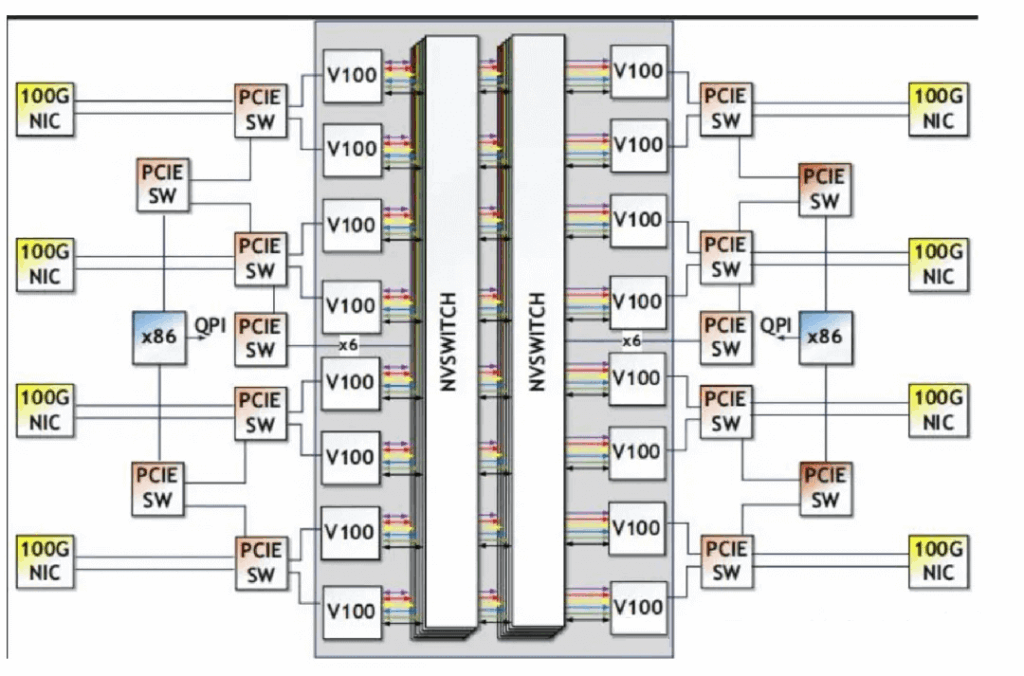
Em 2018, a NVIDIA atingiu o limite de escalabilidade das malhas diretas com o DGX-2, que incorporava 16 GPUs V100. Em vez de conectar cada GPU a todas as outras, a NVIDIA introduziu o NVSwitch. O DGX-2 possuía seis ASICs NVSwitch de primeira geração em cada uma de suas duas placas-mãe, e cada GPU se comunicava com a matriz de comutação em vez de com cada par. Dessa forma, cada par de GPUs podia se comunicar na velocidade máxima do NVLink, e o sistema se comportava como um único domínio de 16 GPUs.
Domínio padrão de 8 GPUs (2020 a 2022)
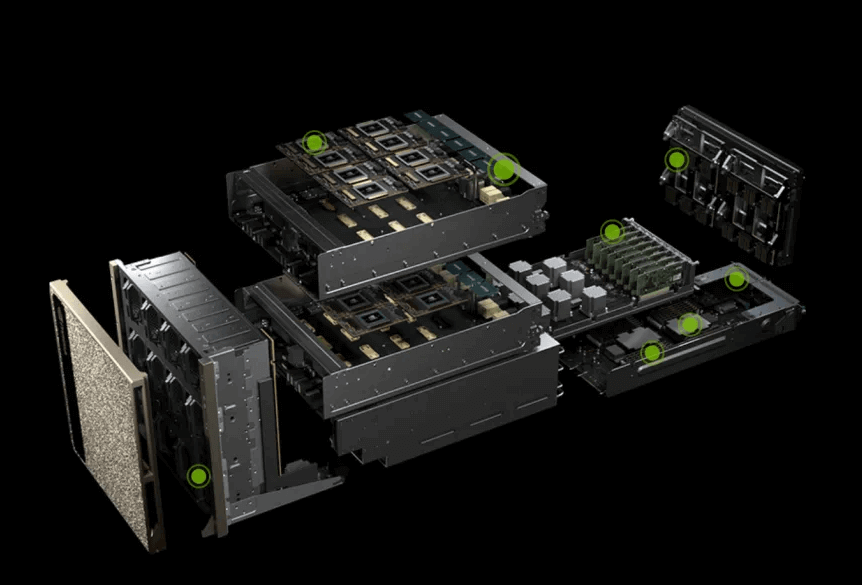
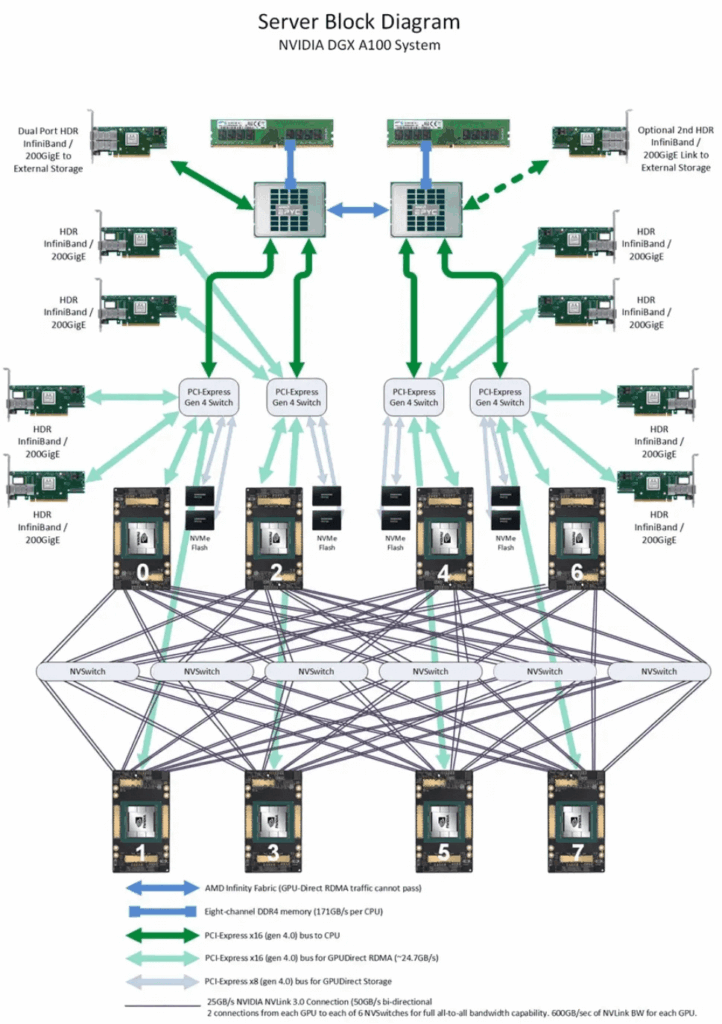
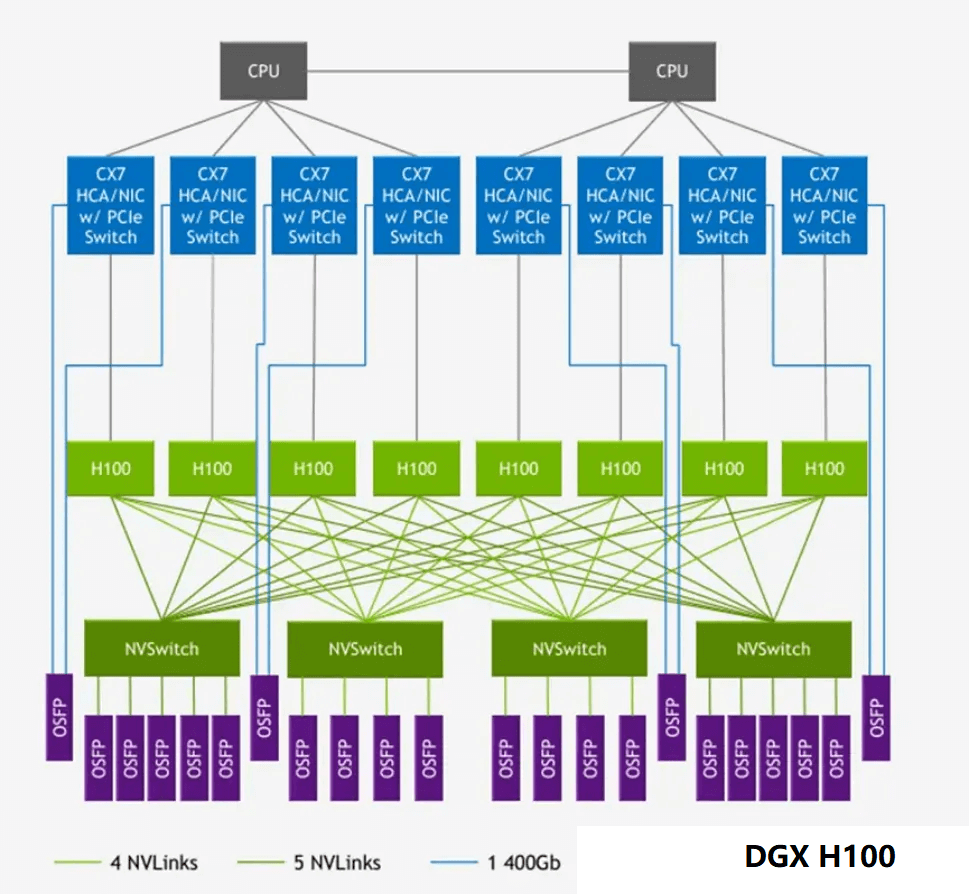
A partir do A100, a NVIDIA padronizou um bloco de construção com 8 GPUs. Um sistema DGX A100 contém oito GPUs A100 conectadas a seis ASICs NVSwitch de segunda geração, criando um domínio de malha completa no qual qualquer GPU alcança qualquer outra a 600 GB/s. O DGX H100 fez o mesmo com quatro chips NVSwitch de terceira geração, e cada H100 mantém seus 900 GB/s completos para a malha.
Domínios de escala de rack para todos os domínios (2024)
A geração Blackwell mudou novamente a unidade de escala. Um rack GB200 NVL72 comporta 72 GPUs e 36 CPUs Grace, e seus nove switches NVSwitch criam um domínio NVLink de 72 GPUs. Cada GPU no rack se comunica com todas as outras a 1.8 TB/s, e a malha agrega aproximadamente 130 TB/s. A NVIDIA fornece o mesmo domínio de 72 GPUs em dois layouts físicos: o NVL72 de rack único e o NVL36x2 de dois racks, que distribui o domínio por dois gabinetes conectados por links OSFP de 1.6T.
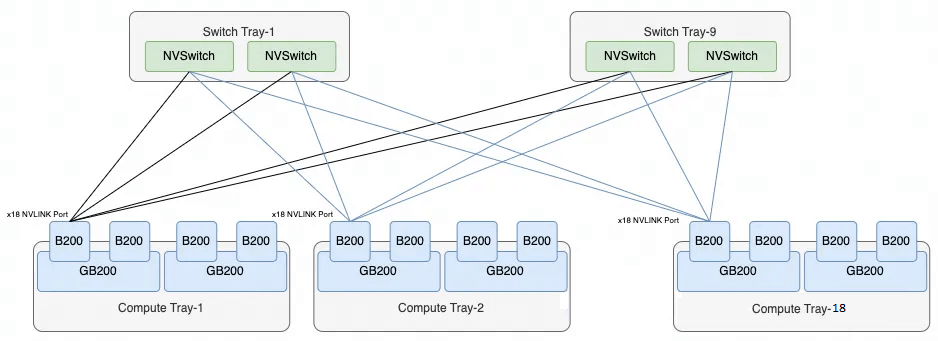
Domínios NVLink externos além de um rack
A tecnologia NVLink não se limita aos limites do rack. A NVIDIA vende módulos de switch NVLink externos, unidades de 1U que contêm dois chips NVSwitch cada e expõem slots OSFP, permitindo que os operadores interliguem domínios de 8 ou 72 GPUs em redes maiores. Na geração DGX H100, os switches NVLink externos conectavam até 256 GPUs com uma largura de banda agregada de 57.6 TB/s. Na geração Blackwell, os switches NVLink externos interligam racks NVL72 em domínios NVLink ainda maiores para modelos que não cabem em um único rack. É nessas redes escaláveis que se encontram as conexões ópticas maiores e mais caras.
A evolução do NVLink e do NVSwitch
2016: Pascal e Tesla P100, NVLink de primeira geração
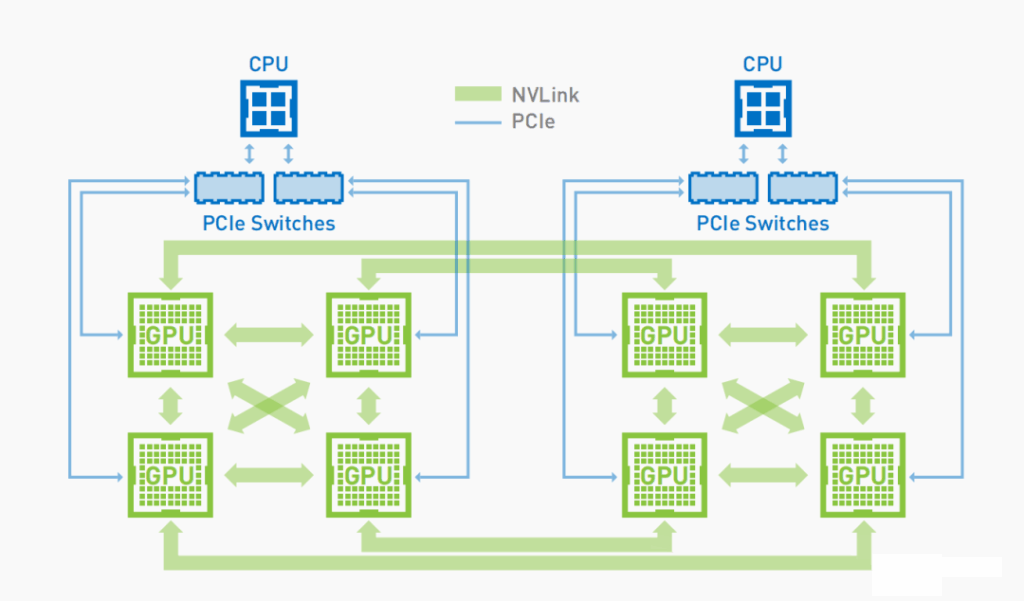
A NVIDIA anunciou o NVLink pela primeira vez em 2014, e a tecnologia chegou ao seu primeiro produto em 2016 com a Tesla P100, construída sobre a arquitetura Pascal. O NVLink 1.0 forneceu à P100 quatro links com uma taxa de transferência bidirecional agregada de 160 GB/s, cerca de cinco vezes a largura de banda de um slot PCIe 3.0 x16. Isso tornou viáveis configurações com quatro ou oito GPUs sem transformar o barramento PCIe em gargalo. Ainda não existia NVSwitch; as GPUs comunicavam-se diretamente entre si.
2017: Volta e Tesla V100, NVLink de segunda geração
A Tesla V100 de 2017, baseada na arquitetura Volta, revolucionou a interconexão. O NVLink 2.0 elevou cada V100 a seis links, proporcionando 300 GB/s de largura de banda bidirecional. O DGX-1 com GPUs V100 escalou para até oito GPUs usando uma malha híbrida e, pela primeira vez, o NVLink suportou GPUs em diferentes switches PCIe, permitindo que um único espaço de memória coerente abrangesse um nó inteiro.
2018: DGX-2 e o primeiro NVSwitch
A placa DGX-2 com 16 GPUs marcou a chegada do NVSwitch. Seis ASICs NVSwitch de primeira geração ficavam em cada placa-mãe para conectar as GPUs, e a matriz de comutação permitia que quaisquer duas GPUs no sistema trocassem dados na velocidade máxima do NVLink. Essa é a topologia que todos os sistemas NVIDIA posteriores herdaram. O NVSwitch transformou uma rede de links ponto a ponto em uma verdadeira matriz de comutação.
2020: Ampere e A100, NVLink de terceira geração
A geração A100 padronizou o domínio de 8 GPUs. O NVLink 3.0 forneceu a cada A100 12 links para 600 GB/s de largura de banda bidirecional, e os chips NVSwitch de segunda geração no DGX A100 conectaram oito GPUs em um domínio de malha completa. A placa-mãe HGX, que suporta os A100 e seus NVSwitches, tornou-se o projeto de referência em torno do qual os fabricantes de servidores constroem seus sistemas, e é o módulo ao qual um servidor host se conecta via PCIe.
2022: Hopper e H100, NVLink de quarta geração
O NVLink 4.0 no H100 foi o primeiro a usar a sinalização PAM4, elevando a velocidade por canal para 100 Gb/s e proporcionando a cada H100 900 GB/s em 18 links, aproximadamente 14 vezes a capacidade de um slot PCIe 5.0 x16. Os chips NVSwitch de terceira geração trouxeram o mecanismo de redução em rede SHARP para a malha, permitindo que operações coletivas, como all-reduce, sejam executadas dentro dos switches. Para clusters maiores, a NVIDIA introduziu módulos NVLink Switch externos que permitem aos operadores criar domínios com até 256 GPUs, como no DGX H100 SuperPOD.
2024: Blackwell B200, NVLink de quinta geração
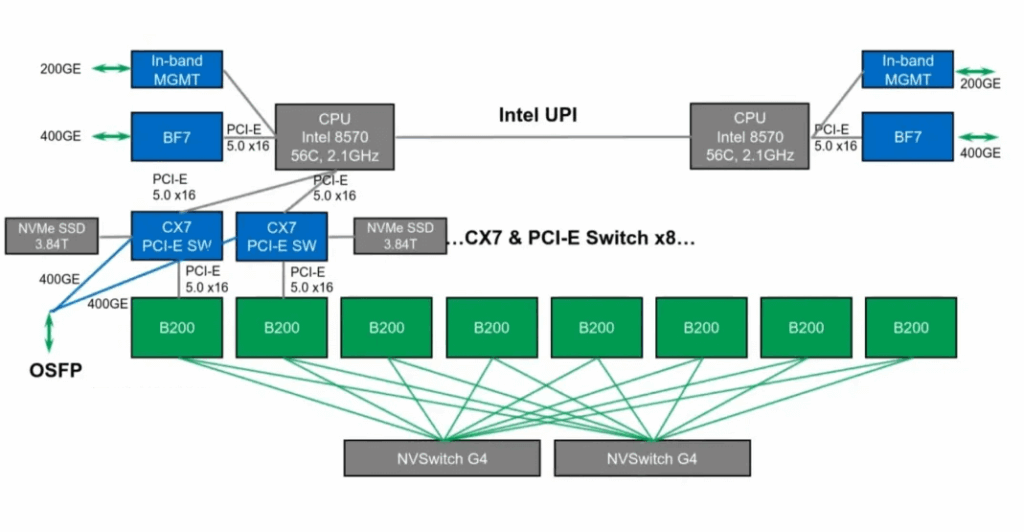
A geração Blackwell transformou o NVLink de uma interconexão de nós em uma interconexão de racks. O NVLink 5.0 oferece a cada B200 1.8 TB/s em 18 links, e o rack GB200 NVL72 cria um único domínio de 72 GPUs com cerca de 130 TB/s de largura de banda de interconexão. A NVIDIA também continuou aprimorando o NVSwitch: cada bandeja de switch NVL72 comporta dois ASICs NVSwitch de última geração, e o domínio abrange um rack inteiro, mantendo-se em cabeamento de cobre dentro do gabinete.
2025 a 2026: GB300 Blackwell Ultra
Blackwell Ultra, da geração GB300, será a plataforma de volume até 2026. A GPU B300 aumenta a memória para 288 GB de HBM3e e eleva o rack NVL72 para aproximadamente 132 kW, e a rede de expansão horizontal passa a utilizar placas de rede ConnectX-8 de 800G. Para o NVLink em si, o GB300 permanece na quinta geração, mas o sistema introduz a divisão entre cobre e fibra óptica que agora define o design do rack: NVLink de cobre dentro do rack e links de fibra óptica onde a distância aumenta.
2026: Vera Rubin, NVLink de sexta geração
A plataforma Vera Rubin traz o NVLink 6.0. Anunciado pela NVIDIA em 2025 e detalhado até o início de 2026, o NVLink 6 dobra a largura de banda por GPU para 3.6 TB/s em até 36 links por GPU, enquanto a geração NVSwitch que o acompanha eleva a largura de banda da malha em escala de rack para aproximadamente 260 TB/s. O primeiro sistema topo de linha, o Vera Rubin NVL144, tem previsão de lançamento para o segundo semestre de 2026, e o Rubin Ultra (NVL576) virá em seguida, com óptica integrada no roadmap. Para quem compra cabos e componentes ópticos hoje, esta é a transição a ser observada, pois os sistemas NVLink 6 transferem uma parcela maior da malha para cabeamento óptico de alta velocidade e cabeamento elétrico ativo.
NVLink vs PCIe: Comparação de Largura de Banda
É mais fácil compreender as taxas do NVLink quando as comparamos com o PCIe, o barramento de uso geral que o NVLink foi projetado para contornar. A tabela usa números bidirecionais.
| Interconexão | largura de banda bidirecional de pico típica | Tipo |
| PCIe 4.0 x16 | ~ 64 GB / s | E/S de uso geral |
| PCIe 5.0 x16 | ~ 128 GB / s | E/S de uso geral |
| NVLink 3.0 (A100) | 600 GB/s por GPU | Aumentar a escala dentro de um nó |
| NVLink 4.0 (H100) | 900 GB/s por GPU | Aumentar a escala dentro de um nó |
| NVLink 5.0 (B200) | 1.8 TB/s por GPU | Ampliação de escala dentro de um rack |
| NVLink 6.0 (Rubin) | 3.6 TB/s por GPU | Expansão em vários racks |
A consequência prática é que o paralelismo de tensores e outros padrões de paralelismo de modelos dependem do NVLink. Quando as GPUs precisam trocar gradientes de peso a cada passo de treinamento, um domínio NVLink processa esse tráfego ordens de magnitude mais rápido do que o PCIe, razão pela qual o treinamento de modelos grandes efetivamente o exige.
Por que NVLink e NVSwitch são importantes para IA e HPC?
Três funcionalidades explicam por que todos os principais clusters de IA agora dependem de NVLink e NVSwitch:
- Memória compartilhada coerente. As GPUs em um domínio NVLink compartilham um espaço de memória unificado, de modo que o software pode tratar vários aceleradores como um único dispositivo grande, em vez de gerenciar a troca de mensagens.
- Ampliação de escala quase linear. Uma matriz de comutação oferece largura de banda total para cada par de GPUs, portanto, adicionar GPUs não limita a comunicação da mesma forma que ocorreria em uma rede em anel ou em malha.
- Aceleração integrada ao tecido. As gerações modernas de NVSwitch reduzem ou eliminam o tráfego de rede em operações coletivas, diminuindo o tempo gasto na sincronização entre centenas de GPUs.
A contrapartida no projeto é que essa potência vem acompanhada de limitações físicas. À medida que a largura de banda do NVLink ultrapassa 900 GB/s por GPU, a integridade e o alcance do sinal começam a ditar o projeto, e é exatamente daí que surgem as decisões sobre cabeamento e óptica na próxima seção.
Cabeamento e conectividade: o que um domínio de GPU NVLink precisa
Para arquitetos e compradores de redes, o aspecto interessante da história do NVLink reside na camada física, pois cada geração alterou o tipo de componentes de cobre e ópticos utilizados na estrutura. É também nesse ponto que o NVLink e o portfólio de transceptores e cabos compatíveis com NVIDIA da FiberMall se conectam.
NVLink em rack: o cobre vence.
Dentro de um único rack, a NVIDIA utiliza cobre para NVLink sempre que possível. O GB200 NVL72 utiliza NVLink de cobre na parte traseira do gabinete, o que economiza aproximadamente 20 kW por rack em comparação com links ópticos e mantém a latência baixa. Esses cabos de cobre são cabos twin-axiais de alta velocidade, essencialmente grandes conjuntos DAC, que se conectam às bandejas de computação e às bandejas do NVSwitch. O cobre predomina no NVLink porque as distâncias são curtas (menos de alguns metros) e a economia de energia é significativa.
NVLink Rack-to-Rack: Óptica e AECs
Quando o NVLink cruza entre racks, o alcance do cobre se esgota. O GB200 NVL36x2, por exemplo, distribui um domínio de 72 GPUs por dois racks, e as bandejas do NVSwitch conectam o par através de slots OSFP de 1.6T. Esses links transportam tráfego NVLink real, portanto, precisam de óptica OSFP de alto desempenho ou cabos elétricos ativos (AECs) de 1.6T e cabeamento de baixa perda. O mesmo se aplica a redes externas de switches NVLink que unem racks em domínios maiores.
Redes de escalabilidade horizontal: InfiniBand e Ethernet
Além da escalabilidade vertical do NVLink, cada cluster NVIDIA possui uma rede de escalabilidade horizontal para tarefas, armazenamento e tráfego entre vários racks. Os sistemas DGX H100 utilizam InfiniBand ConnectX-7 de 400G, o GB300 migra para ConnectX-8 de 800G, e a estrutura é construída sobre switches Quantum-X800 (InfiniBand) ou Spectrum-X800 (Ethernet). É nessa camada que os módulos OSFP de 400G e 800G compatíveis com NVIDIA e as ópticas QSFP-DD se conectam às placas de rede.
Guia Prático de Seleção
| Camada de tecido | Link típico | Conectividade recomendada |
| NVLink em rack (NVL72) | NVLink de cobre | Cabos DAC de alta velocidade, cabos de cobre curtos |
| NVLink rack-to-rack (NVL36x2) | Gaiolas OSFP de 1.6T | Óptica OSFP de 800G ou DAC/AEC de porta dupla |
| Domínios NVLink externos | OSFP no switch NVLink | Módulos ópticos OSFP, troncos de fibra MPO |
| InfiniBand de expansão (GB300) | 800G ConnectX-8 | Transceptores OSFP SR8/DR8 de 800G, DAC NDR |
A FiberMall fabrica módulos compatíveis com NVIDIA exatamente para essas conexões. O módulo SR8 OSFP de 800G atende a NVLink de curto alcance e estruturas de expansão horizontal, a família OSFP flat-top de 800G cobre trechos de fibra monomodo DR8 e os cabos DAC NDR de 800G lidam com os curtos trechos de cobre dentro dos racks. Para pares rack-a-rack e domínios NVLink externos, os DACs breakout OSFP de porta dupla e os trunks de fibra MPO são os blocos de construção práticos. Para saber como a NVIDIA separa a expansão vertical do NVLink da arquitetura de expansão horizontal do Ethernet e quais produtos de cobre e OSFP essa estrutura de expansão horizontal precisa, consulte nossa análise de cabos splitter NDR de 400G e cobre OSFP de 800G.
Uma regra prática resume tudo: mantenha o NVLink em cabos de cobre onde as distâncias são curtas e o consumo de energia é limitado, use fibra óptica onde o alcance ou a densidade exigirem e considere o OSFP 800G e 1.6T como o padrão de futuro, para que seu cabeamento seja compatível com as gerações GB300 e Vera Rubin.
NVLink Fusion e o futuro da óptica
A próxima grande mudança no NVLink é óptica. Em 2025, a NVIDIA apresentou o NVLink Fusion, uma abordagem que estende o NVLink por meio de interconexões ópticas, permitindo que um único domínio NVLink abranja vários racks em vez de terminar na borda do gabinete. O NVLink Fusion utiliza componentes ópticos integrados e módulos ópticos de alta velocidade para transportar o tráfego NVLink pelas distâncias maiores que separam os racks de GPUs, o que é importante à medida que os domínios crescem além da capacidade de um único rack.
Para a indústria óptica, isso representa uma expansão direta do mercado. Cada link NVLink Fusion e cada bandeja NVSwitch de última geração que se comunica opticamente precisa da mesma classe de transceptores, AECs e cabeamento estruturado que o Ethernet 800G e 1.6T já utilizam. O próprio conteúdo para desenvolvedores da NVIDIA sobre NVLink Fusion apresenta o NVLink Fusion como uma forma de tornar o escalonamento de redes mais flexível, oferecendo aos operadores o alcance da óptica com a semântica de memória de baixa latência do NVLink. No roadmap, o Rubin Ultra (NVL576) e seus componentes ópticos integrados são o sinal mais claro de que o NVLink e as redes ópticas estão convergindo, e a expertise da FiberMall em óptica foi desenvolvida exatamente para essa transição. Para obter informações sobre as arquiteturas de interconexão de alta densidade nas quais esses sistemas se baseiam, leia nosso guia de interconexão para data centers.
Perguntas frequentes
O que é NVLink?
NVLink é a interconexão de alta velocidade entre chips da NVIDIA para GPUs. Ela conecta GPUs entre si e às CPUs com uma largura de banda muito maior do que a PCIe, permitindo memória compartilhada coerente e transferências diretas ponto a ponto. O NVLink evoluiu ao longo de seis gerações, de 160 GB/s na Tesla P100 a 3.6 TB/s por GPU na Vera Rubin.
O que é um NVSwitch?
O NVSwitch é o ASIC de comutação da NVIDIA para NVLink. Ele cria uma interconexão completa (all-to-all) para que qualquer GPU em um domínio possa alcançar qualquer outra GPU com a largura de banda total do NVLink. A NVIDIA apresentou o NVSwitch em 2018 com o DGX-2, e agora ele permite a expansão de domínios de GPU de oito GPUs até racks inteiros, como o GB200 NVL72 com 72 GPUs.
Qual a velocidade do NVLink 6?
O NVLink 6 oferece 3.6 TB/s de largura de banda bidirecional por GPU, o dobro dos 1.8 TB/s do NVLink 5 da geração Blackwell. Ele suporta até 36 links por GPU e estreia com a plataforma Vera Rubin, cujo sistema NVL144 tem previsão de lançamento para o segundo semestre de 2026.
Qual a diferença entre NVLink e PCIe?
NVLink é uma interconexão dedicada para GPUs com largura de banda por GPU medida em terabytes por segundo, enquanto PCIe é um barramento de E/S de uso geral que atinge um pico de cerca de 64 a 128 GB/s para um slot x16. O NVLink ignora a CPU e a memória do host para tráfego de GPU para GPU, o que é essencial para o treinamento de modelos grandes.
A NVLink utiliza cabos de cobre ou cabos de fibra óptica?
Ambos. O NVLink opera em cobre dentro de um rack, como no GB200 NVL72, onde o cobre economiza aproximadamente 20 kW por gabinete. O NVLink atravessa racks através de módulos ópticos OSFP de 1.6T e cabos elétricos ativos, e o roadmap NVLink Fusion da NVIDIA estende o NVLink sobre interconexões ópticas para abranger ainda mais racks.
Quais cabos são necessários para um rack NVL72?
Um rack NVL72 precisa de cabos NVLink de cobre curtos e de alta velocidade entre as bandejas de computação e as bandejas de switches NV dentro do gabinete, além de óptica OSFP de 800G e cabos DAC ou AEC para links entre racks e para expansão horizontal. A FiberMall oferece opções compatíveis com NVIDIA para todos esses itens.
Conclusão
NVLink e NVSwitch evoluíram de uma interconexão de GPU de quatro links em 2016 para uma estrutura em escala de rack que conecta 72 GPUs como um único dispositivo, e o roadmap agora estende o NVLink para racks com óptica. Compreender as gerações ajuda você a tomar melhores decisões de compra hoje. Os principais pontos a serem destacados são:
- A largura de banda do NVLink cresceu de 160 GB/s (NVLink 1.0, P100) para 3.6 TB/s por GPU (NVLink 6, Vera Rubin), um aumento de aproximadamente 22 vezes em uma década.
- A topologia evoluiu de malhas de GPUs diretas para redes NVSwitch, domínios de 8 GPUs, domínios NVL72 em escala de rack e redes NVLink externas que abrangem vários racks.
- A camada física se divide entre links NVLink de cobre em rack e links ópticos para tráfego entre racks e de expansão horizontal, e é aí que a conectividade OSFP de 800G e 1.6T se torna relevante.
- NVLink 6 em Vera Rubin e NVLink Fusion são os próximos capítulos, e o planejamento de óptica para 800G e 1.6T agora protege seu investimento em cabeamento através do GB300 e em Rubin.
Se você está buscando soluções de conectividade para um cluster de GPUs NVIDIA, confira os módulos e cabos OSFP compatíveis com NVIDIA da FiberMall. Para obter ajuda na escolha dos módulos ideais para seus switches, placas de rede e estrutura NVLink, entre em contato com nossos engenheiros na página de perguntas da FiberMall.
Produtos relacionados:
-
 Compatível com NVIDIA MMA4Z00-NS400 400G OSFP SR4 Flat Top PAM4 850nm 30m em OM3/50m em OM4 MTP/MPO-12 Multimode FEC Optical Transceiver Module
$400.00
-
Módulo Transceptor Óptico NVIDIA MMA4Z00-NS-FLT Compatível com 800GBASE 2 x SR4/SR8 OSFP RHS/Flat Top PAM4 850nm 100m DOM Dual MPO-12 MMF
$600.00
-
Módulo Transceptor Óptico NVIDIA MMA4Z00-NS Compatível com 800GBASE 2 x SR4/SR8 OSFP PAM4 850nm 100m DOM Dual MPO-12 MMF
$550.00
-
Módulo Transceptor Óptico NVIDIA MMS4X00-NM Compatível com 800GBASE 2 x DR4/DR8 OSFP IHS/Closed Finned Top PAM4 1310nm 500m DOM Dual MTP/MPO-12 SMF
$600.00
-
Módulo Transceptor Óptico NVIDIA MMS4X00-NM-FLT Compatível com 800GBASE 2 x DR4/DR8 OSFP Flat Top PAM4 1310nm 500m DOM Dual MTP/MPO-12 SMF
$650.00
-
Compatível com NVIDIA MMS4X00-NS400 400G OSFP DR4 Flat Top PAM4 1310nm MTP/MPO-12 500m SMF FEC Módulo transceptor óptico
$450.00
-
Módulo transceptor óptico NVIDIA(Mellanox) MMA1T00-HS compatível com 200G Infiniband HDR QSFP56 SR4 850nm 100m MPO-12 APC OM3/OM4 FEC PAM4
$139.00
-
NVIDIA MFP7E10-N010 compatível com 10 m (33 pés) 8 fibras baixa perda de inserção fêmea para fêmea MPO cabo tronco polaridade B APC para APC LSZH multimodo OM3 50/125
$47.00
-
Compatível com NVIDIA MCP7Y00-N003-FLT 3m (10 pés) 800G OSFP de porta dupla a 2x400G OSFP plano superior InfiniBand NDR Breakout DAC
$260.00
-
NVIDIA MCP7Y70-H002 compatível com 2m (7 pés) 400G Twin-port 2x200G OSFP para 4x100G QSFP56 Passivo Breakout Direct Attach Cabo de cobre
$155.00
-
NVIDIA MCA4J80-N003-FTF compatível com 3m (10 pés) 800G de porta dupla 2x400G OSFP a 2x400G OSFP InfiniBand NDR cabo de cobre ativo, parte superior plana em uma extremidade e parte superior com aletas na outra
$600.00
-
NVIDIA MCP7Y10-N002 compatível com 2m (7 pés) 800G InfiniBand NDR OSFP de porta dupla para 2x400G QSFP112 Breakout DAC
$190.00