
Управляющее резюме
В условиях стремительного роста цифровой экономики и технологий искусственного интеллекта (ИИ) глобальная сетевая инфраструктура центров обработки данных находится на критическом историческом этапе миграции со 100G на 400G/800G. Поскольку количество параметров в больших языковых моделях (LLM) превышает триллион, а спрос на высокопроизводительные вычисления (HPC) и распределенное хранение данных резко возрастает, сеть перестает быть просто каналом передачи данных и превращается в ключевое узкое место, определяющее эффективность вычислительных кластеров. Будучи краеугольным камнем сетей центров обработки данных следующего поколения, техническая составляющая коммутаторов Ethernet 400G выходит за рамки простого увеличения пропускной способности, глубоко затрагивая гетерогенность базовых архитектур чипов, интеллектуальные алгоритмы управления перегрузкой и инновационные формы оптоэлектронных соединений.
Цель данного отчета — всесторонний и тщательный анализ технической экосистемы и конкурентной среды текущего рынка коммутаторов 400G. Исследование показывает, что в период с 2024 по 2025 год мировой рынок коммутаторов Ethernet продемонстрировал значительный двузначный рост, в значительной степени обусловленный спросом на сети с поддержкой искусственного интеллекта. Несмотря на быстрый рост поставок портов 800G, 400G остается основной платформой для центров обработки данных как сейчас, так и в течение следующих трех лет, благодаря развитой цепочке поставок, отличному соотношению цены и качества и широкой совместимости с устаревшими системами.
В техническом плане Ethernet ведет ожесточенную борьбу с традиционным InfiniBand, используя технологию RoCEv2 (RDMA поверх конвергентного Ethernet). Для разрешения противоречия между естественной характеристикой Ethernet, предполагающей «максимальные усилия», и требованиями к «сети без потерь» для обучения ИИ, такие гиганты в области микросхем, как Broadcom, NVIDIA и Cisco, выпустили ASIC-чипы с глубокой телеметрией и расширенными возможностями управления потоком (например, Tomahawk 5, Spectrum-4, Silicon One G100). Тем временем, поставщики систем, такие как Huawei, H3C и Ruijie, создали дифференцированные конкурентные барьеры за счет интегрированных в программное и аппаратное обеспечение алгоритмических инноваций, таких как iLossless, SeerNetwork и RALB. В этом отчете будут подробно рассмотрены эти технические детали и объединены с рыночными данными, чтобы предоставить перспективные стратегические рекомендации для корпоративных пользователей, инвесторов и лиц, принимающих технические решения.
Макроэкономический контекст и технические факторы: от облачных вычислений до фабрик искусственного интеллекта.
Фундаментальные изменения в моделях транспортного потока
В течение последнего десятилетия проектирование сетей центров обработки данных в основном было ориентировано на обслуживание облачных вычислений и веб-приложений, при этом характеристики трафика определялись потоками «север-юг» (от клиента к серверу), а также учитывался трафик «восток-запад» (от виртуальной машины к виртуальной машине), обеспечиваемый виртуализацией. Однако развитие генеративного ИИ полностью изменило эту парадигму. В кластерах для обучения ИИ тысячи графических процессоров должны выполнять синхронизацию параметров (All-Reduce), что приводит к чрезвычайно высокой всплескиваемости сетевого трафика и характеристикам «многие к одному» (Incast).
Изменение моделей трафика делает традиционные сетевые архитектуры с переподпиской неприменимыми. В фабриках ИИ сеть должна обеспечивать высокую пропускную способность, нулевую потерю пакетов и детерминированно низкую задержку. Исследования показывают, что незначительное увеличение задержки сети (например, с 10 микросекунд до 100 микросекунд) может привести к простою дорогостоящих вычислительных ресурсов графических процессоров, что значительно увеличивает временные затраты и энергопотребление при обучении моделей. Поэтому развертывание коммутаторов 400G — это не просто модернизация портов, а попытка создать высокопроизводительную сетевую основу, способную поддерживать линейную масштабируемость вычислительной мощности.
Ключевые технические прорывы в области Ethernet 400G
Внедрение стандарта 400G Ethernet (IEEE 802.3bs) привело к появлению ряда революционных технологий, обеспечив качественный скачок в эффективности передачи данных на физическом уровне:
Введение в технологию модуляции PAM4: Для передачи большего объема данных в условиях ограниченной полосы пропускания стандарт 400G отказался от традиционного кодирования NRZ (без возврата к нулю) в пользу PAM4 (импульсно-амплитудная модуляция 4-уровневая). PAM4 передает 2 бита (4 уровня) за такт, удваивая эффективность по сравнению с NRZ. Однако PAM4 предъявляет более строгие требования к соотношению сигнал/шум (SNR), что напрямую приводит к усложнению конструкции физического уровня (PHY) и зависимости от микросхем цифровой обработки сигналов (DSP).
Необходимость использования FEC (прямой коррекции ошибок): Поскольку сигналы PAM4 более подвержены помехам, частота битовых ошибок (BER) значительно возрастает. Поэтому в каналах связи 400G обязательно должна быть включена функция FEC (например, RS-FEC 544,514). Хотя FEC обеспечивает надежность передачи, она вносит дополнительную задержку обработки (обычно в диапазоне 100–250 нс), что является важным фактором для сетей искусственного интеллекта, стремящихся к сверхнизкой задержке.
Эволюция форм оптических модулей: QSFP-DD (Double Density) и OSFP (Octal Small Form-factor Pluggable) стали основными стандартами упаковки для эпохи 400G. QSFP-DD доминирует в центрах обработки данных благодаря обратной совместимости с QSFP28; OSFP предпочтительнее в высокопроизводительных вычислениях и в будущей эволюции 800G благодаря лучшим возможностям рассеивания тепла (поддерживает энергопотребление до 15–20 Вт и выше).
Экономический анализ энергоэффективности и плотности
В гипермасштабных центрах обработки данных энергоэффективность является ключевым фактором. Коммутаторы 400G демонстрируют значительные экономические преимущества по сравнению с архитектурами 100G. Согласно анализу отраслевых данных, сетевая архитектура 400G может снизить энергопотребление на Гбит/с примерно на 43% (с ~1.2 Вт/Гбит до ~0.7 Вт/Гбит) и уменьшить занимаемое в стойке пространство на 48% по сравнению с сетью 100G с эквивалентной пропускной способностью.
Таблица 2.1: Экономическое сравнение энергоэффективности и плотности: архитектуры 400G и 100G
| Ключевой показатель | Архитектура сети 100G (базовая) | Сетевая архитектура 400G | Улучшение/Преимущество |
| Пропускная способность порта | 100 Gbps | 400 Gbps | 4-кратное увеличение |
| Мощность на Гбит/с | ~35 мВт / 1.2 Вт (на системном уровне) | ~20 мВт / 0.7 Вт (на системном уровне) | Экономия энергии ~43% |
| Место в стойке (на Тбит/с) | 2.5 RU | 1.3 RU | 48% сбережений |
| Количество кабелей (с одинаковой пропускной способностью) | 100% (исходный) | 25% - 50% | Сокращение на 50–75%, упрощение операций. |
| Емкость коммутационного чипа | 3.2 Тбит/с – 6.4 Тбит/с | 12.8 Тбит/с – 25.6 Тбит/с | Увеличение в 4-8 раз, сглаженные сетевые слои |
| TCO (3 лет) | Базовый уровень ($X) | $0.65X | 35% снижение |
Это повышение энергоэффективности в первую очередь обусловлено достижениями в технологиях производства коммутационных чипов (переход от 16 нм/12 нм к 7 нм/5 нм) и увеличением скорости SerDes (от 25G SerDes до 56G/112G SerDes). Это позволяет центрам обработки данных поддерживать экспоненциальный рост спроса на пропускную способность, вызванный вычислениями с использованием искусственного интеллекта, без увеличения своих физических площадей.
Углубленное изучение архитектур ASIC и технологических школ.
Микросхема коммутатора (ASIC) — это сердце, определяющее потолок производительности коммутатора 400G. Современный рынок представляет собой трехстороннюю картину: Broadcom доминирует на коммерческом рынке благодаря огромным объемам поставок и стандартизированной экосистеме; NVIDIA фокусируется на сквозной оптимизации, используя свой богатый опыт в высокопроизводительных вычислениях; Cisco пытается преодолеть барьеры между маршрутизацией и коммутацией с помощью унифицированной архитектуры. Кроме того, такие поставщики, как Marvell, остаются конкурентоспособными в определенных нишах.
Серия Broadcom Tomahawk: Король пропускной способности и экосистемы
Серия коммутаторов StrataXGS Tomahawk от Broadcom является «фактически стандартом» для мирового рынка коммерческих коммутаторов центров обработки данных.
Tomahawk 4 (TH4): Будучи первым в отрасли широко распространенным чипом с пропускной способностью 25.6 Тбит/с, TH4 использует 7-нм техпроцесс, при этом один чип поддерживает 64 порта 400G. Его архитектура ориентирована на экстремальную пропускную способность и энергоэффективность, используя архитектуру с разделенной памятью (Sliced Memory Architecture ). Хотя эта архитектура может столкнуться с проблемами при обработке крайне неравномерного трафика (Incast), ее зрелость и экономические преимущества делают ее лучшим выбором для крупных компаний, строящих сети Spine-Leaf.
Tomahawk 5 (TH5): Благодаря использованию 5-нм техпроцесса пропускная способность удваивается до 51.2 Тбит/с. TH5 — это не просто увеличение пропускной способности, но и расширенные возможности для рабочих нагрузок ИИ, такие как аппаратная динамическая балансировка нагрузки (DLB) и более точная телеметрия. Один чип TH5 поддерживает 64 порта 800G или 128 портов 400G, что значительно упрощает сетевую топологию и сокращает количество переходов.
Tomahawk Ultra: Выпущена новая архитектура для масштабируемых сетей искусственного интеллекта. Хотя бренд продолжает линейку Tomahawk, ядро было переработано. Broadcom заявляет о достижении повторной передачи на канальном уровне (LLR) и управления потоком на основе кредитов (CBFC), стремясь воспроизвести характеристики передачи данных без потерь InfiniBand на Ethernet с задержкой, сниженной до уровня 250 нс, в основном ориентируясь на решение NVIDIA Spectrum-X.
Платформа NVIDIA Spectrum: комплексная архитектура, созданная для искусственного интеллекта.
Коммутационные чипы серии Spectrum от NVIDIA (ранее Mellanox) изначально разрабатывались не просто для «передачи данных», а для «ускорения вычислений».
Полностью разделяемый буфер: В отличие от разделенной архитектуры Broadcom, серия Spectrum (например, Spectrum-3 и Spectrum-4) использует архитектуру с динамическим разделяемым буфером. Это означает, что все порты используют одну и ту же встроенную память. При перегрузке порта (например, в случае микроимпульсной нагрузки) он может динамически использовать все свободные ресурсы кэша чипа. Такая конструкция значительно снижает вероятность потери пакетов и обеспечивает более предсказуемую производительность в условиях трафика типа «многие к одному», характерного для обучения ИИ.
Spectrum-4: Использует техпроцесс TSMC 4N, обеспечивая пропускную способность 51.2 Тбит/с. Помимо высокой пропускной способности, его наиболее примечательными особенностями являются точность синхронизации часов на уровне наносекунд (улучшенная на 5-6 порядков) и телеметрия «Что только что произошло» (WJH). WJH захватывает и передает подробные контексты сбоев (например, конкретные причины падения, затронутые характеристики потока), а не простую сводную статистику, что имеет решающее значение для устранения неполадок в сложных распределенных системах обучения ИИ.
Cisco Silicon One: стремление к унифицированной архитектуре
Архитектура Silicon One от Cisco призвана преодолеть бинарное противопоставление в традиционных сетях между «маршрутизаторами» (большой буфер, низкая пропускная способность, сложные функции) и «коммутаторами» (небольшой буфер, высокая пропускная способность, простые функции).
Архитектура Q100/G100: G100 — флагманский чип Cisco для рынка коммутации веб-масштаба, основанный на 7-нм техпроцессе и обеспечивающий пропускную способность 25.6 Тбит/с. Его ключевое новшество заключается в конвейере обработки «от начала до конца» и унифицированном общем кэше на кристалле. Cisco утверждает, что G100 — первый в отрасли продукт, обеспечивающий полностью общую буферизацию пакетов на высокоскоростном коммутаторе в сочетании с программируемостью P4, что делает его подходящим как для высокопроизводительных коммутаторов ToR, так и для узлов Spine, требующих сложных функций маршрутизации.
Многофункциональность: Silicon One может переключаться между «режимом маршрутизации» и «режимом коммутации» с помощью конфигурации микрокода, что позволяет клиентам охватывать все сценарии от периферии DCI до ядра центра обработки данных с помощью единой аппаратной архитектуры, значительно упрощая управление запасными частями и снижая сложность эксплуатации.
Таблица 3.1: Сравнение архитектур основных коммутационных чипов 400G/800G
| Функция/Метрика | Broadcom Tomahawk 4 | NVIDIA Спектр-3 | NVIDIA Спектр-4 | Cisco Silicon One G100 | Broadcom Tomahawk 5 |
| Разработка | 7nm | 16nm | 4N (TSMC) | 7nm | 5nm |
| Максимальная вместимость | 25.6 Tbps | 12.8 Tbps | 51.2 Tbps | 25.6 Tbps | 51.2 Tbps |
| Плотность 400 г | 64 порты | 32 порты | 128 порты | 64 порты | 128 порты |
| Буферная арка | Распределенный/Сегментированный | Полностью общий | Полностью общий | Полностью общий | Распределенный/Сегментированный |
| Оптимизация ИИ/высокопроизводительных вычислений. | Базовый RoCE | RoCE Opt., WJH | Spectrum-X, наночасы | P4 Prog., Adv. Flow Ctrl | Когнитивная маршрутизация, ДЛБ |
| Типовая задержка | ~500 нс | <400 нс | ~500 нс | ~600 нс | ~500 нс |
| Сценарии | Облачный хребет/Лист | Высокопроизводительные вычисления, хранение данных для ИИ, финансы | Крупные кластеры ИИ, суперкомпьютеры | Маршрутизация в облаке, конвергентная архитектура | Кластеры искусственного интеллекта нового поколения, магистраль 800G. |
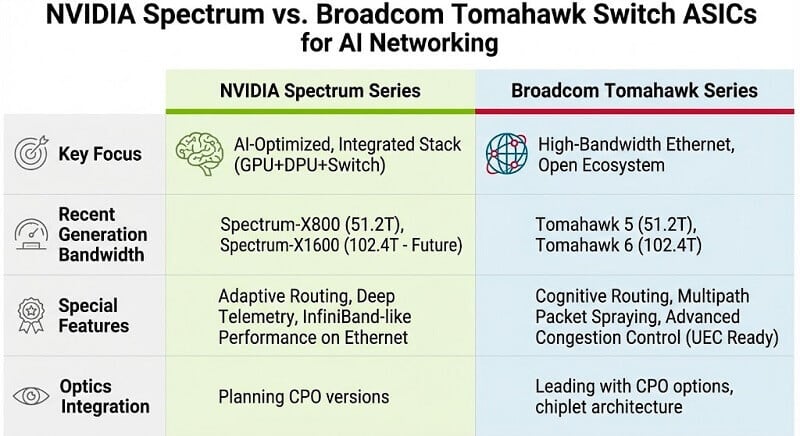
Трансформация сетевой архитектуры в эпоху искусственного интеллекта: от стратегии «наилучших усилий» к стратегии нулевой потери пакетов.
Распространение коммутаторов 400G — это не просто модернизация оборудования, а реконструкция стека сетевых протоколов и топологии. Основная цель — достижение производительности уровня InfiniBand по Ethernet, то есть «сети без потерь».
Игра RoCEv2 и алгоритмы управления перегрузкой
RoCEv2 (RDMA over Converged Ethernet version 2) позволяет приложениям напрямую обращаться к удаленной памяти, минуя ядро ЦП, что обеспечивает сверхнизкую задержку и загрузку ЦП. Однако RoCEv2 полагается на передачу без потерь в базовой сети. При потере пакетов механизм повторной передачи RDMA (Go-back-N) приводит к резкому снижению пропускной способности.
Традиционный алгоритм управления потоком на основе приоритетов (PFC) предотвращает потерю пакетов с помощью примитивных «кадровых пауз», но это легко приводит к «блокировке в начале очереди» и «распространению перегрузки», потенциально вызывая тупиковые ситуации. Поэтому интеллектуальные алгоритмы управления перегрузкой на основе явного уведомления о перегрузке (ECN) стали предметом конкуренции среди ведущих поставщиков.
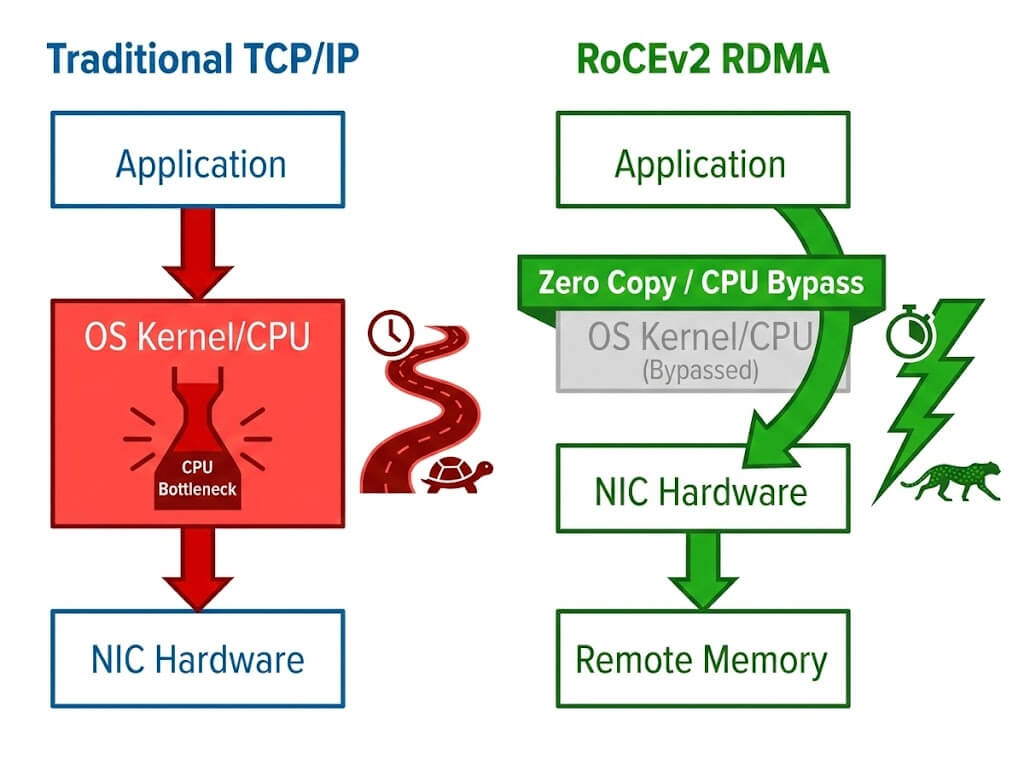
4.1.1 DCQCN (Data Center Quantized Congestion Notification): В настоящее время это самый простой алгоритм управления перегрузкой RoCEv2. Он сочетает в себе ECN и PFC; когда коммутатор обнаруживает очередь, превышающую пороговое значение, он помечает её с помощью ECN. Принимающая сетевая карта отправляет отправителю пакет уведомления о перегрузке (CNP), и отправитель снижает скорость передачи данных. Ограничение: Традиционные параметры DCQCN (Kmin, Kmax, Pmax) конфигурируются статически. В сценариях обучения ИИ с резкими колебаниями трафика статические пороговые значения либо реагируют слишком медленно (что приводит к потере пакетов), либо чрезмерно (что приводит к снижению пропускной способности).
4.1.2 Huawei iLossless (интеллектуальная обработка без потерь): Huawei внедрила чипы искусственного интеллекта в коммутаторы серии CloudEngine, реализуя динамическую настройку пороговых значений ECN с помощью алгоритма iLossless. Механизм: Коммутатор в режиме реального времени изучает модели трафика (идентифицирует большие/малые потоки, степень инкастинга) и динамически регулирует пороговые значения ECN. Huawei утверждает, что этот алгоритм обеспечивает нулевую потерю пакетов, одновременно повышая пропускную способность до 100% и значительно сокращая задержку в длинном хвосте.
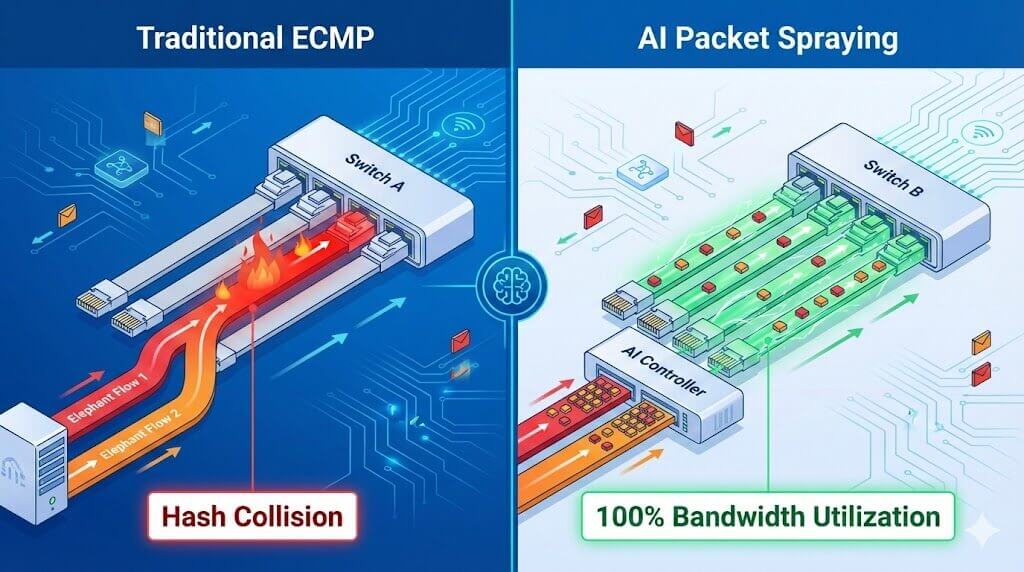
4.1.3 Ruijie RALB (Rail-aware Adaptive Load Balancing) & NFIM: Компания Ruijie разработала технологию RALB специально для многоканальных характеристик кластеров ИИ. Механизм: Традиционная ECMP (Equal-Cost Multi-Path routing) основана на выборе хеша, что приводит к коллизиям хешей (некоторые каналы перегружены, а другие свободны). RALB отслеживает качество канала в реальном времени (уровни перегрузки) и выполняет динамическую балансировку нагрузки для каждого пакета , распределяя пакеты по наиболее свободным каналам, тем самым повышая коэффициент использования полосы пропускания до более чем 97.6%. В сочетании с NFIM (Nanosecond Flow Intelligent Control Module) она может выполнять прогнозное планирование до возникновения перегрузки.
4.1.4 Архитектура H3C SeerNetwork и DDC: Компания H3C представила решение на основе DDC (Distributed Disaggregated Chassis) для полного решения проблемы перегрузки сети. Механизм: Архитектура DDC физически разделяет линейные карты и коммутационную матрицу коммутатора шасси, соединяя их оптическими волокнами. Во время пересылки данных используется технология Spray Link для разделения пакетов и их равномерного распределения по всем восходящим каналам, что физически исключает коллизии хэшей и теоретически обеспечивает 100% неблокирующую производительность.
Топология сети: Клоуз против многорельсовой системы
Традиционная архитектура Clos (Spine-Leaf): подходит для обычных вычислительных задач. Серверы подключаются через одну сетевую карту, а трафик агрегируется на уровне магистрали (Spine).
Многоканальная архитектура для ИИ: Современные серверы для ИИ (например, NVIDIA HGX H100) обычно оснащены 8 графическими процессорами и 8 сетевыми картами. В многоканальной архитектуре создаются 8 независимых физических сетевых плоскостей (Rails). Графический процессор 0 каждого сервера подключается к сети Rail 0, графический процессор 1 — к Rail 1 и так далее. Такая конструкция позволяет осуществлять связь между графическими процессорами (особенно All-Reduce) полностью в рамках одной и той же Rail, проходя только через один уровень коммутатора ToR, что значительно снижает задержку и вероятность коллизий. В этой архитектуре в качестве узлов Leaf высокой плотности обычно используются коммутаторы 400G.
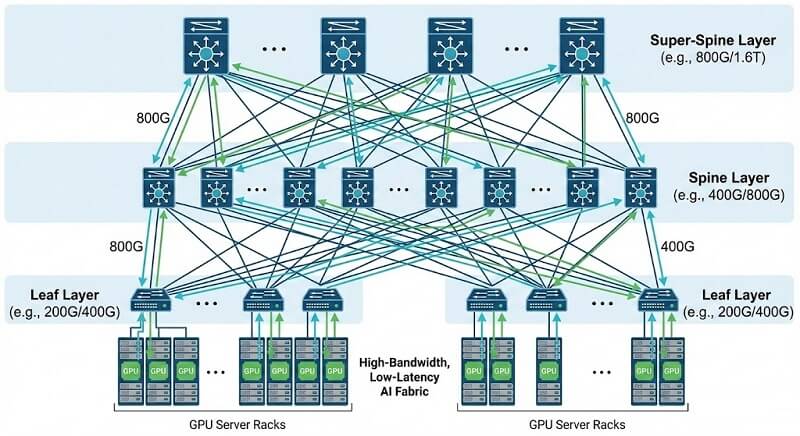
Анализ конкурентоспособности основных мировых поставщиков коммутаторов 400G
NVIDIA (Mellanox): создатель сетей искусственного интеллекта
Основные продукты: SN4000 (Spectrum-3), SN5600 (Spectrum-4).
Позиция на рынке: Абсолютное доминирование на рынке сетевых решений для искусственного интеллекта (объединение InfiniBand и Ethernet).
Конкурентные преимущества:
- Полнофункциональная экосистема: Единственный поставщик, предлагающий GPU + DPU + NIC + Switch + NOS (Cumulus/SONiC) + Management Software (UFM/NetQ).
- Спектрум-X: Использует BlueField-3 DPU в качестве «суперсетевого адаптера» в сочетании с коммутаторами Spectrum-4 для достижения производительности, значительно превосходящей стандартный Ethernet, благодаря точному измерению RTT (времени кругового пути) и прямому доступу к памяти.
- Телеметрия: WJH (What Just Happened) обеспечивает видимость неисправностей на уровне микросхем, что является настоящим спасением для работы с крупными кластерами искусственного интеллекта.
- Минусы: Относительно дорого; экосистема относительно закрытая (хотя основана на Ethernet, оптимальная производительность зависит от всего их стека).
Arista Networks: лучший выбор для облачных гигантов.
Основные продукты: 7060X5 (TH5 Leaf), 7800R3 (Jericho 2 Spine/DCI).
Позиция на рынке: Чрезвычайно высокая доля в сегменте фронтенд-сетей и среди крупных облачных провайдеров; активное проникновение в сегмент бэкенд-сетей для ИИ.
Конкурентные преимущества:
- Операционная система EOS: Признана самой стабильной и открытой сетевой ОС в отрасли. Единый образ адаптируется ко всему оборудованию, значительно упрощая эксплуатацию.
- Архитектура глубокого буфера: В серии 7800R используются микросхемы глубокого буфера на базе Broadcom DNX с кэшированием VOQ (виртуальной выходной очередью) на уровне гигабайт, что идеально подходит для межсоединений центров обработки данных (DCI) и сценариев с крайне неравномерным трафиком.
- DLB и Etherlink: В серии 7700R4 компания Arista представила распределенную технологию Etherlink для оптимизации эффективности межсоединений в крупномасштабных кластерах.
Cisco Systems: трансформация гиганта
Основные продукты: Nexus 9300-GX2 (листовой), Nexus 9800 (модульный каркас).
Конкурентные преимущества:
Собственная разработка Silicon One Chip: освобождение от зависимости от Broadcom, достижение архитектурной дифференциации и контроль затрат. Высокая пропускная способность и программируемость чипов G100/G200 обеспечивают большую гибкость.
Синергия оптики и электроники: После приобретения компании Acacia, Cisco накопила значительный опыт в области технологий оптических модулей, предлагая проверенные интегрированные решения «коммутатор + оптический модуль», что имеет большое значение для обеспечения стабильности оптических каналов связи в эпоху 400G/800G.
Обширная база корпоративных клиентов: Обеспечивает плавный переход (архитектура ACI или режим NX-OS) для клиентов, переходящих от традиционных корпоративных сетей к сетям на основе искусственного интеллекта.
Huawei: Интегратор технической мощи
Основные продукты: CloudEngine 16800 Series (модульные), CE8800/9800 (стационарные).
Конкурентные преимущества:
- Алгоритм iLossless AI: Внедрение вычислительных мощностей искусственного интеллекта в плоскость управления коммутатором для динамической оптимизации параметров управления потоком является ключевым конкурентным преимуществом Huawei в области Ethernet без потерь.
- Аппаратное проектирование: В CE16800 используется ортогональная конструкция объединительной платы, эффективное рассеивание тепла и передовая технология питания, что позволяет развертывать чрезвычайно большое количество портов 400G/800G с превосходной энергоэффективностью системы.
- Автономность: Обладает собственными чипами серии Solar и полным набором программного и аппаратного обеспечения, обеспечивающим высокую надежность цепочки поставок (для конкретных рынков).
H3C и Ruijie: соотношение цены и качества, а также настройка сценариев использования.
H3C: Опираясь на архитектуру SeerNetwork, компания делает акцент на интеллектуальном управлении. Коммутаторы серии S9825 демонстрируют сбалансированные показатели плотности и энергопотребления. H3C также активно занимается исследованием технологии CPO, демонстрируя прототипы маломощных кремниевых фотонных устройств в корпусе.
Ruijie: Компания Ruijie тесно сотрудничает с крупными интернет-компаниями (например, ByteDance, Alibaba), предлагая исключительную гибкость. Серия RG-S6900 ориентирована на «интеллектуальную скорость» DCN, решая проблемы развертывания и настройки крупномасштабных сетей с помощью функций RALB и «однокнопочного RoCE». Ruijie оперативно реагирует на запросы в отношении продуктов Whitebox и специализированных продуктов ODCC.
Рыночные данные и экономический анализ
Размер рынка и тенденции роста
Согласно последним данным IDC и Dell'Oro Group, мировой рынок коммутаторов Ethernet сохранил устойчивый рост в 2024 году.
- Общий размер: В третьем квартале 2024 года выручка рынка коммутаторов для центров обработки данных выросла более чем на 30% по сравнению с аналогичным периодом прошлого года, при этом подавляющая часть прироста пришлась на сети бэкэнда, связанные с искусственным интеллектом.
- Портовые отгрузки: Порты 400G стали абсолютным мейнстримом, на их долю приходится половина общей пропускной способности центров обработки данных. Хотя база для портов 800G невелика, темпы роста в квартальном исчислении приближаются к 100%, и ожидается, что к 2025 году развертывание в кластерах ИИ превысит 400G.
- Доли поставщиков: Cisco по-прежнему лидирует по общему объему выручки на рынке, но сталкивается с сокращением доли. Arista следует за ней в секторе центров обработки данных (особенно в сегменте 100G/400G). NVIDIA демонстрирует наиболее быстрый рост, доминируя на отдельных нишевых рынках ИИ с решениями InfiniBand и Spectrum Ethernet. На китайском рынке Huawei, H3C и Ruijie прочно удерживают три верхние позиции.
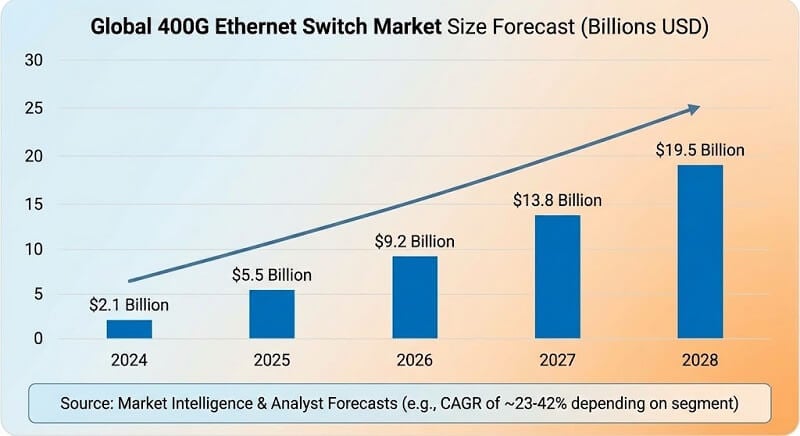
Тенденции изменения стоимости и энергопотребления
Стоимость за бит: Благодаря развитию цепочки поставок оптических модулей 400G, стоимость одного порта 400G значительно ниже, чем суммарная стоимость четырех портов 100G, что позволяет сэкономить на затратах на оптоволоконные кабели и упростить техническое обслуживание.
Проблемы с энергопотреблением: Несмотря на повышение энергоэффективности на Гбит/с для 400G, общее энергопотребление одного коммутатора резко возросло. Коммутатор форм-фактора 2U, полностью загруженный 64 портами 400G, обычно потребляет 1500–2000 Вт (включая оптические модули). Это создает серьезные проблемы для электропитания шкафа и отвода тепла, что стимулирует исследования и разработки коммутаторов с жидкостным охлаждением.
Таблица 6.1: Оценка энергопотребления для основных коммутаторов 400G (типичная полная нагрузка)
| Производитель | Модель | Конфигурация порта | Типичная потребляемая мощность системы (приблизительно с учетом оптики) | Тепловой дизайн |
| H3C | С9825-64Д | 64x 400 г | ~1850 Вт (макс.) / ~613 Вт (тип. без питания) | Вентиляторы с возможностью горячей замены, обеспечивающие обдув спереди и сзади. |
| Руиджи | RG-S6980-64QC | 64x 400 г | ~2400 Вт (макс.) / ~1760 Вт (тип.) | 4+1 резервных вентилятора, интеллектуальная регулировка скорости |
| NVIDIA | SN5600 | 64x 800G/400G | ~670 Вт (только система, без оптики) | Высокоэффективный воздушный поток, опция AOC/DAC. |
| Huawei | CE16800 | Модульная (48 карт по 400 ГБ) | Примерно 800 Вт и более на карту (зависит от конфигурации) | Ортогональная арка, смешанное жидкостное охлаждение |
Перспективы на будущее: 800G, UEC и интеграция оптоэлектроники.
Эволюция до 800G и 1.6T
С выходом графических процессоров NVIDIA Blackwell и ускорителей искусственного интеллекта следующего поколения потребность в пропускной способности одной видеокарты подскочит до 800 Гбит/с и выше.
- Эра 800G: 2025 год станет годом прорыва для 800G Ethernet. Коммутаторы на базе Tomahawk 5 и Spectrum-4 будут широко развернуты на уровне ядра (Spine) кластеров искусственного интеллекта.
- Прогноз на 1.6 Тл.: Ожидается, что к 2026-2027 годам, с коммерциализацией чипов следующего поколения, таких как Tomahawk 6 (102.4 Тл), интерфейсы 1.6 Тл начнут внедряться в гипермасштабные кластеры.
Возникновение UEC (консорциума Ultra Ethernet)
Чтобы打破 монополию InfiniBand и решить традиционные проблемы Ethernet в сценариях с использованием ИИ, такие гиганты, как AMD, Arista, Broadcom, Cisco, Meta и Microsoft, совместно основали UEC.
Цель: Разработать протокол транспортного уровня Ethernet следующего поколения, ориентированный на искусственный интеллект, улучшив RoCEv2 за счет внедрения многопутевого распространения пакетов, гибких механизмов повторной передачи и более эффективного управления перегрузкой. Будущие коммутаторы 400G/800G будут повсеместно поддерживать стандарты UEC, полностью устраняя риски «потерь» данных в Ethernet.
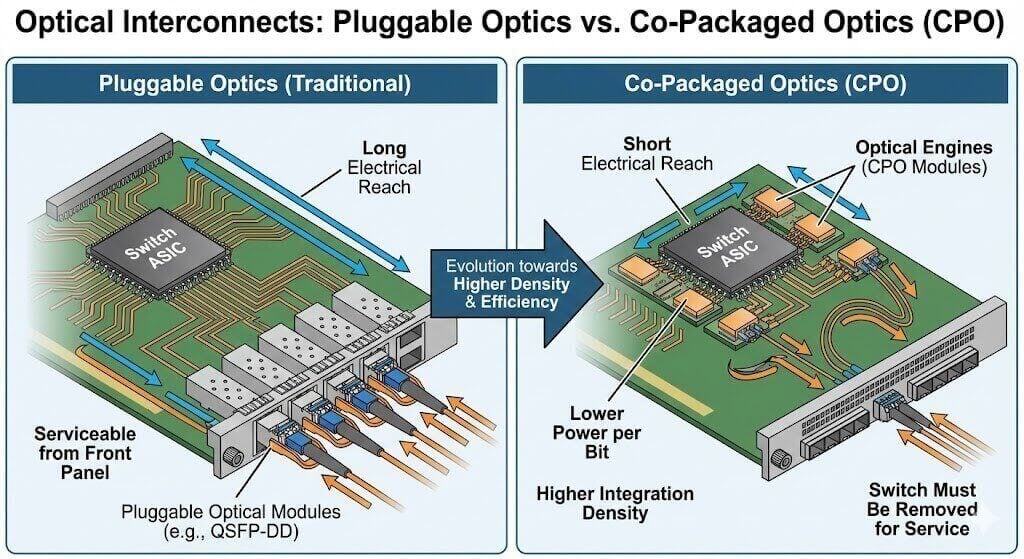
CPO (Co-Packaged Optics) против LPO (Linear Drive Pluggable Optics)
Для преодоления физических ограничений электрических соединений (ограничения по расстоянию в SerDes) и снижения энергопотребления, оптоэлектронная интеграция является перспективным направлением.
CPO: Оптический модуль размещается непосредственно на подложке коммутационного чипа. Несмотря на отличную энергоэффективность, из-за сложностей с обслуживанием (оптические модули не поддерживают горячую замену), в настоящее время он применяется лишь в ограниченном количестве сценариев сверхвысокой плотности (например, 51.2 Тл и выше); массовое внедрение займет время.
LPO: В качестве переходного решения к CPO, LPO исключает чип DSP из оптического модуля, используя мощные SerDes микросхемы коммутатора для непосредственного управления оптическими компонентами. Это значительно снижает энергопотребление и задержку, сохраняя при этом возможность подключения дополнительных устройств, что делает это решение актуальным техническим трендом на современном рынке 400G/800G.
Заключение
Рынок коммутаторов Ethernet 400G находится на золотую середину между технологическими инновациями и масштабируемым применением. Искусственный интеллект не только потребляет пропускную способность, но и является катализатором реконструкции сетевой архитектуры.
- Технический аспект: «Без потерь», «Низкая задержка» и «Видимость» стали новыми трехмерными стандартами измерения производительности коммутаторов. Архитектуры с общими буферами, интеллектуальные алгоритмы управления перегрузкой (например, iLossless, RALB) и возможности телеметрии на аппаратном уровне являются ключевыми факторами, отличающими высокопроизводительные коммутаторы с искусственным интеллектом от коммутаторов общего назначения.
- Аспект рынка: Несмотря на то, что NVIDIA лидирует в разработке комплексных решений на основе ИИ, Arista, Cisco и китайские производители (Huawei, H3C, Ruijie) создают мощный рынок Ethernet с открытыми экосистемами, оптимальным соотношением цены и производительности, а также дифференцированными программными функциями, постепенно оттесняя InfiniBand с рынка.
Для предприятий и организаций, выбирающих коммутаторы 400G, внимание должно ограничиваться не только плотностью портов и ценой, но и тщательной оценкой фактической производительности в средах RoCEv2, зрелости алгоритмов управления перегрузкой и совместимости с существующими платформами для вычислений с использованием ИИ. С развитием стандартов UEC и появлением 800G ускоряется формирование более открытой, эффективной и интеллектуальной экосистемы Ethernet.
Сопутствующие товары:
-
 Коммутатор Ethernet 4700GbE 2U открытого типа на базе NVIDIA MSN3-WS400FC Spectrum-1 с Cumulus Linux, 32 портами QSFP-DD, 2 блоками питания переменного тока, процессором x86, стандартной глубиной, системой вентиляции P2C, комплектом направляющих
$28900.00
-
Открытый Ethernet-коммутатор NVIDIA SN5400 Spectrum-4 400GbE 2U с аутентификацией Cumulus Linux, 64 порта QSFP56-DD, 2 порта SFP28, 2 блока питания переменного тока, процессор x86, безопасная загрузка, стандартная глубина, система воздушного потока C2P, комплект направляющих без инструментов
$39000.00
-
Коммутатор NVIDIA MQM9790-NS2F Quantum-2 NDR InfiniBand, 64 порта 400 Гбит/с, 32 отсека OSFP, неуправляемый, воздушный поток P2C (вперед)
$30000.00
-
Коммутатор NVIDIA MQM9700-NS2R Quantum-2 NDR InfiniBand, 64 порта NDR 400 Гбит/с, 32 порта OSFP, управляемый, воздушный поток P2C (обратный)
$35000.00
-
Коммутатор NVIDIA MQM9700-NS2F Quantum-2 NDR InfiniBand, 64 порта 400 Гбит/с, 32 порта OSFP, управляемый, P2C Airflow (вперед)
$35000.00
-
Коммутатор NVIDIA MQM9790-NS2R Quantum-2 NDR InfiniBand, 64 порта NDR 400 Гбит/с, 32 порта OSFP, неуправляемый, воздушный поток P2C (обратный)
$30000.00