
В крупнейшем на сегодняшний день обучающем цикле OpenAI использовалось более 100 000 графических процессоров в инфраструктуре Stargate в Техасе. Все тестируют GPT-6 Astra. Гораздо меньше людей задаются вопросом, какая сеть потребовалась для подключения кластера с шестизначным числом графических процессоров.
Ответ сложнее, чем просто сказать: «100 000 графических процессоров равны 100 000 800-гигабитным оптическим модулям».
Количество графических процессоров общедоступно. Точный набор аппаратных компонентов и спецификация оптики не разглашаются.
Чтобы понять, какие требования к оптическим межсоединениям может предъявить инфраструктура искусственного интеллекта масштаба Astra, нам необходимо отделить фактически раскрытые OpenAI и NVIDIA от того, что можно рассчитать, используя эталонные архитектуры NVIDIA и Cisco.
100 000 графических процессоров — а не 100 000 систем.
В прошлый четверг компания OpenAI выпустила GPT-6 Astra. Несколько дней спустя генеральный директор NVIDIA Дженсен Хуанг сообщил о запуске, написав, что Astra была обучена примерно на «более чем 100 000» графических процессорах NVIDIA Grace Blackwell NVLink72 и что к сети подключатся еще 400 000 графических процессоров.
Формулировка вызвала некоторую путаницу, поскольку «NVL72» описывает стоечную систему, содержащую 72 графических процессора Blackwell, а не отдельный графический процессор.
Наиболее ясный ответ даёт собственная презентация OpenAI.
Эйдан Кларк, вице-президент OpenAI по исследованиям, сообщил журналистам, что Astra стала крупнейшим в истории компании циклом обучения и впервые позволила OpenAI предварительно обучить модель на более чем 100 000 графических процессорах на своей площадке Stargate в Техасе.
Таким образом, число в заголовке следует интерпретировать следующим образом:
Более 100 000 графических процессоров — а не 100 000 стоек NVL72.
Если бы все 100 000 графических процессоров были размещены на полностью укомплектованных системах NVL72 с 72 графическими процессорами, теоретическим эквивалентом было бы следующее:
100 000 ÷ 72 ≈ 1,389 стоек NVL72
или примерно 1,400 полностью укомплектованных стоек NVL72.
Это следует рассматривать как расчет эквивалентного количества стоек, а не как подтвержденное физическое количество стоек. Компания OpenAI не раскрыла публично точную комбинацию систем GB200, GB300 или других систем Grace Blackwell, используемых в обучающем кластере Astra.
Шкала обучения Астра
| Метрика | Приблизительный масштаб |
| Графические процессоры, используемые для предварительного обучения Astra | 100,000+ |
| Полноразмерный стоечный аналог NVL72 | ~1600 |
| Графические процессоры на стойку NVL72 | 72 |
| Дополнительные графические процессоры, упомянутые Дженсеном Хуангом. | 400,000 |
Рисунок 1. Конфигурация стойки NVIDIA NVL72.
В полной стойке NVL72 размещается 72 графических процессора Blackwell, соединенных через NVIDIA NVLink. Точная топология развертывания Astra не была обнародована, поэтому приблизительно 1,400 стоек следует понимать как эквивалентный расчет, а не как подтвержденное количество объектов на площадке.
Внутри стойки — отсутствие оптических модулей в сети NVLink.
Это звучит нелогично, но это одно из важнейших отличий в инфраструктуре искусственного интеллекта стоечного масштаба.
Внутри систем NVIDIA GB200 и GB300 NVL72 72 графических процессора взаимодействуют через сеть NVIDIA NVLink, используя коммутаторы NVLink и пассивную медную кабельную объединительную плату.
Для работы домена NVLink между графическими процессорами не требуются подключаемые оптические приемопередатчики.
Это не означает, что в стойке NVL72 вообще нет оптических модулей. Оптические трансиверы могут быть установлены в сетевые интерфейсы ConnectX или BlueField, используемые для подключения стойки к внешним вычислительным, запоминающим и управляющим сетям.
Разница заключается в следующем:
Внутри стойки используется кабельная сеть NVLink для масштабирования: медный провод.
Масштабируемая вычислительная сеть между стойками: высокоскоростные сетевые интерфейсы, которые могут использовать оптические трансиверы.
Медь является оптимальным вариантом для коротких расстояний внутри стойки, поскольку позволяет избежать ненужного преобразования электрического сигнала в оптический, обеспечивая при этом чрезвычайно высокую пропускную способность и относительно низкое энергопотребление для соединений на коротких расстояниях.
Когда трафик должен покинуть стойку и пройти через более крупный кластер ИИ, оптическая связь приобретает все большее значение, поскольку оптоволокно обеспечивает большую дальность действия, высокую плотность портов и более эффективное развертывание крупномасштабных сетевых топологий.
Граница, которая имеет значение
Масштабирование GPU внутри стойки: NVLink по пассивной медной инфраструктуре.
Масштабирование GPU между стойками: сетевые интерфейсы ConnectX, соединенные через сети InfiniBand или Ethernet, как правило, с использованием высокоскоростных оптических каналов связи в крупных развертываниях.
Сегодня эта граница важна, но её не следует рассматривать как постоянную. Такие технологии, как интегрированная оптика, оптика, расположенная близко к корпусу, и оптический ввод-вывод, в конечном итоге могут приблизить оптическую связь к вычислительному блоку.
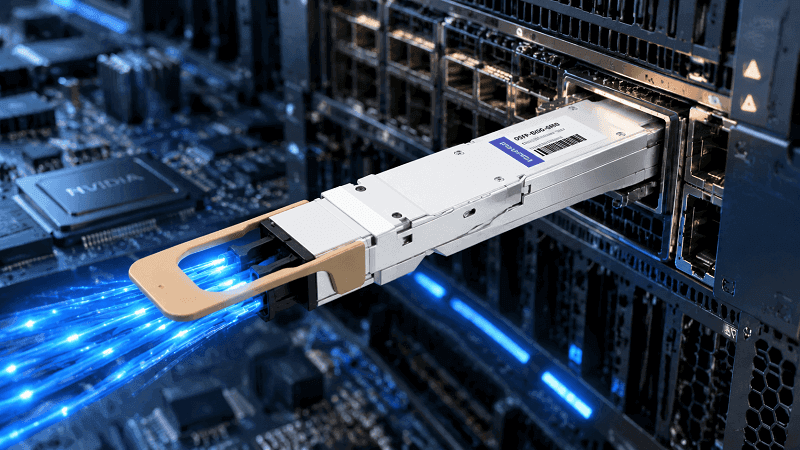
Вне стойки — примерно один сетевой порт на стороне узла на каждый графический процессор.
Именно отсюда и происходит первоначальная идея «один графический процессор, один оптический модуль», но здесь есть важное различие между поколениями.
GB200 NVL72: 400 ГБ на каждый графический процессор.
Архитектура NVIDIA DGX GB200 NVL72 содержит 18 вычислительных блоков.
На каждом подносе находится:
- 4 XNUMX графических процессоров Blackwell
- 4 сетевых адаптера NVIDIA ConnectX-7
- Каждый интерфейс ConnectX-7 поддерживает вычислительно-сетевое соединение со скоростью 400 Гбит/с.
Вот и вся конструкция:
72 графических процессора → 72 вычислительно-сетевых порта ConnectX-7 400G
В оптической реализации вычислительной сети это примерно соответствует одному оптическому приемопередатчику 400G на стороне узла на каждый графический процессор.
GB300 NVL72: 800 ГБ на каждый графический процессор.
В новом поколении GB300 NVL72 изменен сетевой уровень.
Каждый вычислительный блок GB300 включает в себя четыре сетевых адаптера ConnectX-8 для своих четырех графических процессоров.
Каждый порт ConnectX-8 поддерживает скорость 800 Гбит/с и может быть сконфигурирован следующим образом:
1 × 800 г → 2 × 400 г
Затем два канала 400G могут быть подключены к двум отдельным вычислительным сетевым плоскостям.
Это дает:
72 графических процессора → 72 хост-порта ConnectX-8 800G
и в эталонной оптической архитектуре Cisco:
72 графических процессора → 72 двухпортовых оптических модуля 800G на стороне узла
Сравнение сетевых технологий GB200 и GB300
| Архитектура | Сетевой адаптер GPU | Скорость хост-порта | Эталонная оптическая архитектура |
| ГБ200 НВЛ72 | КоннектX-7 | 400G | ~1 × 400G оптический модуль на каждый графический процессор |
| ГБ300 НВЛ72 | КоннектX-8 | 800G | ~1 × двухпортовый оптический разъем 800G на каждый графический процессор |
| Прорыв GB300 | КоннектX-8 | 2 × 400G | Один канал 400G к каждой вычислительной плоскости |
Это различие имеет значение при оценке количества оптических приемопередатчиков, установленных за спутником GPT-6 Astra.
Компания OpenAI подтвердила наличие более 100 000 графических процессоров, но не раскрыла публично точное соотношение GB200/GB300, а также полную спецификацию сети.
Таким образом, технически обоснованный вывод таков:
Если бы более 100 000 графических процессоров Astra были соединены с помощью подключаемых оптических трансиверов в соответствии с существующими эталонными архитектурами NVL72, то только на стороне узла потребовалось бы порядка 100 000 позиций для оптических модулей.
Однако эти модули не следует автоматически классифицировать как модули 800G.
Если бы использовалась сеть класса GB200, многие каналы связи на стороне узлов были бы 400G. Если бы использовалась сеть класса GB300, соответствующие интерфейсы хоста могли бы быть портами 800G ConnectX-8.
Количество дискретных приемопередатчиков также может зависеть от активных оптических кабелей, медных соединений прямого подключения или других специализированных решений для гипермасштабных сетей.
Рисунок 2. От стоек NVL72 до оптических интерфейсов на стороне узла.
В одной полноразмерной стойке NVL72 размещается 72 графических процессора. Внутренняя масштабируемая сеть NVLink выполнена по медному кабелю. Каждый графический процессор имеет масштабируемый сетевой интерфейс: 400G с ConnectX-7 в GB200 или 800G с ConnectX-8 в GB300.
Приблизительно на 100 000 графических процессоров это означает примерно 100 000 высокоскоростных сетевых портов на стороне узла, но не обязательно 100 000 идентичных оптических модулей 800G.
Реальное количество оптических сигналов выше.
Оптические компоненты на стороне узла — это лишь одна часть большой сети искусственного интеллекта.
Для работы коммутаторов также требуются оптические интерфейсы, а большие кластеры содержат дополнительные соединения типа «лист-магистраль», сети хранения данных, фронтенд-сети, сети управления и соединения с серверами поддержки.
В эталонной архитектуре Cisco N9000 Enterprise для GB300 NVL72 масштабирование становится более наглядным.
Для развертывания системы GB300 с 288 графическими процессорами в четырех стойках , полный перечень компонентов от Cisco включает:
- 288 модулей OSFPR-800G-DR8 с радиатором для установки на землю со стороны узла
- 1,112 ОСФП-800G-DR8 модули со встроенным радиатором в других частях архитектуры
- Дополнительные оптические трансиверы 400G, 200G и 100G для конвергентных сетей, хранения данных, поддержки и управления.
Это не означает, что каждый кластер из 100 000 графических процессоров будет использовать одно и то же соотношение.
Крупные операторы связи могут использовать различные топологии коммутаторов, коэффициенты переподписки, протяженность оптоволоконных линий, типы кабелей, конструкции систем хранения данных или специализированное сетевое оборудование.
Но направление ясно:
Одного лишь количества графических процессоров недостаточно, чтобы оценить общее число оптических интерфейсов, необходимых для создания фабрики искусственного интеллекта.
Рисунок 3. Упрощенная оптическая архитектура GB300.
Количество модулей на стороне узла тесно коррелирует с количеством графических процессоров, в то время как для всей сети требуется дополнительная оптика на уровне коммутаторов доступа, магистралей, конвергентных сетей, сетей хранения и управления.
Для GB300 этот порт 800G может быть расширен до двух портов 400G.
Архитектура GB300 вносит еще одну важную деталь в сетевые возможности.
Порт 800G ConnectX-8 можно разделить на следующие части:
2 соединения по 400 Гбит/с
В архитектуре NVIDIA NVL72 Enterprise Reference Architecture используются эти два соединения 400G через двухплоскостную вычислительную сеть.
Один канал 400G соединяется с Плоскостью 1.
Другой канал 400G подключается к Plane 2.
Каждый уровень использует собственную инфраструктуру коммутаторов доступа, что обеспечивает вычислительной сети дополнительную отказоустойчивость, балансировку нагрузки и суммарную пропускную способность.
Но здесь есть важный технический нюанс.
Две плоскости сети не являются полностью независимыми от графического процессора на всем протяжении до сети.
Они по-прежнему разделяют:
- Графический процессор
- Адаптер ConnectX-8
- Порт хоста 800G
- А при использовании двухпортового оптического модуля оптический трансивер на стороне хоста
По мере прохождения по ним кабели и коммутационные узлы расходятся.
Таким образом, двухплоскостная сеть помогает защитить от сбоев в отдельных коммутационных путях и сетевых плоскостях, но она не устраняет все общие точки отказа.
Поэтому утверждение о том, что в обоих каналах используются «отдельные приемопередатчики без общей точки отказа», было бы неточным.
Архитектуру лучше описать следующим образом:
Один интерфейс хоста 800G → два сетевых канала 400G → две вычислительные плоскости
Данная конструкция обеспечивает как пропускную способность, так и отказоустойчивость.
Если один сетевой уровень становится недоступным, трафик может по-прежнему проходить через другой уровень, в зависимости от места сбоя и особенностей восстановления программного обеспечения. Производительность может снизиться, а сбой общего сетевого адаптера или оптического модуля на стороне хоста может повлиять на оба канала.
В масштабах 100 000 графических процессоров локализация сбоев имеет почти такое же значение, как и пропускная способность. Один-единственный аппаратный сбой может инициировать восстановительные работы, выходящие далеко за пределы вышедшего из строя компонента.
Рисунок 4. Один интерфейс ConnectX-8 800G, подключенный к двум плоскостям 400G.
Двухпортовый оптический модуль 800G может обеспечить два канала 400G, по одному к каждой вычислительной плоскости. Коммутатор и кабельные трассы разделены, но оба канала по-прежнему используют общую сетевую карту и оптический модуль со стороны графического процессора.
Почему необходим такой уровень избыточности
Потому что в больших масштабах неудачи перестают быть исключительными событиями.
Они становятся частью нормальной работы кластера.
Тренировочный запуск Llama 3 405B от Meta представляет собой один из лучших общедоступных документально подтвержденных примеров.
Модель Llama 3 405B была обучена с использованием 16 384 графических процессоров NVIDIA H100.
В течение 54-дневного периода предварительного обучения кластер продемонстрировал следующие результаты:
- Всего 466 перерывов в работе.
- 47 запланированных перерывов
- 419 непредвиденных перерывов
Это означает, что примерно одно неожиданное прерывание происходит каждые 3.1 часа.
Анализ причин отказов особенно полезен.
Мета сообщила:
- 148 неисправных прерываний графического процессора
- 72 сбоя памяти HBM3
- 54 программных сбоя
- 35 обрывов сетевого коммутатора/кабеля
- 32 незапланированных перерыва в обслуживании хоста
- 19 сбоев памяти SRAM графического процессора
- 17 сбоев системы GPU-процессора
- 7 перебоев, связанных с сетевой картой.
- Всего 2 сбоя процессора.
Таким образом, сетевые коммутаторы и кабели стали причиной 35 сбоев, или 8.4% от всех непредвиденных сбоев.
Это существенный показатель, но он не является самой многочисленной категорией неудач.
Проблемы, связанные с графическим процессором, оказались гораздо более значительными: по данным Meta, проблемы с графическим процессором стали причиной 58.7% неожиданных сбоев.
Лама 3 405B — Что на самом деле сломалось
| Метрика | Результат |
| Снимок обучающего процесса | 54 дней |
| Графические процессоры | 16,384 первое полугодие |
| Полные перерывы | 466 |
| Неожиданные перебои | 419 |
| Обрывы связи с сетевыми коммутаторами/кабелями | 35 |
| Доля сети в непредвиденных сбоях | 8.4% |
Заявленное количество графических процессоров в кластере GPT-6 Astra более чем в шесть раз превышает количество процессоров в кластере Llama 3 405B.
Однако было бы неправильно просто умножить частоту сбоев Meta на 6.1.
В Astra используется другое поколение оборудования, сетевая топология, программный стек, операционная среда, система управления отказами и, возможно, другие стратегии контрольных точек.
Данные Meta демонстрируют нечто более общее:
По мере увеличения размеров синхронных кластеров графических процессоров все большее значение приобретают надежность компонентов и автоматическое восстановление после сбоев.
Отдельный компонент может обладать превосходной индивидуальной надежностью, в то время как отказы в каком-либо из шестизначного парка компонентов происходят регулярно.
Именно поэтому крупные кластеры ИИ вкладывают значительные средства в:
- Сетевая телеметрия
- Мониторинг состояния связи
- Автоматическая изоляция неисправностей
- Контрольные точки
- Быстрое восстановление работы
- Резервные сетевые пути
- Предиктивное обслуживание
Компания OpenAI также заявила, что предыдущие поколения ее моделей сыграли важную роль в процессе обучения Astra.
Публичные сообщения подтверждают идею о том, что более ранние модели помогали или контролировали отдельные этапы процесса обучения. Однако недостаточно общедоступных данных, чтобы сделать вывод о том, что предыдущие модели автономно устраняли отдельные сбои в сети или оборудовании «за считанные секунды».
Главный вывод остается в силе: для работы кластера с шестизначной мощностью графических процессоров требуется гораздо больше автоматизации, чем просто установка графических процессоров и запуск задачи обучения.
Где именно располагаются оптические трансиверы в учебном кластере?
Оптические трансиверы не используются для высокоскоростной связи между графическими процессорами внутри стойки NVL72.
Эта задача принадлежит компании NVLink.
NVIDIA GB200 NVL72 создает домен NVLink с 72 графическими процессорами, обеспечивая сверхвысокую пропускную способность и низкую задержку связи внутри стойки с использованием коммутаторов NVLink и пассивных медных кабелей.
Оптические межсоединения становятся критически важными, когда система должна масштабироваться за пределы одной стойки.
Для GB200:
GPU → ConnectX-7 400G → вычислительная инфраструктура
Для GB300:
GPU → ConnectX-8 800G → 2 × 400G вычислительных плоскости
Помимо соединения "узел-лист", в следующих областях применения встречаются и другие оптические модули:
- Соединения между листьями и шипами
- Связи между позвоночником и его верхним позвоночником в более крупном масштабе
- сети хранения
- Фронтенд или конвергентные сети
- Сети управления внутри полосы пропускания
- Подключения к серверу поддержки
- межцентровое соединение
Именно поэтому потенциал роста, создаваемый инфраструктурой ИИ, нельзя рассчитать простым умножением количества поставляемых графических процессоров на единицу.
Количество графических процессоров служит полезной отправной точкой для оценки высокоскоростных портов на стороне узла.
Полный оптический спецификационный набор зависит от всей ткани.
И надёжность важна не меньше, чем количество.
Оптический модуль — это не просто позиция в спецификации материалов. Он является частью синхронной распределенной системы, в которой целостность сигнала, тепловые характеристики, частота битовых ошибок, совместимость, стабильность канала связи и восстановление после сбоев могут напрямую влиять на эффективность использования кластера.
При масштабе в 100 000 графических процессоров даже небольшое снижение надежности связи может привести к существенному улучшению операционных показателей.
В то же время, было бы преувеличением утверждать, что каждый вышедший из строя оптический модуль автоматически останавливает весь кластер. Современные архитектуры искусственного интеллекта и программное обеспечение для обучения разработаны таким образом, чтобы изолировать, перенаправлять, сохранять контрольные точки и восстанавливаться после многих типов сбоев.
Таким образом, настоящая инженерная задача заключается не в следующем:
«Может ли оптический модуль выйти из строя?»
Это:
«Сможет ли система достаточно быстро обнаружить, изолировать и восстановиться после этой ошибки, чтобы обеспечить бесперебойную работу дорогостоящих графических процессоров?»
Часто задаваемые вопросы
Сколько оптических трансиверов фактически использовала GPT-6 Astra?
Точная цифра не была обнародована.
OpenAI подтвердила, что Astra была предварительно обучена на более чем 100 000 графических процессорах. В современных эталонных архитектурах NVIDIA NVL72 на каждый графический процессор приходится примерно один высокоскоростной масштабируемый сетевой порт.
Таким образом, если бы каждое соединение, обращенное к графическому процессору, использовало отдельный подключаемый оптический приемопередатчик, то только на стороне узла могло бы потребоваться примерно 100 000 оптических модулей.
Однако их не следует автоматически классифицировать как модули 800G.
GB200 NVL72 использует вычислительно-сетевые порты ConnectX-7 400G, а GB300 NVL72 — порты ConnectX-8 800G. Точный набор аппаратных компонентов Astra пока не разглашается.
Для полного кластера потребуется значительно больше оптических интерфейсов, включая межкоммутаторные, запоминающие и другие сетевые компоненты.
Есть ли внутри стойки NVL72 оптические трансиверы?
Сама по себе сеть NVLink для связи между графическими процессорами не использует оптические приемопередатчики.
В системах GB200 и GB300 NVL72 для соединения 72 графических процессоров в домене NVLink используются коммутаторы NVLink и пассивная медная кабельная инфраструктура.
Однако в стойке по-прежнему могут размещаться оптические модули с сетевыми интерфейсами ConnectX и BlueField, используемые для подключения системы к внешним вычислительным, запоминающим и управляющим сетям.
Почему соединение GB300 800G разделяется на два канала 400G?
В эталонной архитектуре NVIDIA GB300 NVL72 каждый порт ConnectX-8 800G может быть разделен на два канала 400G.
Каждый канал 400G подключается к отдельному вычислительному сетевому уровню.
Это обеспечивает суммарную пропускную способность 800 Гбит/с, а также повышает отказоустойчивость сети и возможности балансировки нагрузки.
На сетевой стороне эти два пути разделены, но они по-прежнему используют общий графический процессор, адаптер ConnectX-8 и, как правило, двухпортовый оптический модуль 800G на стороне хоста.
Почему в NVL72 не используются оптические модули для передачи сигнала NVLink между графическими процессорами внутри стойки?
В современных системах NVL72 для внутристоечной сети NVLink используется пассивный медный кабель, поскольку расстояния невелики, а медь может обеспечить чрезвычайно высокую пропускную способность без дополнительных затрат энергии и сложности преобразования электрического сигнала в оптический.
Оптические технологии приобретают всё большее значение, когда сигналы должны передаваться на большие расстояния по масштабируемой сети центров обработки данных.
В будущем такие технологии, как оптический ввод-вывод и интегрированная оптика, могут приблизить эту границу к графическому процессору.
Ищете оптические трансиверы 400G или 800G для AI Fabrics?
Компания FiberMall предлагает оптические трансиверы OSFP и QSFP-DD 400G и 800G для высокоскоростных межсоединений в центрах обработки данных с использованием искусственного интеллекта, включая конфигурации, используемые с коммутационными матрицами ConnectX-7, ConnectX-8, InfiniBand и Ethernet.
Для развертывания крупных кластеров ИИ компания FiberMall также может оказывать поддержку в обеспечении индивидуальных потребностей в оптических модулях, ЦАП/АОК, волоконно-оптических кабелях и комплектующих.