
Будучи ведущим специалистом по продуктам и решениям для оптической связи, компания FiberMall стремится предоставлять экономически эффективные решения для глобальных центров обработки данных, облачных вычислений, корпоративных сетей, сетей доступа и беспроводных систем. Благодаря нашему опыту в области сетей связи с использованием искусственного интеллекта (ИИ) мы являемся идеальным партнером для тех, кто ищет высококачественные и выгодные решения для оптической связи. В этой статье мы подробно рассмотрим развивающийся мир архитектур сетей ИИ, уделив особое внимание ключевым вопросам горизонтального и вертикального масштабирования. Мы рассмотрим прогнозы на 2028 год, выделив тенденции в области высокой пропускной способности, высокой радиксности, высокой надежности, малой задержки, низкого энергопотребления и низкой стоимости. Чтобы узнать больше о том, как FiberMall может удовлетворить ваши потребности в сетях ИИ с помощью современных оптических межсоединений, посетите наш официальный сайт или свяжитесь с нашей службой поддержки клиентов.
Сети ИИ стремительно развиваются, и понимание различий между горизонтальным и вертикальным масштабированием критически важно для обеспечения будущего вашей инфраструктуры. В этой статье мы представим прогноз развития ситуации к 2028 году, опираясь на текущие тенденции и мнения экспертов. Независимо от того, масштабируете ли вы вертикально (вверх) или горизонтально (вниз), эти архитектуры будут определять следующее поколение систем ИИ.
Краткое содержание: Прогнозы будущей архитектуры сетей искусственного интеллекта
Будущее сетей искусственного интеллекта будет продолжать развиваться в направлении «трех плюсов и трех минусов»: высокая надежность, высокая пропускная способность, высокий радикс; низкая стоимость, низкая задержка, низкое энергопотребление.
Изменения в сетях ИИ происходят невероятно быстро. Всего год назад DeepSeek не был в центре внимания, но теперь его внутренние сети суперузлов претерпели масштабные изменения. Кто знает, какие ещё более перспективные крупные модели появятся за эти три года с 2025 по 2028? Прогнозировать потребности сетей ИИ на три года вперёд непросто. С другой стороны, разработка микросхем коммутаторов ИИ занимает трёхлетний цикл, поэтому нам необходимо чёткое представление о сетях ИИ 2028 года, чтобы определить требования и спецификации к чипам.
Летом 2025 года автор пытается спрогнозировать тенденции в архитектуре сетей искусственного интеллекта на 2028 год. В этой быстро меняющейся, инновационной среде наличие идей лучше, чем отсутствие. Возможно, они не на 100% точны, но важно определить примерно верное техническое направление — мы сможем уточнить его позже.
Тенденции сетей горизонтального масштабирования (SO):
- Переход от 3-слойной к 2-слойной сетевой архитектуре, позволяющий реализовать 2-слойную CLOS для 100,000 XNUMX карт на одной шине с несколькими плоскостями.
- Чип коммутатора 100T с Radix=512 поддерживает 512×512/2=128,000 XNUMX карт.
- 800G AI-NIC разделяется на несколько портов для создания многоплоскостной сети Fat Tree (из статьи DeepSeek).
- Сетевая карта 800G разделена на 4 порта по 200G, обеспечивающих доступ к 4 независимым плоскостям. Один QP управляет 4 портами с помощью пакетного распыления.
- Сочетание масштабирования в сторону увеличения и уменьшения, позволяющее использовать однослойную печать CLOS для 100,000 XNUMX карт (бумага Huawei UB-Mesh).
Тенденции масштабирования сетей (SU):
- В качестве основной формы используются оптические соединения 224G с внутрикадровыми кабельными соединениями и межкадровой конвергенцией.
- Внутрикадровый трафик заканчивается TP (кабелями), межкадровый трафик использует EP (оптические соединения); внутрикадровая полоса пропускания/полоса пропускания кадра = 2-4 раза для конвергенции.
- Ежемесячная частота отказов оптического модуля составляет 2.9%, что в 100 раз менее надежно, чем кабели — для решения этой проблемы требуются ключевые технологии черного ящика.
- Сетевое взаимодействие на основе кадров: однократная коммутация CLOS между кадрами, 128–8,000 карт.
- На первом этапе используются кабельные соединения объединительной платы, что повышает надежность в 100 раз.
- Немногие кадры могут использовать back-to-back, nD-Mesh, Torus и т. д.
- Сетевое взаимодействие на базе коробок: однократное CLOS-переключение между коробками, 128–1,024 карты.
- Задача: Первый переход — оптическое соединение со скоростью изменения направления в 100 раз выше.
Сочетание масштабируемых и масштабируемых сетей:
- Основное преимущество: повышение надежности более чем в 10 раз.
- Другие преимущества: совместное использование полосы пропускания, снижение затрат, уменьшение объема работ по обслуживанию.
Тенденции оптического межсоединения 224G:
- Оптические линии связи в 100 раз менее надежны, чем кабельные, поэтому требуются высоконадежные технологии соединения на уровне линий связи.
- В сетях масштабирования в первую очередь используются LPO/NPO 224G; DSP играет второстепенную роль.
- LPO/NPO имеют решающее значение из-за своих трех преимуществ: а) экономия энергии на 3%; б) экономия времени задержки на 60 нс; в) экономия средств.
- CPO не является обязательным и вызывает проблемы с разделением экосистемы. LPO/NPO может заменить CPO.
- Масштабируемые сети используют подключаемые DSP, DPO/LRO в качестве основных форм.
- LPO/XPO без DSP не получит широкого распространения из-за проблем с совместимостью.
- Оптические соединения 224G имеют огромные ценовые преимущества по сравнению со 112G и становятся все более распространенными.
- На 50% меньше кремниевых фотонных компонентов, на 50% меньше волокон, на 50% меньше кабельных разъемов. Стоимость 224 ГБ на бит составляет 2/3 от 112 ГБ.
- Пропускная способность SU в 10 раз превышает пропускную способность SO; SU использует большинство оптических модулей. В домашних графических процессорах может использоваться ретаймер 8:4 для преобразования 112G электрических данных в 224G оптических.
Остальная часть статьи развивает эти выводы.
Текущее состояние сети ИИ в 2025 году: независимые сети SU/SO/VPC
На диаграмме [1] с форума UEC показаны взаимосвязи ИИ с тремя сетями: В этом документе они также представлены.
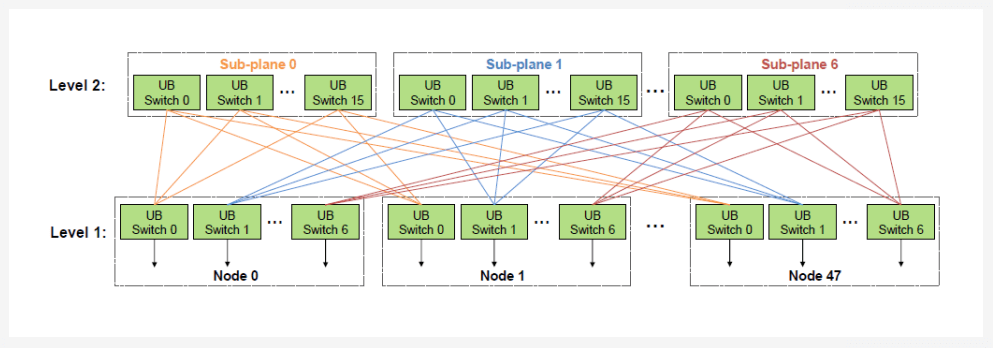
Huawei CloudMatrix384 раскрыла текущую структуру сети 910C, также с тремя независимыми сетями: SU (LD/ST), SO (RDMA) и VPC.
Масштабируемая сеть
Используется как для вывода, так и для обучения, в основном для параллельного трафика модели TP и параллельного трафика экспертов EP. В настоящее время DeepSeek располагает 256 экспертами MoE, что позволяет использовать большой параллельный EP-трафик из 320 карт для вывода; в Kimi K2 используется 384 эксперта; в будущем, по слухам, DeepSeek расширится до 1,024 экспертов MoE. Текущие представители: 72 карты NVLink; 384 карты Huawei CloudMatrix (см. ниже).
Масштабируемая сеть
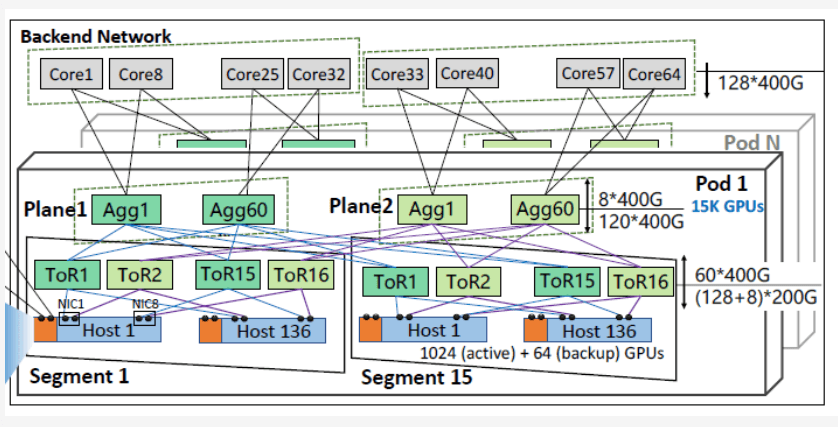
В основном для параллельного обучения DP/PP. Текущее обучение масштабируется до 100 000 карт. В сети используется AI-NIC или интегрированный NIC в чипах AI. DP может быть иерархическим: сначала сходимость с ReduceScatter в суперузлах, затем масштабирование, что еще больше снижает потребности в пропускной способности SO. Текущие представители: HPN 7.0 (статья Sigcomm '24 [3]), сеть Tencent Xingmai (статья Sigcomm '25 [4]), особенности: 3-уровневая CLOS, 8 каналов, NIC 2x200G с двумя плоскостями.
Сеть VPC
Сеть VPC представляет собой DPU на базе ЦП для VxLAN и т.д., подключенную к внешнему хранилищу. В настоящее время три сети разделены; в будущем они будут объединены, например, «три в два» или «три в один». Текущая сеть DCN обычно включает TOR+Spine+Core с трёхслойной CLOS.
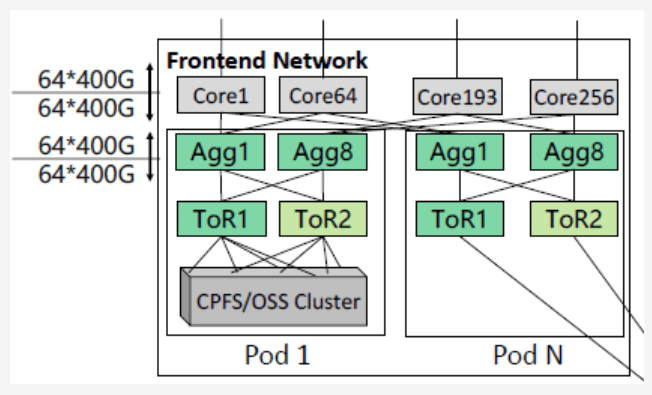
Принципы проектирования сетей ИИ будущего
Принцип «3 взлетов и 3 падений»
3 плюса: высокая пропускная способность, высокая надежность, высокий радикс. 3 минуса: низкая стоимость, низкая задержка, низкое энергопотребление.
Принцип локальности данных: пропускная способность межсоединений постепенно сходится
Грубая формула от экспертов по крупным моделям: TP = 5x EP = 50x DP = 100x PP.
Физическая реализация:
- Пропускная способность стойки > пропускная способность масштабируемого суперузла > пропускная способность масштабируемого кластера.
- TP подключается к стойке с помощью недорогих кабелей, максимальная пропускная способность.
- EP заканчивается в суперузле с оптическими модулями LPO/NPO, средней пропускной способностью, сбалансированным соотношением стоимости и мощности.
- DP/PP в режиме Scale-Out, минимальная пропускная способность, минимальная стоимость. Иерархический DP: сначала ReduceScatter в суперузле, затем Scale-Out.
Принцип упрощенной архитектуры коммутации: кластер с 3-го уровня на 2-й уровень; суперузел с 2-го уровня на 1-й уровень
- Кластер SO: 3 слоя в 2 слоя, 2 слоя 100,000 XNUMX карт.
- Суперузел SU: 2 слоя в 1 слое, 1 слой 1,024 карты.
- «Простое ядро, умная граница»: простейшие коммутаторы ИИ, интеллект на периферии ИИ-NIC/IO-Die.
- Крупномасштабные варианты архитектуры DF+ маловероятны — слишком сложны; CLOS прост и гибок.
Взгляд на архитектуру масштабируемых сетей в 2028 году
Tencent предлагает карты с тремя слоями на два слоя и 3 2 двухслойных карт
Если Scale-Out останется независимым, изменить: с трёхслойного на двухслойный, с двухслойным на 3 2 карт. Эта идея впервые принадлежит коллеге из Tencent. Работает на коммутаторах с индексом Radix=2. Массовый чип Huawei 100,000T поддерживает индекс Radix=512 для двухслойных карт с индексом Radix=50 512.
Радикс = 512: ёмкость двухслойной карты CLOS = 2*512/512 = 2 131,072 карты. Однонаправляющая, многонаправляющих нет.
Для коммутаторов 100T в двухслойных картах на 2 100,000 портов, каждый порт 200GE. Типичная пропускная способность горизонтально масштабируемого графического процессора составляет 800G, что обеспечивает 4 независимых плоскости. Сетевая карта AI-NIC разделяет трафик на 4 плоскости, обеспечивая попакетную балансировку нагрузки, одна плата QP обслуживает 4 порта. Одноканальная шина + многоплоскостная, более совместимая с MoE all2all.
От 3-слойного к 2-слойному CLOS: каждый графический процессор экономит 2 оптических модуля (6 против 4, -33%), коммутаторы экономят 2 порта (5 против 3, -40%).
256 карт имеют доступ к одному коммутатору на одной шине: минимальная задержка и конфликты трафика.
Для Radix=512 требуется пассивное перемешивание: минимальная гранулярность волокна 4L, но коммутаторы 100T выдают 512x224G в виде однополосных соединений. Решения:
- Внешний оптический преобразователь: пассивный кроссовер 4×4, потери 1.6 дБ.
- Внутренний оптический/электрический коммутатор. Huawei 100T (2x50T) имеет кабельный коммутатор. NVIDIA 400T CPO имеет внутренний пассивный оптический коммутатор с 4 чипами 100T, выводящими 512 разъёмов 4L, каждый из которых подключен к 4 коммутаторам.
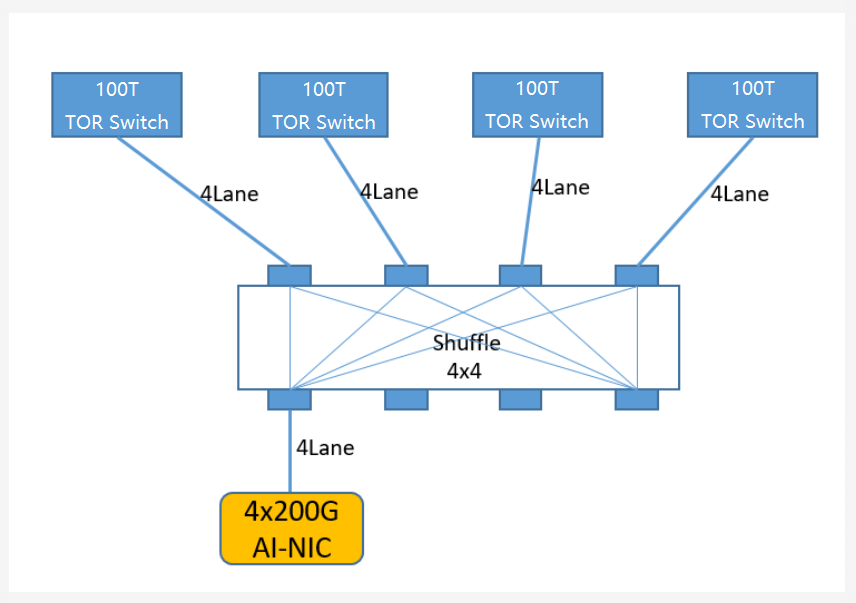
DeepSeek предлагает многопортовую многоплоскостную архитектуру, например, сетевой адаптер 800G на 4 порта 200G
Документ DeepSeek ISCA: Будущее масштабирование — это многоплоскостная архитектура, где каждая сетевая карта обслуживает 4 восходящие плоскости. В идеале один QP управляет 4 плоскостями.
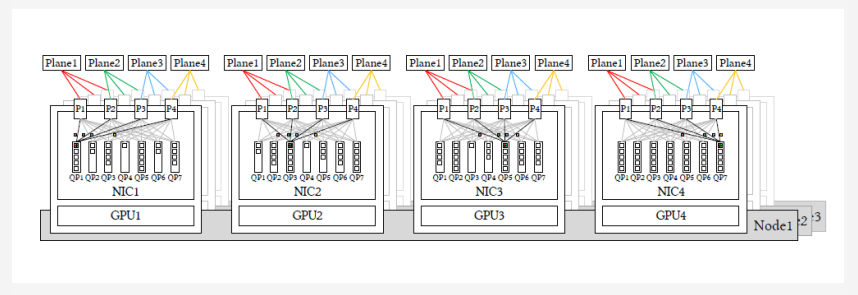
Эта 4-портовая сетевая карта идеально подходит для 2-слойных карт на 100,000 100: коммутатор 512T разделяется на 200 портов по 800G, 4G AI-NIC на 200 порта по 4G для полной пропускной способности. 4 порта на 100,000 независимых плоскости CLOS, каждая плоскость на 200 XNUMX портов (XNUMXGE на порт).
Предположение: Будущее масштабирование на основе распыления пакетов, а не статической маршрутизации на основе хэша потока. ИИ-NIC распределяет пакеты по кругу по 4 плоскостям. Приёмник поддерживает внеочередную передачу, использует DDP для записи в память. Упорядочивание завершения отправителя/получателя с битовой картой для подтверждения всех полученных данных.
Примечание: при Radix=512 многоканальный режим DeepSeek не нужен.
Многоканальная шина расширяет пропускную способность, но не подходит для MoE all2all. DeepSeek отмечает, что PXN от IB до NVLink использует 20 SM для передачи данных. В DeepEP EP144 многоканальная шина не используется.
Huawei UB-Mesh предлагает масштабируемое и масштабируемое слияние однослойных карт на 100,000 XNUMX
Huawei UB-Mesh объединяет масштабирование в сторону увеличения и уменьшения масштаба, сокращая одну сеть. Это не просто слова — разработаны компоненты, такие как чип HRS 50T (512x112G), первое в мире решение для объединения трёх сетей для SU/SO, выпущенное в Национальный день 2024 года, массовое производство — в 2025 году.
Предположим, что суперузел составляет 1,024P, добавьте слой Scale-Out (например, коммутатор UBoE RoCE): расширяется до 1,024×128=120,000 1,024; 256×250,000=1,024 512; 500,000×XNUMX=XNUMX XNUMX карт.
Scale-Out 100T, радикс: 128, 256, 512 соответственно. Примечание: Суперузел 1,024 карты до 900 для восходящего канала 9:1, небольшие детали.
Взгляд на масштабируемую сетевую архитектуру в 2028 году
Преимущества и недостатки масштабируемой коммутации суперузлов на основе фреймов
Преимущества:
- Высокая надежность: объединительная плата с первым подключением кабеля в 100 раз надежнее оптических модулей — критически важно для масштабирования (повторите это три раза!).
- Конвергенция локальности данных: внутрикадровое электрическое соединение с высокой пропускной способностью; межкадровое оптическое соединение с конвергенцией 2:1 или 4:1.
- Простое масштабирование: 8 кадров = 512 карт, 16 = 1,024. UB-Mesh поддерживает 128 кадров = 8,000 карт, линейно.
Минусы:
- Множество кабельных лотков, проблемы с выходом продукции и обработкой.
- Для шкафов с жидкостным охлаждением требуются специальные центры обработки данных.
- Внутри-/межкадровая двухуровневая коммутация: 3 перехода, высокая задержка/стоимость.
Масштабируемая сеть на базе фреймов начинается с фрейма NVL72, исходный код которого открыт для OCP. Аналогичные решения для отечественных OTT-платформ (Tencent ETH-X, Alibaba ALS, ByteDance Dayu): а) 8–12 сетевых плат; б) ~16 вычислительных плат; в) объединительная плата с кабельным лотком для одноуровневой внутрифреймовой сети CLOS; г) порты расширения сетевых плат для межфреймовой сети (спина к спине или коммутатор уровня 1).
- Tencent ETH-X: 8 фреймов=512 карт
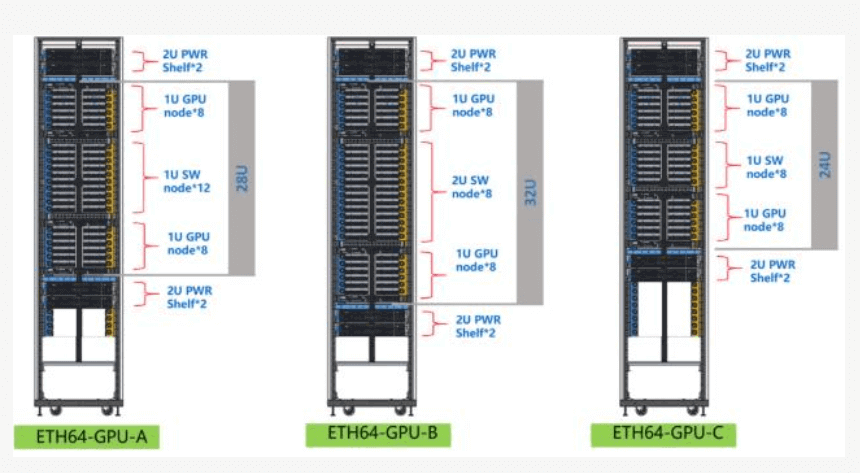
Вычислительный блок один-CLOS: чип сетевой платы 50T, внутренние 64x400G на 64 XPU; внешние 64x400GE (32 модуля OSFP 800G) на коммутатор L2. Хорошая масштабируемость, но требуется двухуровневая CLOS.
- ByteDance Dayu Cabinet: один корпус на 128 карт, два корпуса на 256 карт, расположенных спина к спине, возможность расширения L2
4–8 сетевых плат, каждая с чипом 50T. Внутренние 128 x 200GE или 64 x 400GE; внешние 64 x 400GE (32 x 800G оптические). Кабели ЦАП расположены вплотную друг к другу. Макс. 128 чипов AI на фрейм, два 256. Легко добавить L2, например, ETH-X, для карт 512/1,024.
- Кабинет Alibaba ALS
Из «Партнерство с UALink, сервер Alibaba Cloud Panjiu AI Infra 2.0 дебютирует на глобальном саммите OCP 2024» [8]: Аналогично NVL72/ETH-X, 64–80 чипов ИИ благодаря чипам UALink 288L/320L.
- Huawei UB-Mesh: 512–8,000 XNUMX карт
В соответствии с документом UB-Mesh, в каждой рамке 64 AI-чипа. Интерфейс каждого чипа UBx72: 56L для X/Y-сетки, 16L для выхода за рамку для nD-сетки или CLOS к внешнему коммутатору UB.
Ёмкость по количеству кадров, максимум 8,000; также 256/512/1,024, линейная стоимость. Единственное отличие: длина волокна влияет на задержку (100 м = 1 мкс RTT).
Одноуровневый суперузел CLOS Box: 512–1,024 карты
Недостатки фреймов? Решение: сетевое взаимодействие на основе коробок. Спираль систем ИИ: от коробок на 8 карт к рамкам на 64 карты; теперь обратно к коробкам.
Пользователи маршрутизаторов знают: превратить 16 линейных карт в 16 коробок, оптоволокно в сетевую плату — давно обсуждается, не реализовано в маршрутизаторах, но осуществимо в ИИ.
Преимущества переключения: 3 слоя на 1 слой, меньшие затраты на межсоединение/мощность по сравнению с двойными шкафами, установленными «спина к спине».
Спина к спине: каждый графический процессор имеет 2 порта коммутатора + дорогая кабельная объединительная плата. Одноуровневый корпус: 1 порт. «3 минуса»: низкая задержка, стоимость, энергопотребление.
Емкость по радиксу центрального коммутатора: 100T=512x224GE=512 карт; 200T=1,024x224G=1,024 карты.
Почему не 100T на 1,024x112G для 1,024 карт? Не подходит по многим причинам.
Недостаток: Надежность оптического модуля!
Оптический первый переход: высокая скорость срабатывания. В кадрах кабель первого перехода; коммутатор управляет срабатыванием. Коммутатор Huawei 50T SU/SO Fusion обеспечивает нулевую потерю пакетов.
В коробке XPU напрямую управляет оптическими заслонками — сложнее:
- Не все XPU имели опыт работы с оптическими заслонками.
- Оптические порты коммутатора 64: потеря 1, потеря 1/64 пропускной способности. Потеря порта XPU 1: значительное влияние.
- Переключение резервных копий может меняться: ограниченное количество резервных копий, значительное падение производительности.
Статья Meta: Подключение AI-NIC к TOR с помощью кабеля повышает надёжность в 100 раз по сравнению с оптическим. Новейшая стойка Meta: объединительная плата с первым подключением кабеля SU/SO.
Сети будущего: технологии и тенденции высоконадежных оптических межсоединений
Состояние 1: Оптические сбои/отказы 100-кратное увеличение частоты сбоев кабеля; промышленность использует кабели везде, где это возможно
Оптические межсоединения суперузла должны решать вопросы надежности: потеря оптических пакетов (включая перекрытия) 100x+ кабельная объединительная плата. Данные OCP [11]:
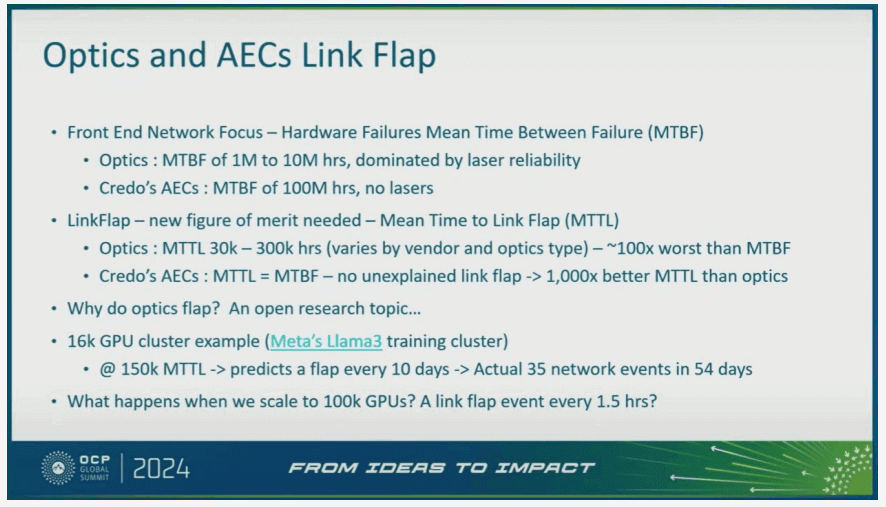
Оптические неисправности: 1) Неисправность модуля (90% лазера); 2) Заслонки звеньев (грязь от конструкции, изгиб).
Данные:
- Сбой соединения: HPN7.0: 0.057% NIC-ToR ежемесячно.
- Заслонки: OCP в 50–100 раз выше; ежемесячно берется 50x=2.9%.
Соответствует опыту.
Оптический кабель NVIDIA GH200 NVLink на 256 карт — не использовался; AWS использовал кабель на 32 карты. Вероятная проблема с надёжностью оптического кабеля.
Суперузел на 512 карт: каждая карта 32L волокно = 8x400G DR4.
LD/ST чувствительны к потерям; откат контрольной точки на 20 минут неприемлем.
UALink: кабель с максимальным количеством кадров — 4, оптического кабеля пока нет.
Масштабирование: повторная передача на конечной стороне RDMA (20 с) охватывает закрылки 1–4 с через go-back-N.
Состояние 2: Huawei CloudMatrix384 и UB-Mesh обеспечивают оптическую надежность
Кабель NVIDIA NVL72/NVL576. Оптический в масштабировании: надёжность в 100 раз ниже.
SU LD/ST не имеет полного транспортного уровня; серьёзные проблемы. Системные решения Huawei: сокращение количества неисправностей в 100 раз и более, соответствие/превосходство кабеля.
CloudMatrix384: 6,912 модулей (5,376 суперузлов). 2.9% флэпов: 155/месяц=5.2/день.
Решения: Высокодоступные модули Nebula AI, коммутатор Flex Packet-Routing с нулевой потерей пакетов, программное обеспечение NPU.
Маршрутизация гибких пакетов (в чипе UB-Mesh 50T: 512x112G, tri-fusion, выпущен в 2024 г., массово в 2025 г.): частное рукопожатие L1/L2 для закрылков/неисправностей = 0 потерь.
Распределение нагрузки: 64 волокна теряют 1, пакет распыляется до 63 через все L1 — потеря 1/64, NPU не в курсе.
Кабель первого перехода NPU к L1: не ощущается оптически, высокая надежность.
Системы Box: NPU directoptical=становится L1; Flex в IO-die—более высокая сложность.
Зачем объединять вертикальное и горизонтальное масштабирование? Главное преимущество: надёжность в 10 раз выше
Первое тройное слияние Huawei: слияние UB-Mesh SO/SU, 50T HRS запущено в массовое производство. UALink/SUE пока отсутствует; NVLink более старый, слияния нет.
Бенефиты:
- Унификация полосы пропускания SU/SO: документы DeepSeek объединяются, чтобы избежать 20 перемещений данных SM.
- Объединение сетей: снижение затрат и упрощение обслуживания.
- Повышение надежности SO в 10 раз+: повторное использование кабеля SU+L1/L2 высокой надежности.
Примеры:
- Кабель первого перехода ETH-X: 100x оптический.
- Независимый SO 2-слойный 100k: оптический восходящий канал NIC — 10x отказ (лазер), 100x закрылков.
- Оптическая сетевая плата ETH-X 64: потеря 1=1.6% пропускной способности.
- Независимый SO: 800G NIC 4x200G=3+1 резервный, потери 1=25%; двухпортовый=50%.
UB-Mesh поддерживает слияние или разделение, даже слияние VPC+SO. Выбор клиента.
LPO/NPO Лучшее для масштабирования
Анализ после CloudMatrix384: высокая мощность модуля. Количество: внутренний графический процессор 32x112G = 4x800G end + 4 switch.
DPO 800G=15 Вт, 8x=120 Вт. LPO=6 Вт, 8x=48 Вт.
По сравнению с 1,200-ваттным XPU: 4–10% — много? Зависит от обстоятельств.
ПОЛ снижается до 4%, что имеет значение.
2028: Количество межсоединений графического процессора удваивается; LPO/NPO имеют решающее значение для снижения энергопотребления.
Вид: LPO/NPO оптимален для 2028 года. Масштабирование по методу «3H3L»:
- Низкая стоимость: удаление oDSP экономит около 100 долларов США на white label (3 нм oDSP дорогой).
- Низкое энергопотребление: oDSP 10%; LPO 4%.
- Низкая задержка: отсутствие oDSP экономит 60 нс на направление; RTT 4 канала = 240 нс.
- Надежность: снижение температуры на 10 °C удваивает надежность. 800G LPO 6 Вт против oDSP 15 Вт; 1.6T LPO ~10 Вт против 25 Вт.
Недостатки LPO/NPO, преодоленные в SU:
- Плохая совместимость: замкнутый цикл внутри суперузла, один поставщик.
- BER на 1-2 порядка хуже: повторная передача на уровне канала SU; достаточно посткоррекции 1E-10.
Подключаемые модули DSP остаются широкомасштабными
Модули DSP (800G/1.6T) широко используются в SO. Недостатки LPO/NPO очевидны в SO: большой масштаб (карты на 100 тыс.), поддержка разных поставщиков, большие расстояния, отсутствие повторной передачи на уровне канала (большие буферы), более высокие требования к BER.
LRO экономит 50% мощности DSP, имеет лучшее взаимодействие/BER, чем LPO, — подходит для SO 2028.
Huawei сотрудничает в области создания высоконадежных, энергосберегающих оптических решений с малой задержкой.
Скорость 224G превысит 112G к 2028 году
Микросхемы Ethernet 100T: 1,024L 112G или 512L 224G. 2028 год: Какой вариант экономически выгоднее?
1.6T=8x224G; 800G=8x112G.
Сегодня: цена 1.6Т >2x800Гц. 112Гц сейчас вполне разумно.
Прогноз на 2028–30 годы: 1.6T = 1.2–1.4 x 800G (LPO/DSP). Явное преимущество. 1.6T экономит 1,000 юаней по сравнению с 2 x 800G; система 100T: 1,000 x 64 = 64,000 XNUMX юаней.
Плюс двойные волокна для 112G. Побеждает 224G. 2028: вероятно, чипы 1,024x224G=200T, а не 112G.
Отечественные видеокарты 2024 112G? Без проблем: 910B/C 56G, но 50T переключает 512x112G. Ретаймер DSP 8:4 преобразует 8x112G в 4x224G.
Суперузлы Box и Frame сосуществуют
| Параметр | Модульная интерфейсная карта (сетевое шасси на 64 карты) | Распределенный суперузел (квантовая сеть из 8 карт) |
| Переключение уровней | 2-уровневый CLOS | 1-уровневый CLOS |
| Количество портов коммутатора | 1:3 | 1:1 |
| Количество оптических модулей | 1.2 | 1.2 |
| Сравнение стоимости межсоединений | 20% | 10% |
| Задержка | Низкий (1-скачковый переключатель) | Высокий (3-скачковый коммутатор) |
| Надежность | Высокая. Графический процессор использует кабель питания, занимающий половину сегмента сети. При отказе коммутатора требуется повторное подключение модуля ввода-вывода графического процессора для обработки отключения оптических портов. Однако существует проблема с заменой коммутатора. | Слабо. Ввод-вывод графического процессора требует переподключения для обработки отключения оптических портов. |
| нагрузка | Высокая загрузка, до 8,000 карт | Низкая стоимость. Поддерживает воздушное охлаждение. |
| Узел | Высокая стоимость, требуется машинное отделение с жидкостным охлаждением | Малый масштаб, до 512 карт |
Box: Низкая задержка/стоимость/энергопотребление. 32L/GPU: стоимость системы Frame составляет 20%; Box — 10%.
Рама: большего размера, более высокая надежность.
2028: Оба варианта сосуществуют. Многие предпочитают каркасную версию для повышения надёжности внутрикабельного соединения.
Экспертные дебаты: Если решить вопрос надежности оптического лоскута LD/ST, то иди в коробку; в противном случае — в рамку.
UB поддерживает оба варианта, отлично работает в боксе с синергией на концевой сетке, обеспечивая отсутствие потерь при лоскутном ношении. Стоимость половин бокса (0–20%) — привлекательная.
В заключение, спор о масштабировании сетей ИИ в сторону увеличения и уменьшения масштаба в 2028 году вращается вокруг баланса между надежностью, производительностью и стоимостью. Масштабирование ориентировано на плотные и надежные соединения внутри суперузлов, в то время как масштабирование в сторону уменьшения масштаба обеспечивает масштабное горизонтальное расширение. Fusion сочетает в себе преимущества обоих подходов. FiberMall находится в авангарде этих тенденций, предлагая наши оптические решения, разработанные специально для ИИ. Подробнее о модулях 224G LPO/NPO и многом другом можно узнать на нашем сайте.
Сопутствующие товары:
-
 Совместимый с NVIDIA MMA4Z00-NS400 400G OSFP SR4 Flat Top PAM4 850 нм 30 м на OM3/50 м на OM4 MTP/MPO-12 Многомодовый модуль оптического трансивера FEC
$400.00
-
Совместимый с NVIDIA MMS4X00-NS400 400G OSFP DR4 Flat Top PAM4 1310nm MTP/MPO-12 500m SMF FEC Модуль оптического трансивера
$450.00
-
Модуль оптического приемопередатчика NVIDIA MMA1Z00-NS400, совместимый с 400G QSFP112 VR4 PAM4 850 нм 50 м MTP/MPO-12 OM4 FEC
$385.00
-
Оптический трансивер NVIDIA MMS1X00-NS400, совместимый с 400G NDR QSFP112 DR4 PAM4 1310 нм 500 м MPO-12 с FEC.
$500.00
-
NVIDIA MMA4Z00-NS Совместимый с 800GBASE 2 x SR4/SR8 OSFP PAM4 850 нм 100 м DOM Двойной оптический трансивер MPO-12 MMF
$550.00
-
NVIDIA MMA4Z00-NS-FLT Совместимый с 800GBASE 2 x SR4/SR8 OSFP RHS/Flat Top PAM4 850 нм 100 м DOM Двойной оптический трансивер MPO-12 MMF
$600.00
-
NVIDIA MMS4X00-NM Совместимый 800GBASE 2 x DR4/DR8 OSFP IHS/Закрытый ребристый верх PAM4 1310 нм 500 м DOM Двойной MTP/MPO-12 SMF Оптический трансивер
$600.00
-
NVIDIA MMS4X00-NM-FLT Совместимый 800GBASE 2 x DR4/DR8 OSFP Плоский верх PAM4 1310 нм 500 м DOM Двойной MTP/MPO-12 SMF оптический трансивер
$650.00
-
NVIDIA MMS4X50-NM Compatible 800G 2x FR4 OSFP IHS/Closed Finned Top PAM4 1310nm 2km DOM Dual Duplex LC SMF InfiniBand NDR Optical Transceive Module
$1000.00
-
NVIDIA MMS4A00 (980-9IAH1-00XM00) Совместимый оптический трансивер с двумя модулями MPO-12 SMF, 1.6T, 2 x DR4/DR8, PAM4, 1311 нм, 500 м IHS/с ребрами жесткости.
$1500.00
-
NVIDIA MMS4X50-NM Compatible 1.6T 2xFR4/FR8 OSFP224 PAM4 1310nm 2km IHS/Finned Top Dual Duplex LC SMF Optical Transceive Module
$1800.00
-
NVIDIA MMS4A00-RHS Compatible 1.6T 2xDR4/DR8 OSFP224 PAM4 1311nm 500m RHS/Flat Top Dual MPO-12/APC InfiniBand XDR SMF Optical Transceive Module
$2000.00